Flink系统知识之:如何识别反压的源头
什么是反压
Ufuk Celebi 在一篇古老但仍然准确的文章中对此做了很好的解释。如果您不熟悉这个概念,强烈推荐您阅读这篇文章。如果想更深入、更低层次地了解该主题以及 Flink 网络协议栈的工作原理,这里有更高级的解释。
在更高层次上,如果Flink作业图中的某些操作符算子无法以与接收记录相同的速度处理记录,就会产生反压。这就会填满运行较慢操作符的子任务的输入缓冲区。一旦输入缓冲区满了,反压就会传播到上游子任务的输出缓冲区。一旦这些缓冲区被填满,上游子任务也会被迫降低其处理记录的速度,以匹配造成瓶颈的操作符的处理速度。反压会进一步向上传播,直至到达source操作符。
只要负载和可用资源是静态的,并且没有操作符产生短时间的数据(如窗口操作符),这些输入/输出缓冲区就只会处于两种状态之一:几乎空或几乎满。如果下游操作符或子任务能够跟上数据流入的速度,缓冲区就会是空的。否则,缓冲区就会满1。事实上,检查缓冲区的使用指标正是几年前 Nico Kruber 推荐的检测和分析背压方法的基础。正如我在开头提到的,Flink 现在提供了更好的工具来完成同样的工作,但在此之前,有两个问题值得一问。
为什么要关注反压
反压是机器或操作符超负荷工作的指标。反压的积累会直接影响Flink系统的端到端延迟,因为记录在队列中等待的时间会更长,然后才会被处理。其次,在反压情况下,Checkpoint对齐的时间会更长,而非对齐Checkpoint的大小会更大(阻塞在输入/输出队列的数据会更多)(有关对齐和未对齐Checkpoint的更多信息,请参阅文档)。如果你正在为checkpoint barrier的传播时间而苦恼,考虑反压的存在很可能有助于解决问题。
为了解决作业的某些性能问题,我们需要意识到反压这个问题,然后对其进行定位和分析。
为什么不该关心反压
坦率地说,您不必总是关心是否存在反压。从定义上讲,缺乏反压可能意味着您的Flink作业至少存在轻微的利用不足和超额配置。如果想尽量减少闲置资源,可能会无法避免的产生一些反向压力。这对于批处理来说尤其如此。
如何检测和追踪反压的源头
检测反压的一种方法是使用Flink提供的Metrics,但在 Flink 1.13 中,不再需要如此深入地挖掘这些指标。因为在大多数情况下,只需查看 Web UI 中的作业图即可。

在上面的示例图中,首先要注意的是不同的任务有不同的颜色。这些颜色代表两个因素的组合:任务的反压程度和繁忙程度。空闲的任务为蓝色,完全繁忙的任务为红色,完全反压的任务为黑色。介于两者之间的任务将是这三种颜色的组合。
有了这些知识,我们就能很容易地发现反压任务(黑色)。反压任务下游最繁忙的任务(红色)很可能就是反压的来源(瓶颈)。
如果单击某项任务并进入 "BackPressure "选项卡,就可以进一步分析每个子任务的问题,查看该任务中每个子任务的反压/闲置状态。例如,通过该选项卡可以方便地发现如果任务存在数据倾斜,而且并非所有子任务的利用率都相同的情况:

在上面的示例中,我们可以清楚地看到哪些子任务处于空闲状态,哪些子任务处于反压状态,而且没有一个子任务处于忙碌状态。坦率地说,这足以让我们快速了解Flink应用发生了什么。不过,还有一些细节值得解释。
这些数值表示什么?
如果你对它的工作原理感到好奇,我们可以深入了解一下。我们有三个新指标,每个子任务都会显示和计算这三个指标:
- idleTimeMsPerSecond
- busyTimeMsPerSecond
- backPressuredTimeMsPerSecond
这些指标分别测量每秒内子任务空闲、忙碌或反向压力所花费的平均时间(以毫秒为单位)。除了一些舍入误差外,它们应该相互补充,加起来达到1000ms/s。从本质上讲,它们与CPU使用指标非常相似。
另一个重要细节是,它们是在短时间内(几秒钟)的平均值,并考虑了子任务线程内发生的一切:操作符、函数、定时器、检查点、记录序列化/反序列化、网络堆栈和其他 Flink 内部开销。如果 一个WindowOperator 算子忙于触发定时器并产生结果,则会被报告为繁忙或反压。在 CheckpointedFunction#snapshotState 调用中进行的昂贵计算(例如刷新内部缓冲区)也会被报告为繁忙。
但有一个局限性,即 busyTimeMsPerSecond 和 idleTimeMsPerSecond 指标对子任务执行主线程之外的独立线程中发生的任何事情都是视而不见的。不过,这只与两种情况有关:
- 在操作符中手动生成的自定义线程(不鼓励这种做法)。
- 实现已废弃 SourceFunction 接口的旧式数据源。此类数据源会将 NaN/N/A 报告为 busyTimeMsPerSecond 的值。
为了在 Web UI 中显示这些原始指标数据,需要汇总所有子任务的这些指标(在Job Graph中,只会显示Task)。这就是为什么Web UI会显示给定任务的所有子任务的最大值,以及为什么繁忙和反压的最大值加起来可能不是 100%。一个子任务的反压可能是 60%,而另一个子任务的繁忙可能是 60%。这可能导致一个任务既有 60% 的反压,又有 60% 的繁忙度。
负载变化
另外,由于这些指标是在几秒钟内计算得到的平均值,因此在分析具有不同负载的作业或任务时,例如包含周期性触发的WindowOperator的(子)任务,负载恒定为 50% 的子任务和每秒在完全繁忙和完全闲置之间交替的子任务都将报告相同的 busyTimeMsPerSecond 值(500ms/s)。
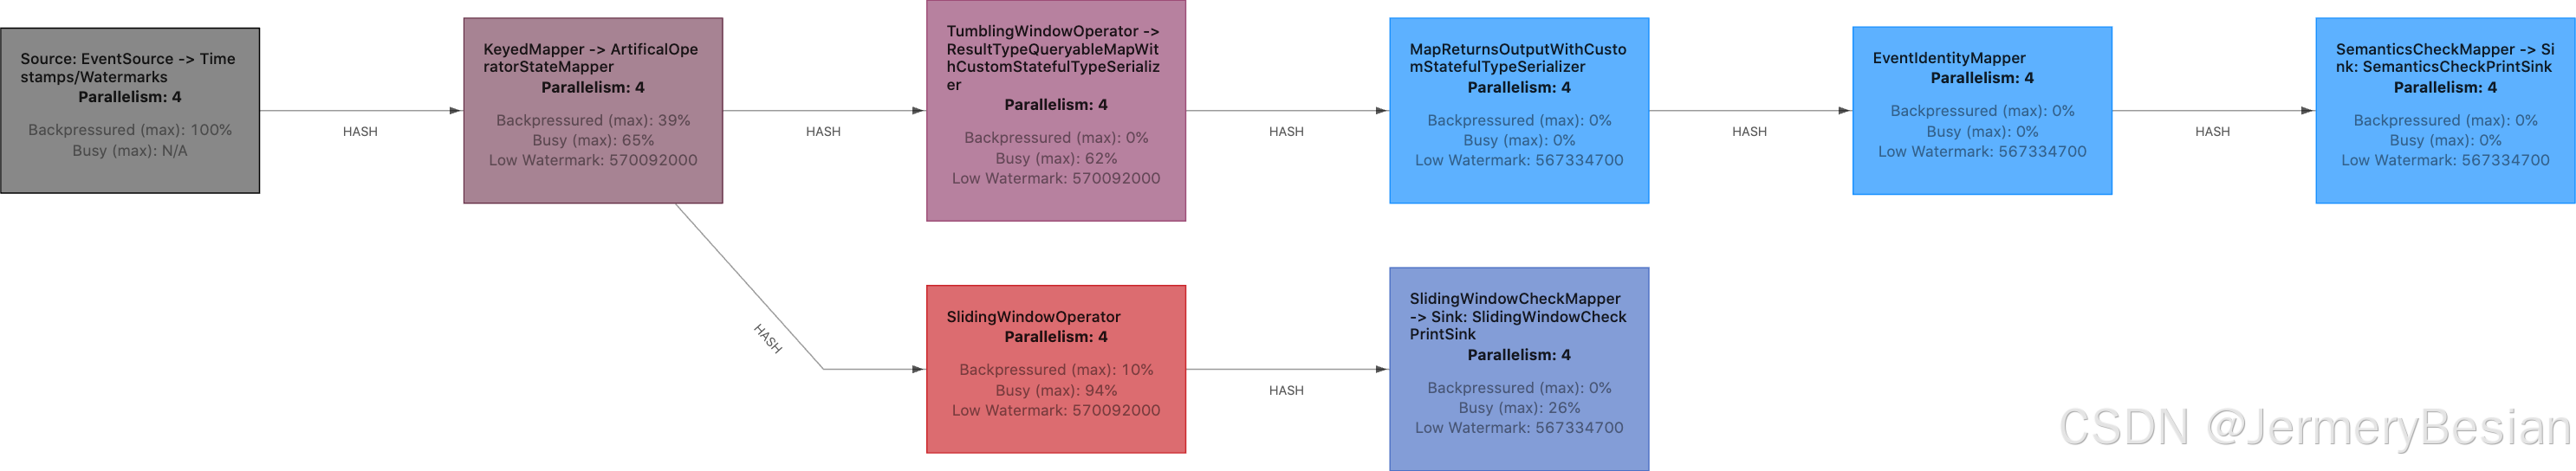
此外,不同的负载,尤其是类似窗口操作,会将瓶颈转移到作业图中的不同位置:

两项任务交替出现的瓶颈:

在这个特定的示例中,只要 SlidingWindowOperator 还在累积记录,它就是瓶颈。但是,一旦它开始启动窗口(每 10 秒一次),下游任务 SlidingWindowCheckMapper -> Sink:SlidingWindowCheckPrintSink 就会成为瓶颈,同时,SlidingWindowOperator 就会被反压。由于这些繁忙/反压/闲置指标是几秒钟内的平均时间,因此这一微妙变化无法立即显现。此外,Web UI每 10 秒钟才更新一次状态,这也使得发现更频繁的变化变得比较困难。
遇到反压能做什么?
总的来说,这是一个复杂的话题,值得专门撰写一篇博文。简而言之,处理反压有两种方法:要么增加更多资源(更多机器、更快的 CPU、更多内存、更好的网络、使用固态硬盘...),要么优化现有资源的使用(优化代码、调整配置、避免数据倾斜)。无论是哪种情况,首先都需要分析造成反压的原因:
- 分析出反压的存在。
- 确定是哪个子任务或哪台机器造成的。
- 深入挖掘代码的哪个部分导致了问题的出现,以及哪个资源是稀缺的。
反压监控指标可以帮助您解决前两点问题。要解决最后一个问题,则需要对代码进行剖析。从 Flink 1.13 开始,Flame Graphs 集成到了 Flink 的 Web UI中,为剖析提供了帮助。Flame Graphs 是一种剖析工具和可视化技术,有兴趣的可以试一试。
但请记住,在找到瓶颈所在后,可以像分析其他非分布式应用程序一样对其进行分析(通过检查资源利用率、使用Code Profiler等)。通常情况下,解决此类问题没有灵丹妙药。您可以尝试扩大规模,但有时这样做并不容易,也不现实。
总之,上述对反压监控的改进让我们可以轻松检测到反压的来源,而 Flame Graphs 则可以帮助我们分析特定子任务导致问题的原因。这两项功能结合在一起,将使以前相当乏味的 Flink 作业调试和性能分析过程变得更加轻松!请升级到 Flink 1.13.x 并试用它们!