Hive配置JDBC连接

Hive搭建完成后 可以配置JDBC连接

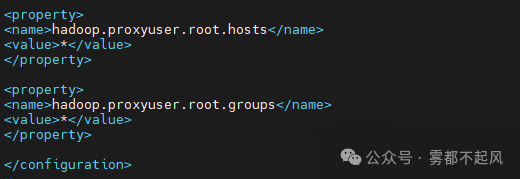
1.修改Hadoop配置文件

复制代码
cd /usr/local/soft/hadoop-2.7.6/etc/hadoopvim core-site.xml添加<property><name>hadoop.proxyuser.root.hosts</name><value>*</value></property><property><name>hadoop.proxyuser.root.groups</name><value>*</value></property>
2.启动Hive的JDBC连接

复制代码
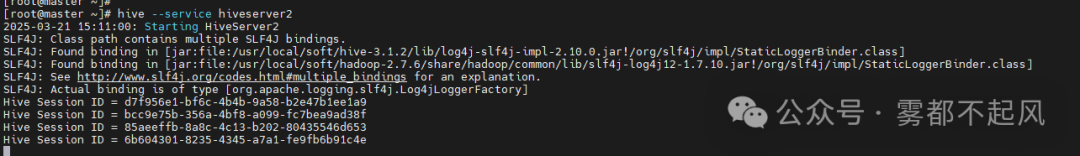
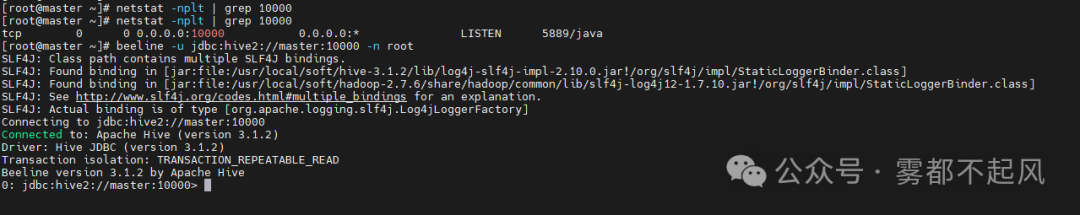
start-all.shzkServer.sh start (三台机器)master启动hiveserver2hive --service hiveserver2查看进程 netstat -nplt | grep 10000HIVE连接JDBCbeeline -u jdbc:hive2://master:10000 -n root
相关推荐
上海潭龙东海科技有限公司23 分钟前
客运站管控之动态孪生技术方案(新增一屏管控模块
数据仓库·人工智能·算法·重构·动态规划
freejackman4 天前
【工程化】从“单兵作战”到“多引擎架构”:基于门面模式的重构实战
大数据·数据库·hive·sql·测试工具·设计模式·架构
skywalk81637 天前
hive 常驻集群:像 OSPF 一样在线,像 git 一样可信
运维·人工智能·hive
Francek Chen8 天前
【大数据处理与分析】数据仓库Hive:09 Hive 编程实践
大数据·数据仓库·hive·hadoop·sql
茶海棠11 天前
Hadoop+zookeeper+HBase+Kafka集群搭建全流程
hadoop·zookeeper·kafka·hbase
全栈陈序员11 天前
【Git】从入门到精通(二)—— Git安装与初次配置
数据仓库·git
skywalk816311 天前
卡不等于分支:我用 TRAE 宝配合 Hive 跑三张任务卡的一天
运维·人工智能·hive·trae
程序员梅雨11 天前
【从零开始学习数据仓库 | 第三篇】: Flume——数据采集基石
java·大数据·数据仓库·后端·学习·flume
freejackman12 天前
【架构篇】双遍历 + 多栈协同:手撸 SQL 血缘引擎的架构思考
java·大数据·数据库·hive·sql·架构·spark
陈年老古董12 天前
ClickHouse 单机搭建记录
hive·笔记·学习·clickhouse·硬件架构