python
import asyncio
import pyaudio
import wave
import gc
import io
import zhconv
import torch
import copy
from faster_whisper import WhisperModel


class MicroPhoneTransWords(object):
    def __init__(self):
        self.format = pyaudio.paInt16
        self.channels = 1
        self.rate = 44100  # 采样率
        self.chunck = 1024  # 每帧大小
        self.recode_seconds = 5 # 处理间隔
        self.p = pyaudio.PyAudio()
        self.stream = self.p.open(format=self.format,
                                  channels=self.channels,
                                  rate=self.rate,
                                  input=True,
                                  frames_per_buffer=self.chunck)
        self.model_size = "./modelscape/faster-whisper-medium"
        self.model = WhisperModel(self.model_size, device="cuda", num_workers=1, compute_type="float32")

    async def recode_listen(self):
        print("开始录音")
        frames = []
        try:
            for _ in range(0, int(self.rate / self.chunck * self.recode_seconds)):
                data = self.stream.read(self.chunck, exception_on_overflow=False)
                frames.append(data)
        except OSError as e:
            print(f"录音时发生错误:{e}")
            # 如果流出错,可以尝试重新打开
            self.reopen_stream()
            return  # 出错时返回,下一次循环录音
        print("录音完成")
        # 异步启动转写任务
        await self.recode_voices(copy.copy(frames))
        await asyncio.sleep(0.0001)

    def reopen_stream(self):
        print("重启音频流......")
        try:
            self.stream.stop_stream()
            self.stream.close()
        except Exception:
            pass
        try:
            self.p.terminate()
        except Exception:
            pass
        self.p = pyaudio.PyAudio()
        self.stream = self.p.open(format=self.format,
                                  channels=self.channels,
                                  rate=self.rate,
                                  input=True,
                                  frames_per_buffer=self.chunck)

    async def recode_voices(self, frames):
        """

        :param frames:
        :return:
        """
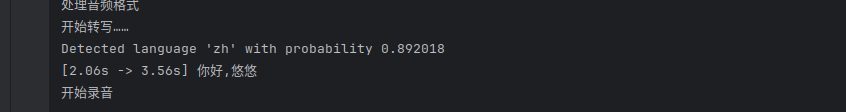
        print("处理音频格式")
        buffer = io.BytesIO()
        wf = wave.open(buffer, 'wb')
        wf.setnchannels(self.channels)
        wf.setsampwidth(self.p.get_sample_size(self.format))
        wf.setframerate(self.rate)
        wf.writeframes(b''.join(frames))
        wf.close()
        buffer.seek(0)
        await self.transAudioWords(buffer)

    async def listen(self):
        while True:
            print("Listening...")
            try:
                while True:
                    await self.recode_listen()
            except Exception as e:
                print("录音终止", e)
                gc.collect()
                torch.cuda.empty_cache()

    async def tranSampleChinese(self, word):
        locale = "zh-hans"
        return zhconv.convert(word, locale)

    async def transAudioWords(self, buffer):
        print("开始转写......")
        segments, info = self.model.transcribe(buffer, beam_size=5,
                                               condition_on_previous_text=False,
                                               vad_filter=True,
                                               vad_parameters=dict(min_silence_duration_ms=1000))
        print("Detected language '%s' with probability %f" % (info.language, info.language_probability))
        for segment in segments:
            text = await self.tranSampleChinese(segment.text)
            print("[%.2fs -> %.2fs] %s" % (segment.start, segment.end, text))
        # 释放空间 防止cuda 内存溢出
        gc.collect()
        torch.cuda.empty_cache()


if __name__ == '__main__':
    asyncio.run(MicroPhoneTransWords().listen())
requirements.txt
torch==2.2.2
torchvision==0.17.2
torchaudio==2.2.2
faster-whisper
gradio
pybind11>=2.12
numpy<2
SpeechRecognition
PyAudio # sudo apt update && sudo apt install ffmpeg portaudio19-dev python3-pyaudio -y
whisper-live
zhconv==1.4.3