00 引言
在高并发应用中,频繁的小块内存申请与释放不仅会带来性能瓶颈,还容易导致内存碎片问题。为此,内存池技术应运而生,而 tcmalloc(Thread-Caching Malloc)作为 Google 开源的高性能内存分配器,是学习与借鉴的优秀模板。本文将以简化版 tcmalloc 为目标,从零手把手带你构建一个支持多线程的高性能内存池。
本项目将涉及到C/C++、数据结构(如链表、哈希桶)、操作系统内存管理、单例模式、多线程、互斥锁等技术。如果你对这些概念还不熟悉,建议先学习这些相关知识,确保理解这些基础知识后再深入本篇内容。
项目源代码地址:https://github.com/Kutbas/ConcurrentMemory
01 内存池技术概览
池化技术是一种资源管理策略,它的基本思想是程序预先申请超出当前需求的资源,然后自主管理这些资源,以备未来使用。
那么,什么是"超出需求的资源"呢?简单来说,就是那些当前不立即使用,但可以储备以备将来使用的资源。
让我们通过一个日常生活的例子来理解这个概念。
txt
想象你住在宿舍楼,楼道里有饮水机。假如你只有一个杯子,每次想喝水都得跑到饮水机那里接水,这样
既麻烦又浪费时间。如果为了提高效率,你决定买一个水壶,每次接水时带上水壶,这样可以一次性装满
水,回到宿舍后直接从水壶里倒水喝。当水喝完后,再去饮水机接水。显然,这种方式比每次都去接水要
高效得多。这其实就是一种池化技术。
在这个例子中,提前准备好水壶,就像是向系统申请了过量的资源,接水时直接从已申请的水壶中取水,而不是每次都去申请新的资源。
在技术领域中,内存池的工作原理也类似。程序首先向系统申请一块较大的内存空间,而不是每次需要内存时都向操作系统请求。之后,程序会在这块已申请的内存中进行分配和回收,而不再频繁地请求系统资源。
除了内存池,常见的池化技术还包括:
- 连接池:例如数据库连接池。每次与数据库建立连接都是一个耗时的操作,如果每次仅执行一个简单的SQL语句后就关闭连接,会浪费大量时间。因此,连接池通常会预先创建多个连接,执行SQL时从池中获取一个空闲连接,执行完后不关闭连接,继续等待下一次使用。这样可以避免频繁的连接和断开操作。
- 线程池:线程池的思想是预先创建一定数量的线程,并使它们处于休眠状态。当有客户端请求时,唤醒一个空闲线程来处理该请求。处理完毕后,线程进入休眠状态,等待下一个请求。
池化技术的核心思想在于提前申请并重复使用资源,从而减少重复创建资源的开销,提升效率。不同类型的池在实现细节上可能有所不同,但其根本思想是相似的。
02 项目整体架构
我们借鉴 tcmalloc 的三层架构,设计如下模块: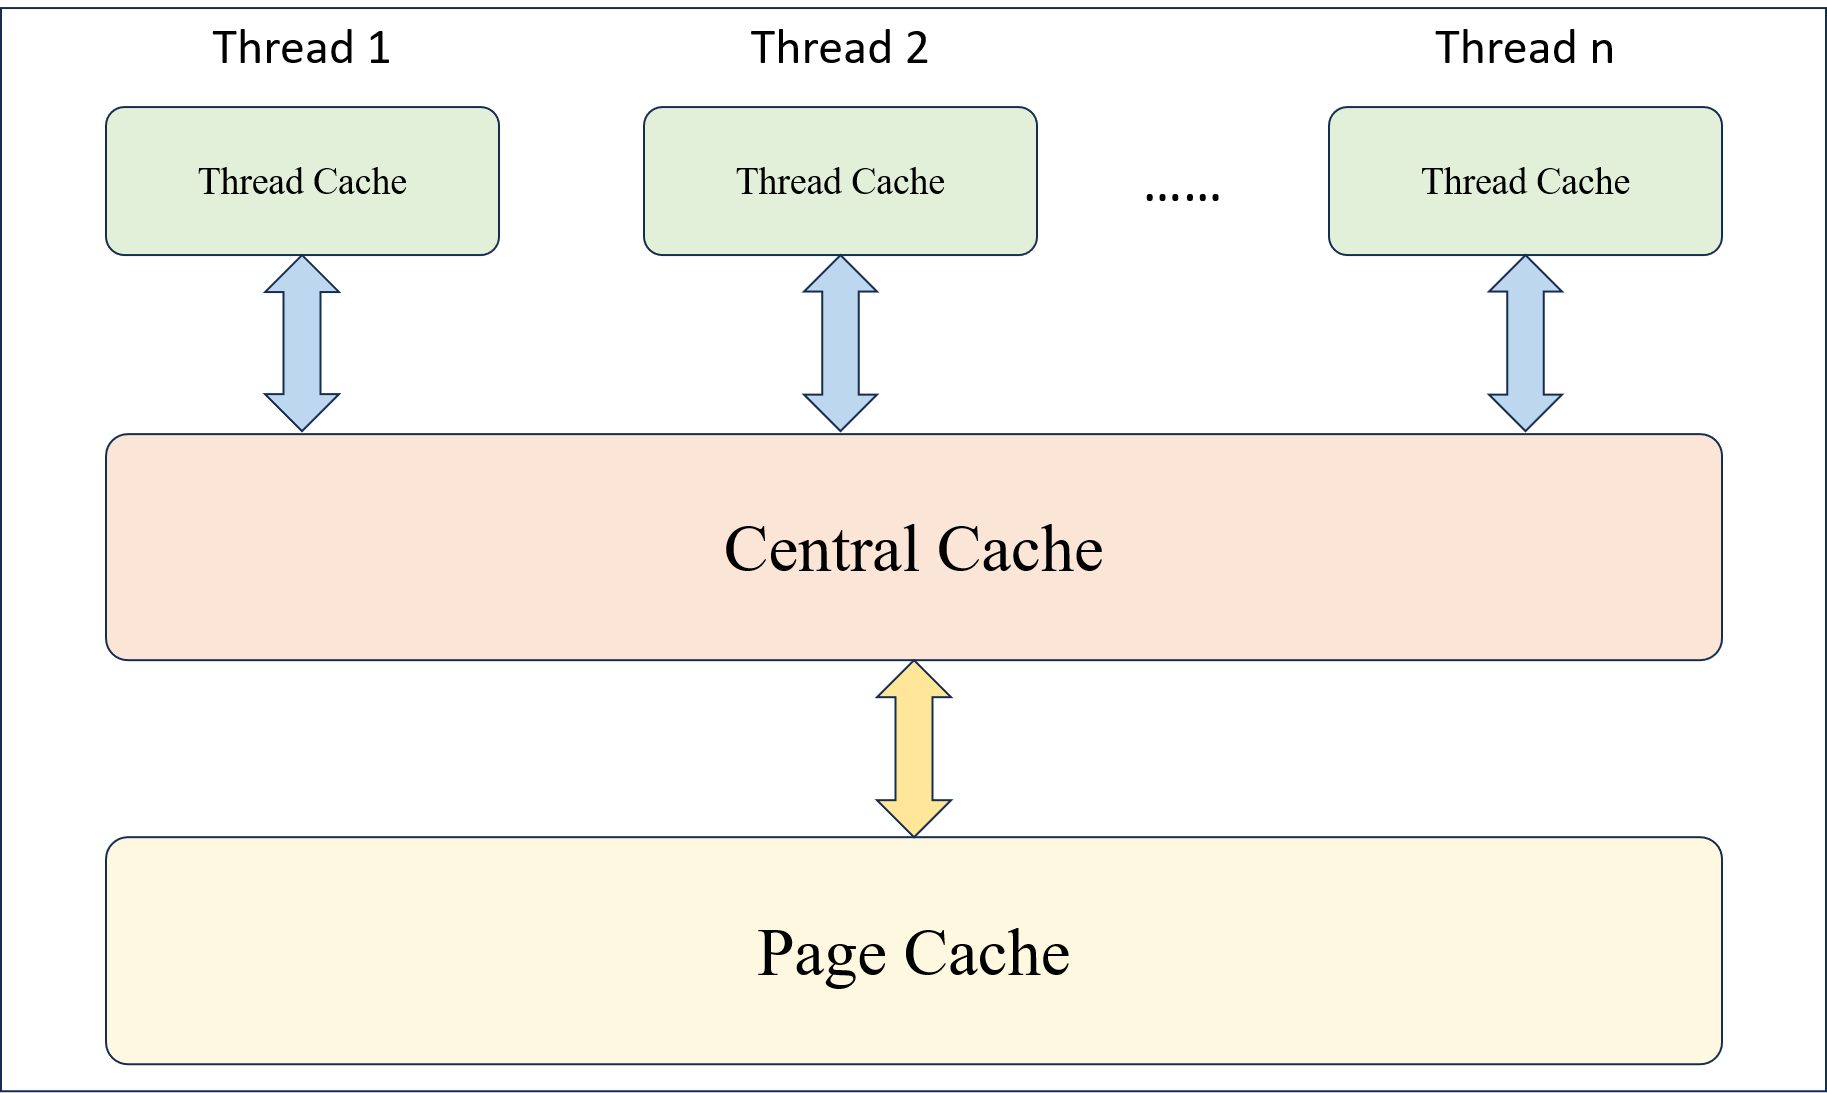
● Thread Cache
每个线程拥有独立的线程缓存,避免加锁。只要申请的内存不超过 256KB,线程会优先从自身的 Thread Cache 获取空间,其内部使用哈希桶+自由链表存储不同大小的内存块。
● Central Cache
线程缓存不够时,从 Central Cache 请求空间。
● Page Cache
当 Central Cache 空间不足或释放空间过多时,向 Page Cache 请求或归还内存。Page Cache 以页为单位组织内存,负责整合碎片,进行 Span 的合并与拆分。
03 定长内存池:快速入门
在学习高并发内存池之前,我们先来热个身,手动实现一个定长内存池,帮助大家建立对"内存池"的基本认识。
我们知道 malloc 虽然万能,但为了应对各种情况,设计得相对复杂,在高频率、小对象申请释放的场景下,效率可能不理想。那么,如果某个场景中我们只需要固定大小的内存分配,还有必要使用复杂的通用方案吗?其实完全可以设计一个更简洁高效的内存池,专门处理这种定长需求,这也正是我们现在要做的。
这个定长内存池的实现非常轻量,不到 100 行代码就能搞定,具体实现可以总结为以下几点:
- 预先申请一大块内存,把它切成一小块一小块的用;
- 用自由链表把这些小块管理起来,实现空间的重复利用;
- 如果用完了,再申请一块新的接着用;
- 每次回收时,就把小块重新挂到自由链表上。
话不多说,代码奉上:
c++
template<class T>
class ObjectPool
{
	public:
	T* New()
	{
		T* obj = nullptr;
		// 优先使用还回来的内存
		if (_freeList)
		{
			void* next = *((void**)_freeList);
			obj = (T*)_freeList;
			_freeList = next;

		}
		else
		{
			// 如果剩余内存不够一个对象大小时,则重新开大块空间
			if (_remainBytes < sizeof(T))
			{
				_remainBytes = 128 * 1024;
				//_memory = (char*)malloc(_remainBytes);
				_memory = (char*)SystemAlloc(_remainBytes >> 13);
				if (_memory == nullptr)
					throw std::bad_alloc();
			}

			obj = (T*)_memory;
			size_t objSize = sizeof(T) < sizeof(void*) ? sizeof(void*) : sizeof(T);
			_memory += objSize;
			_remainBytes -= objSize;

		}

		// 定位new,显示调用T的构造函数初始化
		new(obj)T;
		return obj;
	}

	void Delete(T* obj)
	{
		// 显示调用析构函数清理对象
		obj->~T();

		// 头插,为空与否的插入方式一致
		*(void**)obj = _freeList;
		_freeList = obj;

	}
	private:
	char* _memory = nullptr; // 指向大块内存的指针
	size_t _remainBytes = 0; // 大块内存在切分过程中剩余的字节数
	void* _freeList = nullptr; // 还回来过程中链接的自由链表

};
这样,一个简单而高效的定长内存池就实现了。下面我们写段代码来测试一下:
c++
struct TreeNode
{
    int _val;
    TreeNode* _left;
    TreeNode* _right;
    TreeNode()
        :_val(0)
            , _left(nullptr)
            , _right(nullptr)
        {}
};

void TestObjectPool()
{
    const size_t Rounds = 3;// 申请释放的轮次
    const size_t N = 1000000;// 每轮申请释放多少次

    size_t begin1 = clock();
    std::vector<TreeNode*> v1;
    v1.reserve(N);

    for (size_t j = 0; j < Rounds; ++j)
    {
        for (int i = 0; i < N; ++i)
        {
            v1.push_back(new TreeNode);
        }
        for (int i = 0; i < N; ++i)
        {
            delete v1[i];
        }
        v1.clear();
    }

    size_t end1 = clock();


    ObjectPool<TreeNode> TNPool;
    size_t begin2 = clock();
    std::vector<TreeNode*> v2;
    v2.reserve(N);

    for (size_t j = 0; j < Rounds; ++j)
    {
        for (int i = 0; i < N; ++i)
        {
            v2.push_back(TNPool.New());
        }
        for (int i = 0; i < 100000; ++i)
        {
            TNPool.Delete(v2[i]);
        }
        v2.clear();
    }
    size_t end2 = clock();
    cout << "new cost time:" << end1 - begin1 << endl;
    cout << "object pool cost time:" << end2 - begin2 << endl;
}
可以看到,在多轮申请和释放下,使用定长内存池的速度明显优于 new/delete 机制。
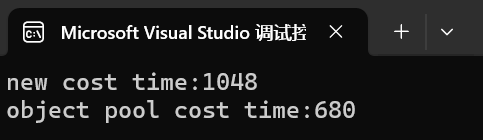
到这里,一个简单的定长内存池就算搞定了,下面我们正式进入高并发内存池的实现。
04 Thread Cache 初步实现
我们先简单回顾下之前说的定长内存池:
在定长内存池中,有一个 _freelist,也就是一个自由链表,用来管理某种固定大小的小块内存。比如我们要频繁分配一个对象,那这个 _freelist 就可以专门为这个对象提供固定长度的内存块。
但线程申请内存时,需求就没这么"整齐"了------可能要3B、6B、18K、236K......这时候,当然不能只用一个 _freelist,需要为不同大小的内存块设置对应的 _freelist 来做管理。
不过也不能太极端。比如说最大申请256KB,如果每个字节都建一个 _freelist,那就是二十多万个,没必要也没意义。
所以我们要在空间粒度和管理开销之间做个平衡:比如,第一个 _freelist 管8B的块,第二个管16B的,再往下是24B、32B......直到256KB。虽然听上去像是每次增加8B,其实真实实现里会有更复杂的对齐策略,这里先不展开。
那内存怎么分配呢?比如线程申请5B的内存,我们就给它一个8B的块;要10B,就给16B。虽然可能"多给了一点",但这比"给不够"要好得多。可以把它想象成你找爸妈要300块买衣服,结果爸妈豪气地给了你500,开心!但如果只给你50,让你去地摊凑合,那体验可就不太好了。
这种"多给"就带来了内碎片。就是说实际用的空间没那么大,但因为对齐分配,浪费了一点。而之前讲的外碎片,是指空间虽然多但不连续,申请不到大块。
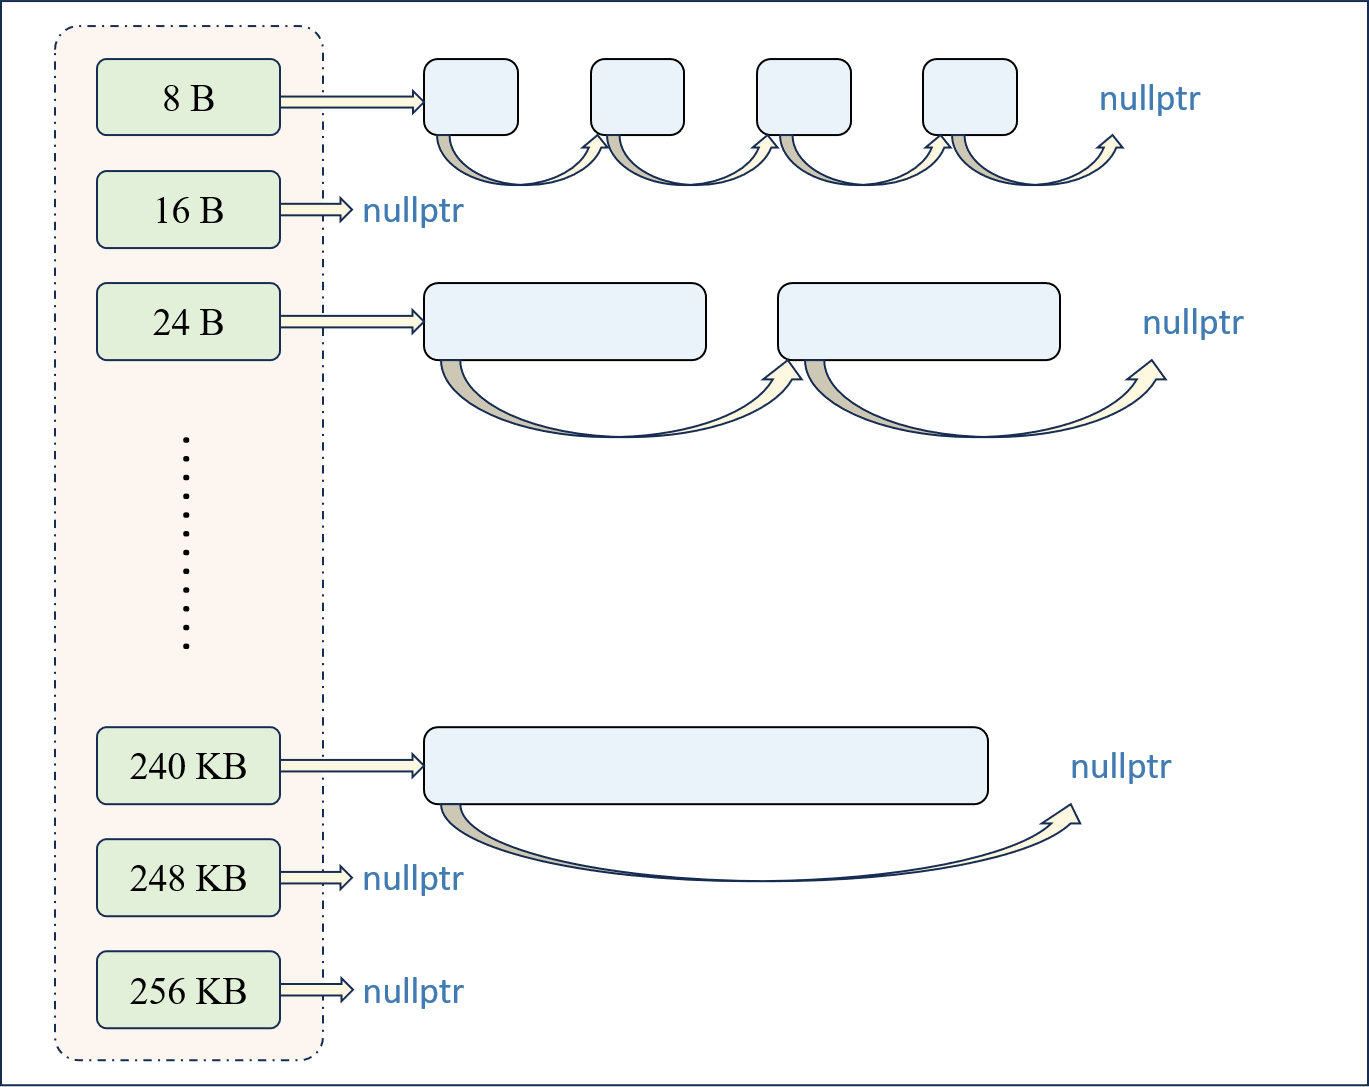
线程要申请内存时,其实是向 ThreadCache 请求。ThreadCache 内部本质上是一个哈希桶结构,每个桶就是一个 _freelist,比如第0个桶管8B、第1个管16B......到最大256KB。找内存时,就看对应大小的桶里有没有空闲块,有就用;没有就从更高一层的 CentralCache 拿。
由于要完整实现 ThreadCache 需要涉及到和 CentralCache 的交互,不好各自独立实现,所以我们先对 ThreadCache 进行初步实现。
04.1 基础结构设计
c++
class ThreadCache
{
    public:
    // 申请和释放内存对象
    void *Allocate(size_t size);
    void Deallocate(void *ptr, size_t size);
    // 从中心缓存获取对象
    void *FetchFromCentralCache(size_t index, size_t size);
    // 自由链表过长时,回收内存至 central cache
    void ListTooLong(FreeList &list, size_t size);

    private:
    FreeList _freeLists[NFREELIST];
};

// TLS thread local storage
static _declspec(thread) ThreadCache *pTLSThreadCache = nullptr;
在 ThreadCache 类中,FreeList 类就是我们管理空闲内存块的核心结构,正如前面所说的,它虽然叫FreeList,但实际上是一个哈希桶,桶内不需要额外的链表节点,内存块自己就是节点。它的结构如下:
c++
class FreeList
{
    public:
    void Push(void *obj);
    void PushRange(void *start, void *end, size_t n);
    void PopRange(void *&start, void *&end, size_t n);
    void *Pop();
    bool Empty();
    size_t &MaxSize();
    size_t Size();

    private:
    void *_freeList = nullptr;
    size_t _maxSize = 1;
    size_t _size = 0;
};目前我们只需要知道的是,FreeList 类提供两个操作:Push 把块放回去,Pop 从链表取出一块。
C++
void Push(void *obj)
{
    // 头插
    //*(void**)obj = _freeList;
    NextObj(obj) = _freeList;
    _freeList = obj;
    ++_size;
}

void PushRange(void *start, void *end, size_t n)
{
    NextObj(end) = _freeList;
    _freeList = start;
    _size += n;
}
为了让代码更清晰,我们封装了 ObjNext() 方法来获取或设置某个内存块的"下一个指针"位置,用 static 修饰,避免多次包含时报错。
C++
static void *&NextObj(void *obj)
{
    return *(void **)obj;
}
04.2 哈希桶设计与对齐规则
我们知道哈希表每个桶对应一个 _freelist,关键是:桶要设多少个?我们不能每8B就搞一个桶,还是太多。
于是我们参考 tcmalloc 的做法,按申请大小分多个区间:
- 1, 128 对齐到8B
- 129, 1024 对齐到16B
- 1025, 8K 对齐到128B
- 8K+1, 64K 对齐到1024B
- 64K+1, 256K 对齐到8KB
这样设计下来,最多只需要 208个桶,空间浪费也被控制在10%左右。浪费最多的点通常是每个区间的起始,比如 1B、129B、1025B,这些对齐后会有一定冗余,但相对于分配效率,这点浪费可以接受。
基于这样的设计,ThreadCache 的逻辑结构就如下图所示:
04.3 SizeClass:对齐与桶映射工具类
为了计算每次申请要对齐到多少字节、落在哪个桶里,我们专门写一个 SizeClass 类,内部的方法如下所示:
c++
class SizeClass
{
    public:
    static inline size_t _RoundUp(size_t bytes, size_t align)
    {
        /*size_t alignSize;
		if (bytes % align != 0)
			alignSize = (bytes / align + 1) * align;
		else
			alignSize = bytes;
		return alignSize;*/
        return ((bytes + align - 1) & ~(align - 1));
    }

    static inline size_t RoundUp(size_t size)
    {
        if (size <= 128)
            return _RoundUp(size, 8);
        else if (size <= 1024)
            return _RoundUp(size, 16);
        else if (size <= 8 * 1024)
            return _RoundUp(size, 128);
        else if (size <= 64 * 1024)
            return _RoundUp(size, 1024);
        else if (size <= 256 * 1024)
            return _RoundUp(size, 8 * 1024);
        else
            return _RoundUp(size, 1 << PAGE_SHIFT);
    }

    static inline size_t _Index(size_t bytes, size_t align_shift)
    {
        /*if (bytes % align == 0)
			return bytes / align - 1;
		else
			return bytes / align;*/
        return ((bytes + (1 << align_shift) - 1) >> align_shift) - 1;
    }

    // 计算映射的哪⼀个⾃由链表桶
    static inline size_t Index(size_t bytes)
    {
        assert(bytes <= MAX_BYTES);

        // 每个区间有多少个链
        static int group_array[4] = {16, 56, 56, 56};

        if (bytes <= 128)
            return _Index(bytes, 3);
        else if (bytes <= 1024)
            return _Index(bytes - 128, 4) + group_array[0];
        else if (bytes <= 8 * 1024)
            return _Index(bytes - 1024, 7) + group_array[1] + group_array[0];
        else if (bytes <= 64 * 1024)
            return _Index(bytes - 8 * 1024, 10) + group_array[2] +
            group_array[1] + group_array[0];
        else if (bytes <= 256 * 1024)
            return _Index(bytes - 64 * 1024, 13) + group_array[3] +
            group_array[2] + group_array[1] + group_array[0];

        else
        {
            assert(false);
            return -1;
        }
    }
};
其中有两个供外部调用的静态方法:
RoundUp(size):给定原始大小,算出应该对齐到多少字节。Index(size):算出该大小对应哈希表中的哪个下标。
这里的 Index 方法会根据 size 所属的区间,结合对齐规则,精准计算它在桶数组中的位置。内部还会用到一个辅助方法 _Index(),这个方法可以用位运算优化,效率更高。
04.4 ThreadCache::Allocate 的实现
ThreadCache::Allocate 是管理每个 ThreadCache 中内存分配的核心函数。它的主要任务是根据线程请求的内存大小从相应的哈希桶中获取空闲内存,或者在没有足够的空间时向CentralCache请求新的内存块。在经过前面的铺垫之后下面来拆解它的实现思路。
- 计算对齐后的字节数和哈希桶索引 。当线程请求一定大小的内存时,首先需要根据请求的字节数来确定实际分配的内存大小。这一步我们知道是通过
RoundUp(size)和Index(size)两个函数来实现。 - 查找哈希桶并分配内存 。一旦计算出需要对齐后的字节数和桶索引,
ThreadCache::Allocate就会尝试从哈希桶中对应的自由链表中获取内存块。这会涉及到两个过程:- 如果哈希桶中有空闲内存块(即该桶对应的自由链表非空),则调用
Pop()方法从该链表中取出一个内存块返回给线程。 - 如果哈希桶中没有足够的内存块(即链表为空),则需要向
CentralCache请求内存。这时,ThreadCache会通过FetchFromCentralCache()方法从中央缓存申请内存。
- 如果哈希桶中有空闲内存块(即该桶对应的自由链表非空),则调用
- 向中央缓存请求内存 。如果线程请求的内存无法从当前的
ThreadCache获取到,ThreadCache::Allocate就会将请求转发到CentralCache。
基于以上实现思路,下面给出ThreadCache::Allocate 的代码:
c++
void* ThreadCache::Allocate(size_t size)
{
    assert(size <= MAX_BYTES);
    size_t alignSize = SizeClass::RoundUp(size);
    size_t index = SizeClass::Index(size);

    if (!_freeLists[index].Empty())
        return _freeLists[index].Pop();
    else
        return FetchFromCentralCache(index, alignSize);
}
以上,我们便初步实现了 ThreadCache。下面我们进入到 CentralCache 的实现。
05 Central Cache 初步实现
现在我们知道,当 ThreadCache 的空间不足时,会向 CentralCache 请求更多的空间。在ThreadCache的实现中,曾留有一个接口 FetchFromCentralCache,这个接口的具体实现会在我们讨论完CentralCache的细节后完成。
05.1 Thread Cache 与 Central Cache 的关系
我们先来看下 CentralCache 的结构:
c++
// 单例模式
class CentralCache
{
    public:
    static CentralCache* GetInstance()
    {
        return &_sInst;
    }

    // 获取⼀个非空的 span
    Span* GetOneSpan(SpanList& list, size_t size);

    // 从central cache获取一定数量的内存对象给thread cache

    size_t FetchRangeObj(void*& start, void*& end, size_t batchNum, size_t size);
    // 将⼀定数量的对象释放到 Span
    void ReleaseListToSpans(void* start, size_t size);

    private:
    SpanList _spanLists[NFREELIST];
    private:
    CentralCache(){}
    CentralCache(const CentralCache&) = delete;

    static CentralCache _sInst;
};实际上,ThreadCache 和 CentralCache 有很多相似之处,比较明显的是 CentralCache 也采用了哈希结构来存储数据,并且同样是根据块的大小来进行映射。两者的映射规则一致带来了许多便利,比如当 ThreadCache 对应的哈希桶没有足够的空间时,可以直接向 CentralCache 的相同哈希桶请求空间。这样一来,两个系统中的哈希桶实现一一对应,查找操作也变得更加高效。
ThreadCache 和 CentralCache 最大的区别在于线程隔离和锁的使用。
由于每个线程都有自己的 ThreadCache,所以线程向自己的 ThreadCache 申请空间时,是不需要加锁 的,效率很高。但如果某个桶(比如 24B)已经空了,ThreadCache 就会从全局的 CentralCache 中申请内存。这个时候问题来了:CentralCache 是全局唯一的,并且所有线程共享一个桶(SpanList)。
举个例子,如果线程 t1 和 t2 同时从各自 ThreadCache 的 24B 桶申请内存,而这个桶恰好都空了,它们就会同时向 CentralCache 的 2 号桶发起请求。此时就会发生竞争,因此必须加锁来确保线程安全。
值得注意的是:不是每次访问 CentralCache 都会锁冲突 ,只有当多个线程竞争同一个桶时才会锁冲突。如果 t1 向 24B 的桶申请,t2 向 128B 的桶申请,它们访问的是 CentralCache 中的不同桶,使用的是不同的锁,不会产生冲突。
05.2 Span 结构与内存管理
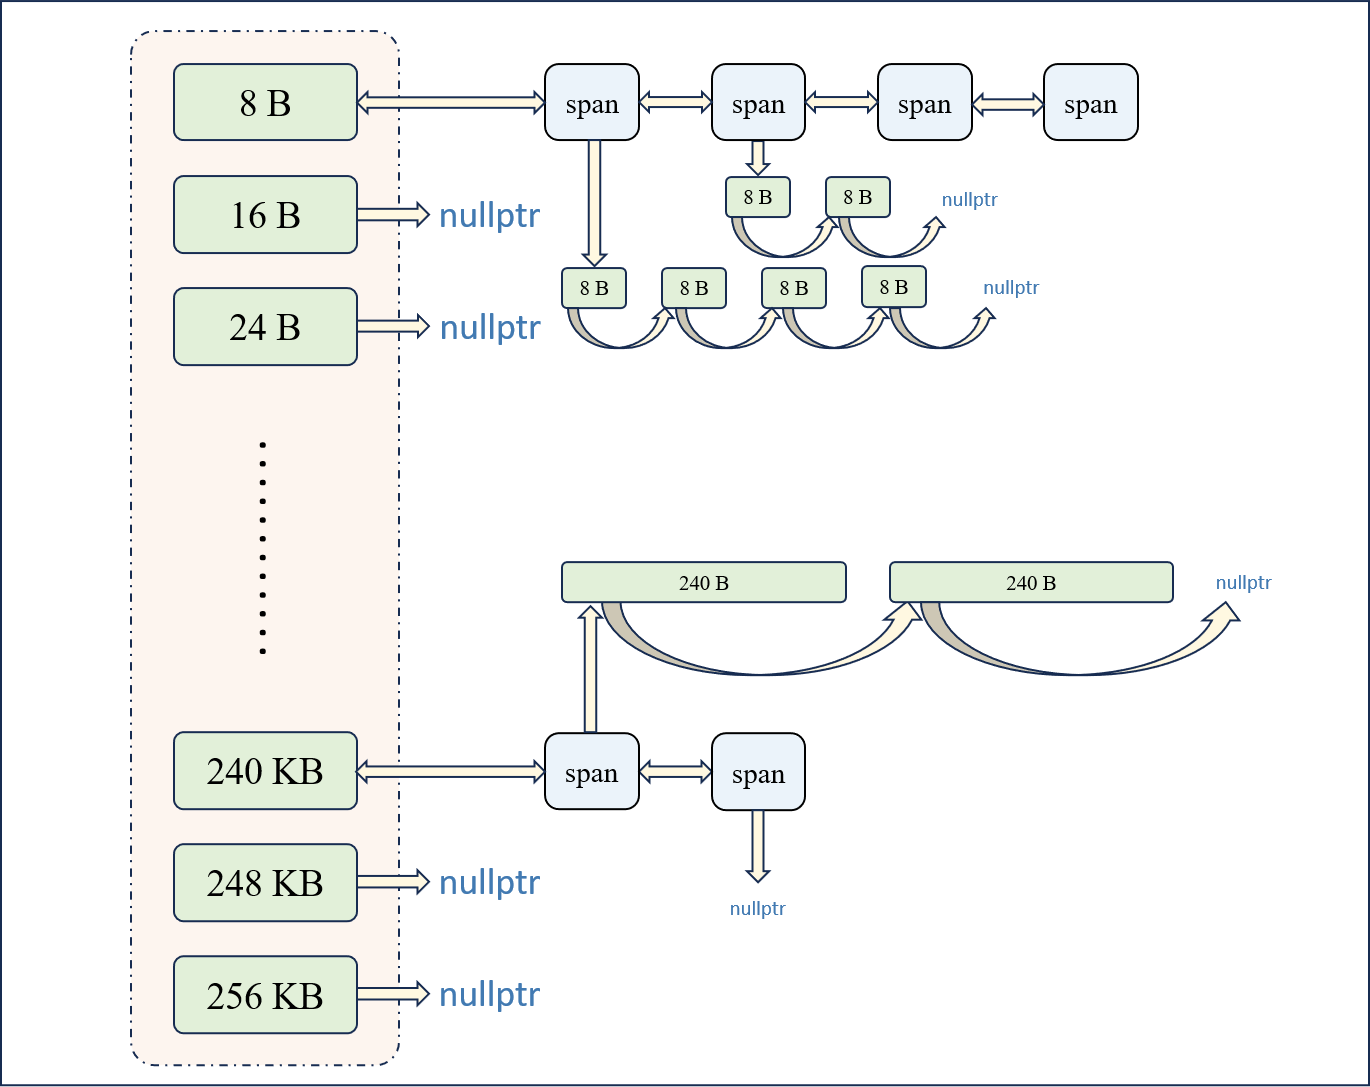
除了锁机制的不同,ThreadCache 和 CentralCache 在管理内存方面也有所不同。在 ThreadCache 中,自由链表挂的是一个个小块空间,而在 CentralCache 中,自由链表挂的是 Span 结构体,这是一种管理大块内存的结构体,它以页 为单位进行管理,每个 Span 可以包含多个页。其逻辑结构如下图所示:
Span 结构体的实现如下所示:
c++
// 管理多个连续页的大块内存跨度结构
struct Span
{
    PAGE_ID _pageId = 0;		// 大块内存的起始页号
    size_t _n = 0;				// 页的数量
    // 双向链表
    Span* _next = nullptr;
    Span* _prev = nullptr;

    size_t _objSize = 0;		// 切好的小对象的大小
    size_t _useCount = 0;		// 切好的小块内存被分配给thread cache的数量
    void* _freeList = nullptr;	// 切好的小块内存的自由链表

    bool _isUse = false;		// 是否被使用
};
在 Span 结构体中,有一个 _n 成员变量,用来记录该 Span 管理了多少页(Page)内存。而具体需要多少页,是由 SizeClass::NumMovePage(size) 决定的,它会根据你当前要分配的小块内存 size 动态计算出合理的页数。其实现方式如下所示:
c++
class SizeClass
{
    public:
    // 一次从中心缓存获取多少个
    static size_t NumMoveSize(size_t size)
    {
        assert(size > 0);
        if (size == 0)
            return 0;
        // [2, 512],⼀次批量移动多少个对象的(慢启动)上限值
        // 小对象一次批量上限⾼
        // 小对象一次批量上限低
        int num = MAX_BYTES / size;
        if (num < 2)
            num = 2;
        if (num > 512)
            num = 512;
        return num;
    }

    // 计算一次向系统获取几个页
    // 单个对象 8B
    // ...
    // 单个对象 256KB
    static size_t NumMovePage(size_t size)
    {
        size_t num = NumMoveSize(size);
        size_t npage = num * size;
        npage >>= PAGE_SHIFT;
        if (npage == 0)
            npage = 1;
        return npage;
    }

};
整个计算过程是这样的:
- 先算出要搬多少个对象 :
使用NumMoveSize(size),根据对象的大小,系统估计出一次批量搬运多少个比较合适。这个值是MAX_BYTES / size,也就是说小对象就多搬点,大对象就少搬点,并且限定在 2, 512 之间。 - 算出总共需要多少字节 :
比如要搬num个对象,每个对象size字节,总共num * size字节。 - 换算成页数 :
把总字节数除以页大小(PAGE_SHIFT是页大小的对数,通常是 8KB),最终得到npage。如果结果是 0(比如很小的对象),也会被强制设置成至少 1 页,保证不会返回空Span。
下面我们举两个例子:
- 对象大小为 8 字节 :
NumMoveSize(8) = 256,因为1024 / 8 = 128,在 2, 512 范围内;- 总字节数:256 × 8 = 2048 字节;
- 页数:2048 / 8192 = 0.25 → 向下取整为 0,但最终返回 1 页。
- 对象大小为 128KB :
NumMoveSize(131072) = 2,因为1024 / 131072 < 2,被强制取 2;- 总字节数:2 × 131072 = 256KB;
- 页数:256KB / 8KB = 32 → 返回 32 页。
由此可以看出:Span 并不是固定管理某个桶号对应的页数,而是动态地根据实际要搬运的小块大小去合理分配页数。这个机制既保证了空间利用率,也避免了内存碎片问题。
05.3 使用 SpanList 管理 Span
在了解了 Span 是如何按页单位管理大块内存之后,我们还需要搞清楚一个问题:这些 Span 是如何在 CentralCache 中被组织起来的?答案是通过 SpanList。我们可以把它理解成一个管理不同大小 Span 的仓库,负责挂载所有当前空闲的、已经被切好块的 Span。
SpanList 的实现本质上是一个双向循环链表 ,每一个桶号都有对应的一条链表来维护这些 Span,例如 24B 对象的第 2 号桶,就会拥有一条专门维护 24B 对象的 SpanList,里面挂着一个个页数不同、但都被切成 24B 小块的 Span。这使得 CentralCache 的内部结构非常清晰:每种对象大小一个桶,每个桶一个链表,链表里挂的是装满了该类型对象的 Span。
此外,为了解决前面我们提到的线程安全问题,SpanList 在内部维护了一把互斥锁 std::mutex _mtx。我们已经知道,它是桶级别的锁 ,每个桶只保护自己的 SpanList,而不影响其他桶。
了解了 SpanList 的这些特性,下面我们来看下它的实现:
c++
class SpanList
{
public:
	SpanList()
	{
		_head = new Span;
		_head->_next = _head;
		_head->_prev = _head;
	}

	Span *Begin();
	Span *End();
	bool Empty();
	void PushFront(Span *span);
	Span *PopFront();
	void Insert(Span *pos, Span *newSpan);
	void Erase(Span *pos);

public:
	std::mutex _mtx; // 桶锁
private:
	Span *_head;
};
05.4 FetchFromCentralCache 的实现
接下来我们来梳理一下 ThreadCache 和 CentralCache 之间的交互逻辑,也就是 FetchFromCentralCache 函数的实现。
首先我们要明确这个函数的作用是:当线程从 ThreadCache 申请内存时,如果对应的自由链表里已经没有空闲块了,就需要向 CentralCache 请求更多的内存。CentralCache 会从对应哈希桶下挂的 Span 中取出若干块内存,交还给 ThreadCache 使用。
那这里有一个关键问题:每次要从 CentralCache 拿多少块比较合适?拿太少效率低,拿太多又容易浪费。
为了解决这个问题,我们引入了一种"慢启动 + 增量反馈 "的策略,这和网络里的拥塞控制有点类似。刚开始的时候,CentralCache 只给 ThreadCache 一小块内存,如果发现 ThreadCache 对这个大小的内存频繁请求,就逐步增加它每次拿的数量。比如第一次只给 1 块,第二次给 2 块,第三次给 3 块...... 以此类推。这个过程有上限,不能无限增加,以防内存浪费。
这个动态控制的核心在于:ThreadCache 里的每个 FreeList 都记录了一个 MaxSize 值,表示当前最多能申请多少块。 CentralCache 每次分配时,会取 MaxSize 和 SizeClass::NumMoveSize(alignSize) 中较小的值来作为本次的分配数量。如果这次的分配量正好等于 MaxSize,那说明当前请求频率比较高,就将 MaxSize 加 1,为下一次留出更大的配额。这样就实现了逐步放宽的反馈机制。之后,CentralCache 会调用另一个函数 FetchRangeObj,从对应的 Span 中取出一整段连续的内存块。这个函数返回实际取出的块数(可能比请求的少),并通过 start 和 end 两个输出指针返回这段内存的起止位置。
拿到这段空间后,如果只获得了 1 块,就直接返回给线程;如果获得了多块,就把前一块返回给线程,把剩下的 [ObjNext(start), end] 插入到当前线程的自由链表中,供后续分配使用。
整个流程清晰又高效,既能动态适应线程的内存请求,又尽量避免资源浪费,是一个很优雅的设计。
下面是 FetchFromCentralCache 函数的具体实现:
c++
void *ThreadCache::FetchFromCentralCache(size_t index, size_t size)
{
    size_t batchNum = min(_freeLists[index].MaxSize(), SizeClass::NumMoveSize(size));

    if (_freeLists[index].MaxSize() == batchNum)
    {
        _freeLists[index].MaxSize() += 1;
    }

    void *start = nullptr;
    void *end = nullptr;
    size_t actualNum = CentralCache::GetInstance()->FetchRangeObj(start, end, batchNum, size);
    assert(actualNum > 0);

    if (actualNum == 1)
    {
        assert(start == end);
        return start;
    }
    else
    {
        _freeLists[index].PushRange(NextObj(start), end, actualNum - 1);
        return start;
    }
}
到目前为止,我们实际上只实现了空间的"申请"逻辑,释放还没涉及,比如 ThreadCache 如何将不用的块还给 CentralCache,以及 CentralCache 如何将空闲 Span 归还给 PageCache。为了让流程更容易理解,我们打算先把分配的部分理顺,后续再补上回收机制。
06 Page Cache 实现
PageCache 在整体架构上和 CentralCache 类似,核心都是通过哈希桶来管理 Span。区别在于,在 CentralCache 中,哈希映射规则和 ThreadCache 一样,都是通过 size 来定位桶,而 PageCache 则是按照 Span 的页数来组织的:第 i 号桶中挂的全是管理 i 页的 Span。
此外,由于 PageCache 的 Span 是按页数分桶的,所以其哈希结构更直接,不涉及对内部空间的再划分。也就是说,从 PageCache 拿到的 Span 是一整块的连续内存,具体的划分操作交由 CentralCache 去处理。
PageCache 中 Span 的最大管理页数是 128 页。如果一页是 8KB,那么 128 页就是 1MB 的空间,已经能满足最大 256KB 块的需求。当然也可以扩展更大的 span 管理能力,但当前实现以 128 页为界限。
简单介绍完 PageCache 和 CentralCache 的差异后,下面我们来看看 PageCache 的结构。
06.1 Page Cache 的基本结构
和 CentralCache 一样,PageCache 的核心是一个数组,数组的每个元素都是一个 SpanList,总数为 129 个(多预留一个,方便从 1 号桶开始直接映射)。这个数组中的第 n 项就负责 n 页大小的 Span。
另一点和 CentralCache 一样的是,PageCache 也需要加锁。但 CentralCache 是按桶加锁,而 PageCache 是整体加锁。这是因为 Span 的分裂和合并可能会影响多个桶之间的状态,只有整体加锁才能保证一致性。由于多个线程可能同时通过 CentralCache 向 PageCache 申请 Span,所以这个全局锁是必须的。
PageCache 作为全局唯一组件,也被实现成了饿汉式单例,静态实例定义放在 .cpp 文件中,避免链接冲突。
c++
class PageCache
{
    public:
    static PageCache* GetInstance()
    {
        return &_sInst;
    }

    // 获取从对象到 Span 的映射
    Span* MapObjectToSpan(void* obj);

    // 获取一个 k 页的 Span
    Span* NewSpan(size_t k);

    // 将空闲 Span归还至 page cache,并合并相邻 Span
    void ReleaseSpanToPageCache(Span* span);

    public:
    std::mutex _pageMtx;
    private:
    SpanList _spanLists[NPAGES];
    // NPAGES = 129,多开的那一个桶(第 0 号)是为了映射逻辑更自然,省去了 -1 的偏移操作。
    ObjectPool<Span> _spanPool;

    TCMalloc_PageMap1<32 - PAGE_SHIFT> _idSpanMap;

    static PageCache _sInst;

    PageCache(){}
    PageCache(const PageCache&) = delete;
};
06.2 Span 的分裂与合并机制
无论是在 ThreadCache、CentralCache 还是 PageCache 中,内存的申请与释放流程始终是核心。PageCache 中的分裂与合并机制,正是为了灵活调配这些 Span。
分裂逻辑:
当 CentralCache 通过 NewSpan() 向 PageCache 请求一个管理 k 页的 Span 时,PageCache 会先看对应桶(第 k 号)是否有 Span。如果没有,就从更大页数的桶中找,看是否能找到一个可以切分的 Span。比如想要一个 4 页的 Span,如果只有 10 页的 Span,那么就切成 4 页和 6 页的两个 Span,将后者重新挂回合适的桶中。相关代码如下所示:
c++
// 大于128页的直接向堆申请
if (k > NPAGES - 1)
{
    void* ptr = SystemAlloc(k);
    //Span* span = new Span;
    Span* span = _spanPool.New();
    span->_pageId = (PAGE_ID)ptr >> PAGE_SHIFT;
    span->_n = k;
    //_idSpanMap[span->_pageId] = span;
    _idSpanMap.set(span->_pageId, span);

    return span;
}

for (size_t i = k + 1; i < NPAGES; i++)
{
    if (!_spanLists[i].Empty())
    {
        // 切分成一个K页的 Span 和一个 n-k 页的 Span
        // K页的返回给 central cache,n-k 页的挂到第 n-k 个桶中去
        Span* nSpan = _spanLists[i].PopFront();
        //Span* kSpan = new Span;
        Span* kSpan = _spanPool.New();
        // 在 nSpan 的头部切K页
        kSpan->_pageId = nSpan->_pageId;
        kSpan->_n = k;

        nSpan->_pageId += k;
        nSpan->_n -= k;

        // 挂到第 n-k 个桶中去
        _spanLists[nSpan->_n].PushFront(nSpan);
        // 存储 nSpan 的首尾页号和 nSpan 映射,便于 page cache 回收内存时进行合并查找
        //_idSpanMap[nSpan->_pageId] = nSpan;
        //_idSpanMap[nSpan->_pageId + nSpan->_n - 1] = nSpan;
        _idSpanMap.set(nSpan->_pageId, nSpan);
        _idSpanMap.set(nSpan->_pageId + nSpan->_n - 1, nSpan);


        // 建立 id 和 Span 的映射,方便 central cache 回收小块内存时查找对应的 Span
        for (PAGE_ID i = 0; i < kSpan->_n; ++i)
            _idSpanMap.set(kSpan->_pageId + i, kSpan);
        //_idSpanMap[kSpan->_pageId + i] = kSpan;

        return kSpan;
    }
如果从第 k 号桶一直查到 128 号桶都没有合适的 span,就只能通过系统调用(如 mmap 或 VirtualAlloc)申请一个新的 128 页 Span,然后再按需切分。相关代码如下所示:
c++
// 走到这里说明后面的桶都没有 Span
// 找堆要一个128页的 Span
//Span* bigSpan = new Span;
Span* bigSpan = _spanPool.New();
void* ptr = SystemAlloc(NPAGES - 1);
bigSpan->_pageId = (PAGE_ID)ptr >> PAGE_SHIFT;
bigSpan->_n = NPAGES - 1;

_spanLists[bigSpan->_n].PushFront(bigSpan);

return NewSpan(k);
合并逻辑:
当 CentralCache 通过 ReleaseSpanToPageCache() 释放回一个 Span 后,PageCache 会尝试和相邻的空闲 Span 合并,减少碎片。比如一个页号为 100,管理 10 页的 Span,其范围是 [100, 110)。如果发现第 99 页和第 110 页对应的 Span 都是空闲的,就把它们合并为一个从 99 开始、总共 12 页的 Span。这个过程会向左右两边尽可能扩展,直到遇到不连续的页为止。相关代码如下所示:
c++
// 对 Span 前后的页尝试进行合并,缓解内存碎片问题
while (1)
{
    PAGE_ID prevId = span->_pageId - 1;
    //auto ret = _idSpanMap.find(prevId);
    //
     前面的页没有,不进行合并
    //if (ret == _idSpanMap.end())
    //	break;

    auto ret = (Span*)_idSpanMap.get(prevId);
    if (ret == nullptr)
        break;


    // 前面的页正在被使用,不进行合并
    Span* prevSpan = ret;
    if (prevSpan->_isUse == true)
        break;
    // 合并出超过128页的 Span,无法管理,不进行合并
    if (prevSpan->_n + span->_n > NPAGES - 1)
        break;

    span->_pageId = prevSpan->_pageId;
    span->_n += prevSpan->_n;

    _spanLists[prevSpan->_n].Erase(prevSpan);
    //delete prevSpan;
    _spanPool.Delete(prevSpan);
}

// 向后合并
while (1)
{
    PAGE_ID nextId = span->_pageId + span->_n;
    //auto ret = _idSpanMap.find(nextId);
     后面的页没有,不进行合并
    //if (ret == _idSpanMap.end())
    //	break;
    auto ret = (Span*)_idSpanMap.get(nextId);
    if (ret == nullptr)
        break;

    // 后面的页正在被使用,不进行合并
    Span* nextSpan = ret;
    if (nextSpan->_isUse == true)
        break;
    // 合并出超过128页的 Span,无法管理,不进行合并
    if (nextSpan->_n + span->_n > NPAGES - 1)
        break;

    span->_n += nextSpan->_n;

    _spanLists[nextSpan->_n].Erase(nextSpan);
    //delete nextSpan;
    _spanPool.Delete(nextSpan);
}
06.3 GetOneSpan 的获取逻辑
前面我们知道,当 CentralCache 中没有可用的 Span 时,会调用 GetOneSpan 向 PageCache 请求。这个函数首先检查 CentralCache 对应的桶中是否有可用的 Span,如果没有就调用 PageCache 的 NewSpan(size_t k) 从 PageCache 取一个 k 页的 Span。
这里的 k 需要根据实际请求的块大小 size 来计算,为此专门设计了一个"块大小到页数"的映射算法。例如申请 256KB 的块时,需要管理 64 页的 Span。具体计算过程我们已经在前面讲 SizeClass::NumMovePage(size) 的时候已经介绍过了,所以不再赘述。
CentralCache 获取到 Span 后,会将它划分为若干个大小为 size 的块,然后通过指针串联成链表,挂在 Span 的 _freeList 上。这些块空间都是连续的,划分过程只需从起始地址出发,依次向后按 size 步进即可。
划分完成后,将该 Span 插入 CentralCache 对应的桶中,然后返回给 CentralCache 使用。
相关代码如下:
c++
// 获取⼀个非空的 span
Span* CentralCache::GetOneSpan(SpanList& list, size_t size)
{
    // 查看当前的 spanlist 是否还有未分配对象的 Span
    Span* it = list.Begin();
    while (it != list.End())
    {
        if (it->_freeList != nullptr)
        {
            return it;
        }
        else
            it = it->_next;
    }


    // 走到这里说明没有空闲 Span 了,找 page cache 要
    // 先把 central cache 的桶锁解开,防止其他线程释放对象时阻塞
    list._mtx.unlock();

    PageCache::GetInstance()->_pageMtx.lock();
    Span* span = PageCache::GetInstance()->NewSpan(SizeClass::NumMovePage(size));
    span->_isUse = true;
    span->_objSize = size;
    PageCache::GetInstance()->_pageMtx.unlock();

    // 计算 Span 大块内存的起始地址和大小
    // 以下操作不需要加锁,因为目前其他线程访问不到该Span
    char* start = (char*)(span->_pageId << PAGE_SHIFT);
    size_t bytes = span->_n << PAGE_SHIFT;
    char* end = start + bytes;
    // 把大块内存切成自由链表链接起来
    span->_freeList = start;
    start += size;
    void* tail = span->_freeList;
    int i = 1;
    while (start < end)
    {
        ++i;
        NextObj(tail) = start;
        tail = NextObj(tail);
        start += size;
    }

    NextObj(tail) = nullptr;

    // 将切好的 Span 挂到桶里面时需要加锁
    list._mtx.lock();
    list.PushFront(span);

    return span;
}
07 回收空间
在内存分配的过程中,不仅要高效地申请空间,合理地回收也同样关键。我们先来看看 ThreadCache 是如何回收空间的。
07.1 Thread Cache 的归还逻辑
当线程释放内存时,它会先将这些块对齐后挂回到对应大小的自由链表中。但如果某个链表里的块数量过多,就需要将部分块归还给 CentralCache。具体的判断标准是:某个桶中的块数如果超过当前的最大申请批量(即 MaxSize),就会把 MaxSize 个块还给 CentralCache。相关代码如下所示:
c++
void ThreadCache::Deallocate(void* ptr, size_t size)
{
    assert(size <= MAX_BYTES);
    assert(ptr);

    size_t index = SizeClass::Index(size);
    _freeLists[index].Push(ptr);

    if (_freeLists[index].Size() >= _freeLists[index].MaxSize())
    {
        ListTooLong(_freeLists[index], size);
    }
}

void ThreadCache::ListTooLong(FreeList& list, size_t size)
{
	void* start = nullptr;
	void* end = nullptr;
	list.PopRange(start, end, list.MaxSize());

	CentralCache::GetInstance()->ReleaseListToSpans(start, size);
}
值得一提的是,这个 MaxSize 是动态变化的,从 1 开始递增,呈等差数列增长。随着线程不断请求同样大小的块,这个数列的总申请量自然会超过某次的 MaxSize。因此,当这些块被释放回来时,很可能一次就超过当前允许的最大数量,触发归还机制。
实际的 tcmalloc 源码比这里展示的逻辑要复杂得多,除了块数,还会考虑如线程总管理空间不能超过 2MB 等其他因素。我们这里只是用一个简化版规则来理解这个过程。
07.2 Central Cache 的归还逻辑
当 CentralCache 收到 ThreadCache 归还的一段空间时,它并不能简单地认为这些块来自同一个 Span。因为这些空间可能是多个 Span 的组合,归还时间也不同。
好在每块内存都有地址,我们可以通过 地址 >> 13(即除以 8KB)来获取页号,然后通过预先建立的哈希表(页号 -> Span 映射)快速定位块所属的 Span。这比逐个对比所有 Span 要高效得多,时间复杂度从 O(m*n) 降到 O(1)。
这张哈希表在分配 Span 给 CentralCache 时就会更新,并保存在 PageCache 中。这样后续 CentralCache 回收空间时,只需地址右移再查表,即可知道该块属于哪个 span。
CentralCache 在处理这些块时,会逐一将它们插入对应 Span 的 _freeList,并更新其 _useCount。一旦 _useCount 归零,说明该 Span 的所有块都已归还,这时可以考虑将它交还给 PageCache,以便将其合并为更大的 Span。
在归还前,需要先把该 Span 从 CentralCache 的桶中移除,并将其 _freeList 设为空。因为经过多次归还,这些块的顺序已经被打乱,已无法再作为一个有序链表使用,但这不影响 PageCache 之后的统一管理。
由于 Span 的合并涉及修改共享结构,为避免并发冲突,这一过程要加锁。同样,在归还 Span 之前也需要释放当前桶的锁,以免阻塞其他线程的操作。
相关代码如下:
c++
void CentralCache::ReleaseListToSpans(void* start, size_t size)
{
    size_t index = SizeClass::Index(size);

    _spanLists[index]._mtx.lock();

    while (start)
    {
        void* next = NextObj(start);
        Span* span = PageCache::GetInstance()->MapObjectToSpan(start);
        NextObj(start) = span->_freeList;
        span->_freeList = start;

        span->_useCount--;

        if (span->_useCount == 0)
        {
            // 说明 Span 切分出去的所有小块内存都已归还
            // 此时该 Span 可以再向 page cache 归还并尝试相邻页的合并
            _spanLists[index].Erase(span);
            span->_freeList = nullptr;
            span->_next = nullptr;
            span->_prev = nullptr;
            // 释放 Span 给 page cache 时,使用 page cache 的锁即可
            // 暂时把桶锁解掉
            _spanLists[index]._mtx.unlock();

            PageCache::GetInstance()->_pageMtx.lock();
            PageCache::GetInstance()->ReleaseSpanToPageCache(span);
            PageCache::GetInstance()->_pageMtx.unlock();

            _spanLists[index]._mtx.lock();
        }

        start = next;
    }

    _spanLists[index]._mtx.unlock();
}
07.3 Page Cache 的归还逻辑
当 PageCache 接收到 CentralCache 归还的 Span,它不会立刻挂到固定大小的桶中。因为有可能存在前后页相邻的其他空闲 Span,这时我们就可以将它们合并,形成更大的内存块,提高空间利用率。合并逻辑和前面的分裂类似,也需要加锁来保证安全。
具体的合并过程我们已经在Span 的分裂与合并机制小节那里讲过了,所以这里就不再赘述,相关代码如下:
c++
void PageCache::ReleaseSpanToPageCache(Span* span)
{
    // 大于128页的直接还给堆
    if (span->_n > NPAGES - 1)
    {
        void* ptr = (void*)(span->_pageId << PAGE_SHIFT);
        SystemFree(ptr);
        //delete span;
        _spanPool.Delete(span);

        return;
    }

    // 对 Span 前后的页尝试进行合并,缓解内存碎片问题
    while (1)
    {
        PAGE_ID prevId = span->_pageId - 1;
        //auto ret = _idSpanMap.find(prevId);
        //
         前面的页没有,不进行合并
        //if (ret == _idSpanMap.end())
        //	break;

        auto ret = (Span*)_idSpanMap.get(prevId);
        if (ret == nullptr)
            break;


        // 前面的页正在被使用,不进行合并
        Span* prevSpan = ret;
        if (prevSpan->_isUse == true)
            break;
        // 合并出超过128页的 Span,无法管理,不进行合并
        if (prevSpan->_n + span->_n > NPAGES - 1)
            break;

        span->_pageId = prevSpan->_pageId;
        span->_n += prevSpan->_n;

        _spanLists[prevSpan->_n].Erase(prevSpan);
        //delete prevSpan;
        _spanPool.Delete(prevSpan);
    }

    // 向后合并
    while (1)
    {
        PAGE_ID nextId = span->_pageId + span->_n;
        //auto ret = _idSpanMap.find(nextId);
         后面的页没有,不进行合并
        //if (ret == _idSpanMap.end())
        //	break;
        auto ret = (Span*)_idSpanMap.get(nextId);
        if (ret == nullptr)
            break;

        // 后面的页正在被使用,不进行合并
        Span* nextSpan = ret;
        if (nextSpan->_isUse == true)
            break;
        // 合并出超过128页的 Span,无法管理,不进行合并
        if (nextSpan->_n + span->_n > NPAGES - 1)
            break;

        span->_n += nextSpan->_n;

        _spanLists[nextSpan->_n].Erase(nextSpan);
        //delete nextSpan;
        _spanPool.Delete(nextSpan);
    }

    _spanLists[span->_n].PushFront(span);
    span->_isUse = false;
    //_idSpanMap[span->_pageId] = span;
    //_idSpanMap[span->_pageId + span->_n - 1] = span;
    _idSpanMap.set(span->_pageId, span);
    _idSpanMap.set(span->_pageId + span->_n - 1, span);

}
08 细节处理
到这里,整个内存分配与释放的主流程已经基本完成了,接下来要处理的是一些细节问题。虽然这些部分不像主流程那样硬核,但要想系统真正稳定高效运行,把这些小问题理清楚同样重要。
08.1 单次申请超过256KB时的处理
首先是单次申请超过 256KB 的情况。我们在之前的逻辑中默认 ThreadCache 不会处理超过 256KB 的请求,但在实际使用中这种需求是存在的。我们知道 PageCache 中一个 Span 最多可以管理 128 页的空间,即 1MB(128 × 8KB)。因此,如果申请的空间在 256KB 到 1MB 之间,就不再从 ThreadCache 请求,直接向 PageCache 申请即可。
另外,大于 256KB 的空间在申请时需要按页对齐。举个例子:申请 257KB,虽然只超出一点,但由于已经超过 256KB,因此要按页对齐,257KB 对应 32.125 页,就得向上取整,按 33 页来分配,总共是 264KB。这种对齐可能带来几 KB 的碎片,但因为使用周期短、很快就会释放,所以影响不大。
相关代码如下所示:
c++
static inline size_t RoundUp(size_t size)
{
    if (size <= 128)
        return _RoundUp(size, 8);
    else if (size <= 1024)
        return _RoundUp(size, 16);
    else if (size <= 8 * 1024)
        return _RoundUp(size, 128);
    else if (size <= 64 * 1024)
        return _RoundUp(size, 1024);
    else if (size <= 256 * 1024)
        return _RoundUp(size, 8 * 1024);
    else
        return _RoundUp(size, 1 << PAGE_SHIFT);
    // 单次申请空间大于256KB,直接按照页来对齐
}
对应地,释放过程也遵循类似原则:不再经过 ThreadCache,而是直接交由 PageCache 处理。如果申请的空间超过了 128 页,那就是直接向操作系统释放。
为了支持这些逻辑,代码中在 ConcurrentAlloc 和 NewSpan 中加入了对大页数的处理,同时在 ReleaseSpanToPageCache 中新增了向操作系统释放空间的逻辑。你可以通过一些测试用例验证,比如申请 257KB(即 33 页)和 129 页的空间,前者会走已有逻辑,后者会直接触发新的逻辑,检查是否按预期走通即可。
相关代码如下所示:
c++
// 大于128页的直接向堆申请
if (k > NPAGES - 1)
{
    void* ptr = SystemAlloc(k);
    //Span* span = new Span;
    Span* span = _spanPool.New();
    span->_pageId = (PAGE_ID)ptr >> PAGE_SHIFT;
    span->_n = k;
    //_idSpanMap[span->_pageId] = span;
    _idSpanMap.set(span->_pageId, span);

    return span;
}

// 直接去堆上按页申请空间
inline static void *SystemAlloc(size_t kpage)
{
#ifdef _WIN32
	void *ptr = VirtualAlloc(0, kpage << 13, MEM_COMMIT | MEM_RESERVE,
							 PAGE_READWRITE);
#else
	// Linux下brk mmap等
#endif
	if (ptr == nullptr)
		throw std::bad_alloc();
	return ptr;
}

// ReleaseSpanToPageCache 部分代码
// 大于128页的直接还给堆
if (span->_n > NPAGES - 1)
{
    void* ptr = (void*)(span->_pageId << PAGE_SHIFT);
    SystemFree(ptr);
    //delete span;
    _spanPool.Delete(span);

    return;
}

// SystemFree 实现
inline static void SystemFree(void *ptr)
{
#ifdef _WIN32
	VirtualFree(ptr, 0, MEM_RELEASE);
#else
	// sbrk unmmap等
#endif
}
08.2 使用定长内存池替代 new 和 malloc
项目完成后,为了更贴近实际使用,我们进一步优化了一点:让它尽量不依赖 malloc。虽然这个简易内存池还不够强大,不能完全取代 malloc,但如果要求没那么高,它已经是个不错的替代方案。要做到不使用 malloc,就得把项目中用到 new 的地方改成使用我们自定义的定长内存池,比如线程级的 TLSThreadCache 和 PageCache 中大量使用的 Span。
c++
T* New()
{
    T* obj = nullptr;
    // 优先使用还回来的内存
    if (_freeList)
    {
        void* next = *((void**)_freeList);
        obj = (T*)_freeList;
        _freeList = next;

    }
    else
    {
        // 如果剩余内存不够一个对象大小时,则重新开大块空间
        if (_remainBytes < sizeof(T))
        {
            _remainBytes = 128 * 1024;
            //_memory = (char*)malloc(_remainBytes);
            _memory = (char*)SystemAlloc(_remainBytes >> 13);
            if (_memory == nullptr)
                throw std::bad_alloc();
        }

        obj = (T*)_memory;
        size_t objSize = sizeof(T) < sizeof(void*) ? sizeof(void*) : sizeof(T);
        _memory += objSize;
        _remainBytes -= objSize;

    }

    // 定位new,显示调用T的构造函数初始化
    new(obj)T;
    return obj;
}
08.3 多线程下的内存池安全问题
这时候要注意一个线程安全问题:我们的定长内存池是静态的,在多线程环境下,多个线程共享这个池子,如果不加锁就可能在并发申请空间时出现空指针引用,造成程序崩溃。尤其是在第一次分配内存的时候,如果两个线程同时触发,那就很可能出现竞态。因此需要在分配过程中加一把互斥锁,保证线程安全。不过,为了性能考虑,我们只在创建 TLSThreadCache 的时候加锁,因为这个过程每个线程只会执行一次,而 Span 的创建在已有的 PageCache 锁保护下,是线程安全的。
c++
// 通过 TLS,每个进程可无锁获取自己的ThreadCache对象
if (pTLSThreadCache == nullptr)
{
    static ObjectPool<ThreadCache> tcPool;
    //pTLSThreadCache = new ThreadCache;

    // 防止 Thread Cache 申请到空指针
    tcPool._poolMtx.lock();
    pTLSThreadCache = tcPool.New();
    tcPool._poolMtx.unlock();

}
08.4 MapObjToSpan 的加锁处理
涉及查表的过程也得注意线程安全。因为我们用的是 unordered_map 来映射页号和 Span,而这个容器不是线程安全的。如果在增删元素时刚好有其他线程在查,就可能读取到无效数据,甚至崩溃。因此在 MapObjectToSpan 中也需要加锁,这把锁直接复用 PageCache 的全局锁就可以了。
c++
Span* PageCache::MapObjectToSpan(void* obj)
{
    PAGE_ID id = (PAGE_ID)obj >> PAGE_SHIFT;

    std::unique_lock<std::mutex> lock(_pageMtx);	// 出了作用域自动解锁

    auto ret = (Span*)_idSpanMap.get(id);
    assert(ret != nullptr);
    return ret;

}
09 使用基数树进行优化
09.1 初步结果对比
到这里,核心功能已经完成了,是时候看看我们写的 ConcurrentAlloc 和系统自带的 malloc 在性能上谁更胜一筹。我们专门写了一个 BenchMark.cpp 来进行对比测试:
c++
#include "ConcurrentAlloc.h"

// ntimes 一轮申请和释放内存的次数
// rounds 轮次
void BenchmarkMalloc(size_t ntimes, size_t nworks, size_t rounds)
{
	std::vector<std::thread>vthread(nworks);
	std::atomic<size_t> malloc_costtime = 0;
	std::atomic<size_t> free_costtime = 0;
	for (size_t k = 0; k < nworks; ++k)
	{
		vthread[k] = std::thread([&, k]{
		std::vector<void*> v;
		v.reserve(ntimes);
		for (size_t j = 0; j < rounds; ++j)
		{
		size_t begin1 = clock();
		for (size_t i = 0; i < ntimes; i++)
		{
		//v.push_back(malloc(16));
		v.push_back(malloc((16 + i) % 8192 + 1));
		}
		size_t end1 = clock();
		size_t begin2 = clock();
		for (size_t i = 0; i < ntimes; i++)
		{
			free(v[i]);
		}
		size_t end2 = clock();
		v.clear();
		malloc_costtime += (end1 - begin1);
		free_costtime += (end2 - begin2);
		}
			});
	}
	for (auto& t : vthread)
	{
		t.join();
	}
	printf("%u个线程并发执行%u轮次,每轮次malloc %u次: 花费:%u ms\n",
		nworks, rounds, ntimes, malloc_costtime.load());

	printf("%u个线程并发执行%u轮次,每轮次free %u次: 花费:%u ms\n",
		nworks, rounds, ntimes, free_costtime.load());

	printf("%u个线程并发malloc&free %u次,总计花费:%u ms\n",
		nworks, nworks * rounds * ntimes, malloc_costtime.load() + free_costtime.load());
}


// 单轮次申请释放次数 线程数 轮次
void BenchmarkConcurrentMalloc(size_t ntimes, size_t nworks, size_t rounds)
{

	std::vector<std::thread>vthread(nworks);
	std::atomic<size_t> malloc_costtime = 0;
	std::atomic<size_t> free_costtime = 0;
	for (size_t k = 0; k < nworks; ++k)
	{
		vthread[k] = std::thread([&]() {
		std::vector<void*> v;
		v.reserve(ntimes);
		for (size_t j = 0; j < rounds; ++j)
		{
			size_t begin1 = clock();
			for (size_t i = 0; i < ntimes; i++)
			{
				//v.push_back(ConcurrentAlloc(16));
				v.push_back(ConcurrentAlloc((16 + i) % 8192 + 1));
			}
			size_t end1 = clock();
			size_t begin2 = clock();
			for (size_t i = 0; i < ntimes; i++)
			{
				ConcurrentFree(v[i]);
			}
			size_t end2 = clock();
			v.clear();
			malloc_costtime += (end1 - begin1);
			free_costtime += (end2 - begin2);
		}
			});
	}
	for (auto& t : vthread)
	{
		t.join();
	}

	printf("%u个线程并发执行%u轮次,每轮次concurrent alloc %u次: 花费:%u ms\n",
		nworks, rounds, ntimes, malloc_costtime.load());

	printf("%u个线程并发执行%u轮次,每轮次concurrent dealloc %u次: 花费:%u ms\n",
		nworks, rounds, ntimes, free_costtime.load());

	printf("%u个线程并发concurrent alloc&dealloc %u次,总计花费:%u ms\n",
		nworks, nworks * rounds * ntimes, malloc_costtime.load() + free_costtime.load());
}

int main()
{
	size_t n = 10000;
	cout << "==========================================================" << endl;
	BenchmarkConcurrentMalloc(n, 4, 10);
	cout << endl << endl;
	BenchmarkMalloc(n, 4, 10);
	cout << "==========================================================" << endl;
	return 0;
}
这个测试会启动多个线程,让每个线程进行多轮次的内存申请和释放操作。测试包括两种场景:一种是每次申请固定大小的内存块,另一种是每次申请不同大小的内存块,模拟真实环境下更复杂的内存使用模式。
我们分别用 malloc/free 和 ConcurrentAlloc/ConcurrentFree 执行相同任务,并记录它们的耗时,最后将结果打印出来。
运行结果:
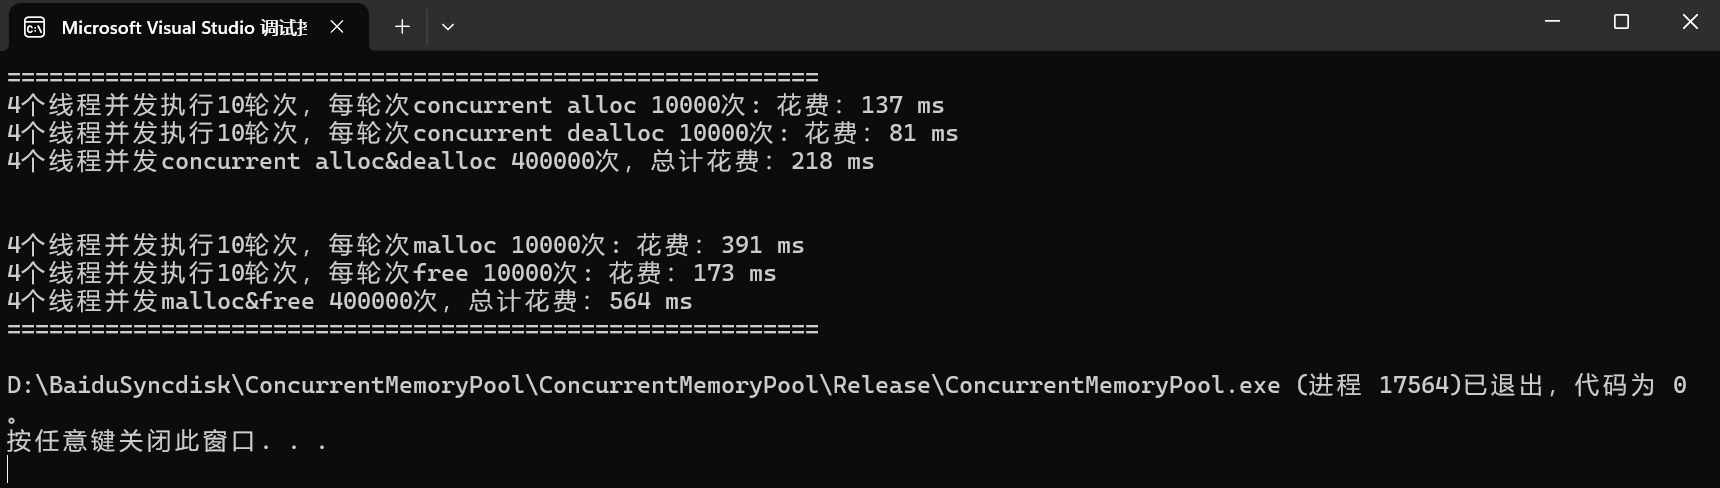
可以看到,虽然性能相比 malloc 有所提升,但还有没有进一步优化的空间呢?下面我们用性能分析工具来观察一下。
09.2 使用性能探查器分析性能瓶颈
不同平台都有自己的性能分析工具,我这里用的是 Visual Studio 自带的性能探查器。
打开性能分析工具后,勾选需要检测的项目,点击开始,它会自动收集函数调用频率和耗时信息。分析完成后,我们能看到一些关键指标,比如哪个函数最耗时。
在"热路径"里,可以看到函数的调用链,比如 std::thread::invoke 调用了 std::invoke,后者又进一步调用 lambda 转换成的仿函数。这就像栈帧一样,直观地告诉你时间都花在哪儿了。
还有一个"单个工作最耗时函数"的视图,显示了某个函数总共执行了多久。比如我们这里就发现,最耗时的是 lock,看来加锁的开销相当大。
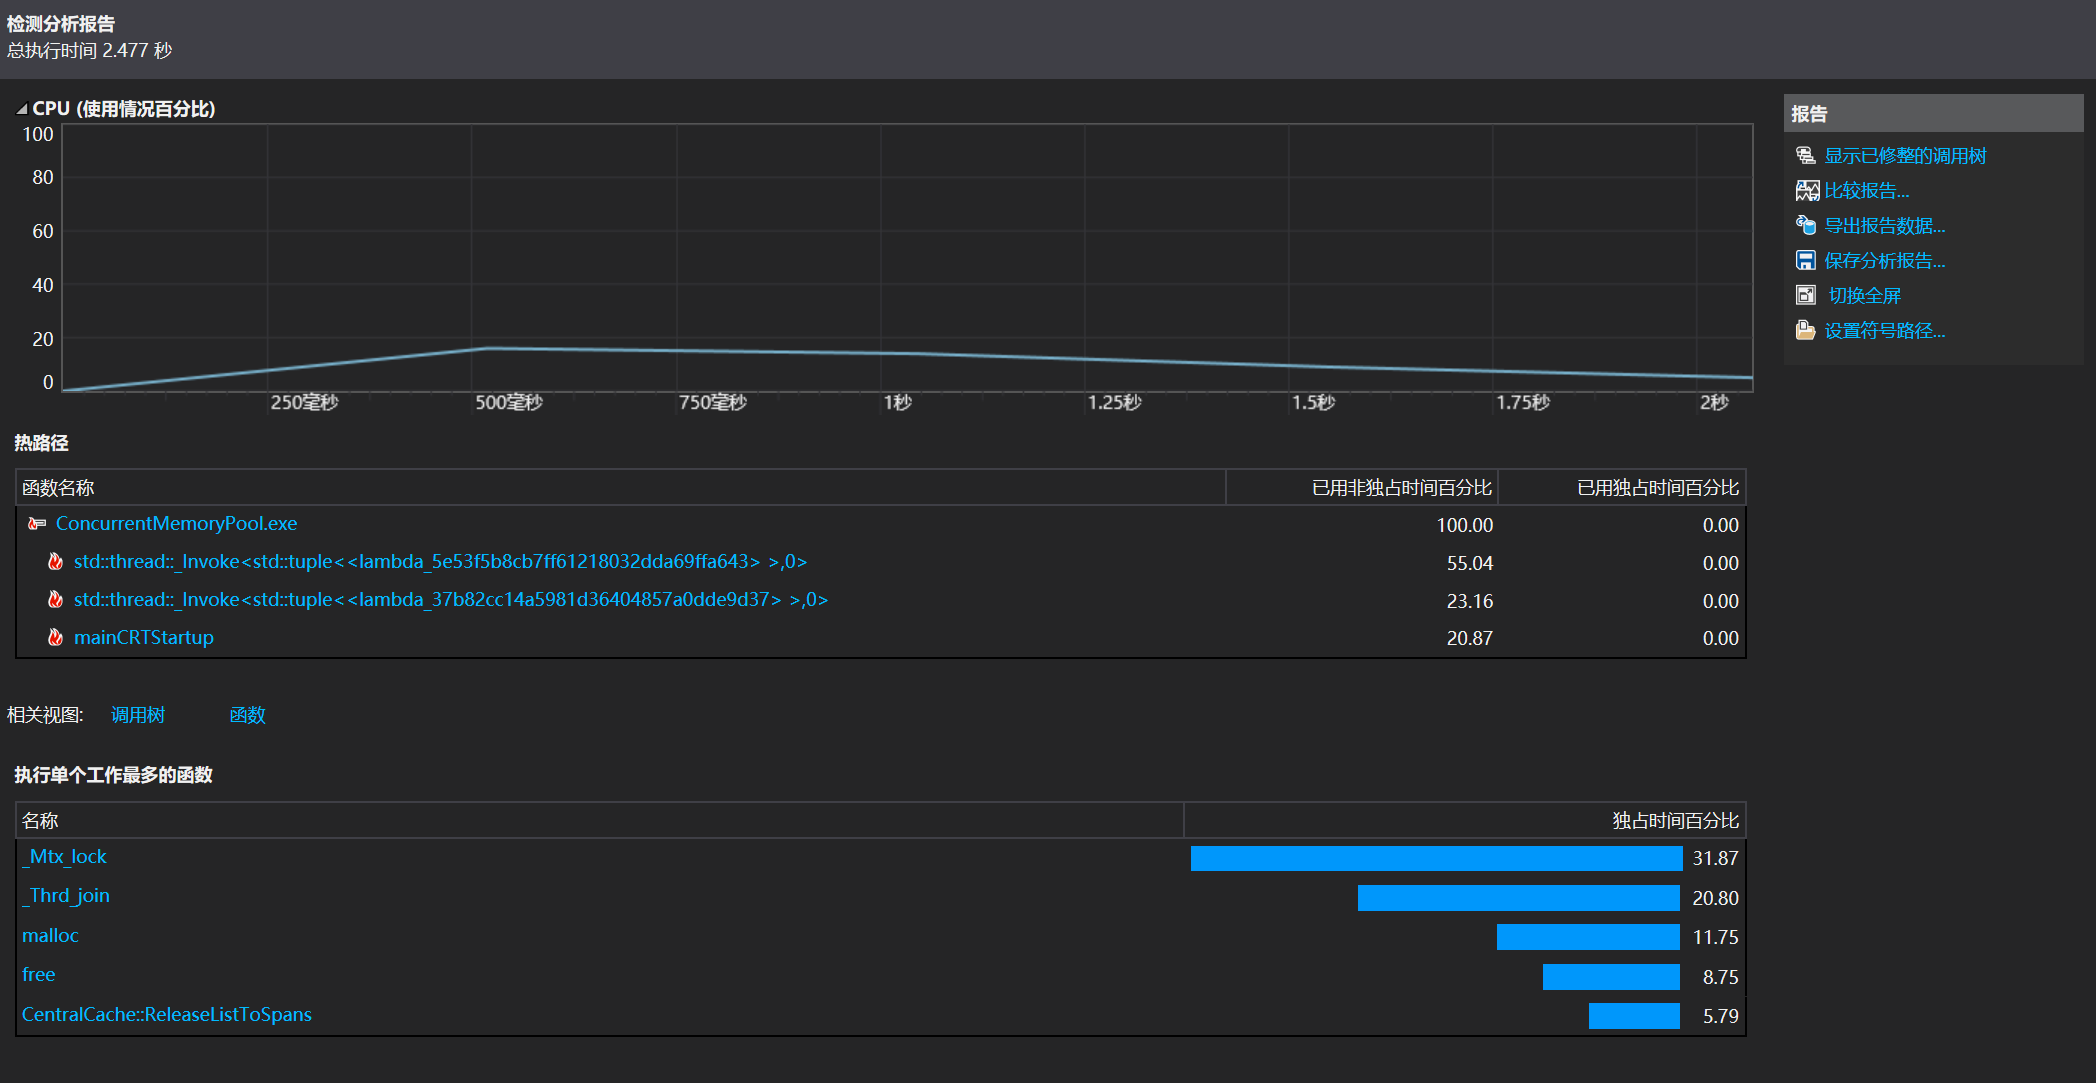
能不能避免频繁加锁带来的开销?当然可以。比如 tcmalloc 就用了一种叫"基数树"的结构来处理这类问题,有效规避了频繁加锁对性能的影响。
09.3 引入基数树
为了优化前面提到的性能瓶颈,tcmalloc 使用了基数树结构来代替传统的 unordered_map。原因在于,当数据量增大时,哈希查找和锁竞争的成本急剧上升,查得越慢,锁竞争越激烈,最终导致整体性能下滑。
**基数树(Radix Tree)**在 tcmalloc 中被设计为一到三层的结构,按需选择。其中一层的基数树最简单,本质上就是一个数组,通过页号直接作为下标定位到对应的 Span* 指针。这种结构在页号不多、位数不高的情况下,可以直接开出一个 2M 大小的数组,不仅查找速度快,而且不需要加锁。
c++
class TCMalloc_PageMap1
{
    private:
    static const int LENGTH = 1 << BITS;
    void** array_;

    public:
    typedef uintptr_t Number;

    explicit TCMalloc_PageMap1()
    {
        //*array_ = reinterpret_cast<void**>((*allocator)(sizeof(void*) << BITS));
        size_t size = sizeof(void*) << BITS;
        size_t alignSize = SizeClass::_RoundUp(size, 1 << PAGE_SHIFT);
        array_ = (void**)SystemAlloc(alignSize >> PAGE_SHIFT);
        memset(array_, 0, sizeof(void*) << BITS);
    }
    // Return the current value for KEY. Returns NULL if not yet set,
    // or if k is out of range.
    void* get(Number k) const
    {
        if ((k >> BITS) > 0)
        {
            return nullptr;
        }
        return array_[k];
    }
    // REQUIRES "k" is in range "[0,2^BITS-1]".
    // REQUIRES "k" has been ensured before.
    //
    // Sets the value 'v' for key 'k'.
    void set(Number k, void* v)
    {
        array_[k] = v;
    }
};
如果页号位数更多,比如页号占了 19 位,那么这个数组长度就是 219,对应约2MB空间,这在 32 位平台上是完全可接受的。但到了64 位系统,页号的位数可能达到 51 位,直接映射将消耗 254 字节(约 16PB)内存,显然是不现实的,因此就需要分层。
两层基数树的结构类似于二级页表:用页号的前几位(比如5位)索引第一层数组,每个元素指向一个新的数组,再由页号的后几位(比如14位)索引第二层数组中对应的 Span*。这样不仅实现了快速定位,也允许延迟分配内存,仅在实际映射某段页号时才创建对应的子数组,节省了空间。
三层结构则更进一步,适配 64 位系统的巨大地址空间。其原理和前面一样,只是多了一层索引,让整棵树可以稀疏展开,不需要在初始化时一次性开辟天文数字级别的内存,而是按需动态申请。
使用基数树的另一个优势是它的结构是静态的,即不会频繁调整或改变。读操作仅是通过数组下标获取指针,写操作只是设置某个数组元素指向新的 Span*。这意味着,在大多数情况下,读取过程中不会发生结构变动,也就不会有线程安全问题。因此,我们可以在读取时放心地去掉锁,从而进一步提升性能。
实际优化中,我们将原本 PageCache 中使用的 unordered_map 替换为单层基数树,在所有需要设置 Span* 的地方使用 set(),读取的地方使用 get(),并根据返回值是否为 nullptr 来判断是否成功获取。原先用于处理迭代器和比较的逻辑,也相应地简化了。
c++
//_idSpanMap[span->_pageId] = span;
//_idSpanMap[span->_pageId + span->_n - 1] = span;
_idSpanMap.set(span->_pageId, span);
_idSpanMap.set(span->_pageId + span->_n - 1, span);
最后,由于整个基数树的写入和读取逻辑在流程中是严格分离的,我们可以保证不会出现两个线程同时对同一个页号进行读写操作的情况,这就为彻底移除锁提供了基础条件,使得整体性能在数据量增长时也能保持良好表现。
09.4 优化后的性能对比
使用基数树进行优化后,下面我们再用性能探查工具观察一下优化后的结果:
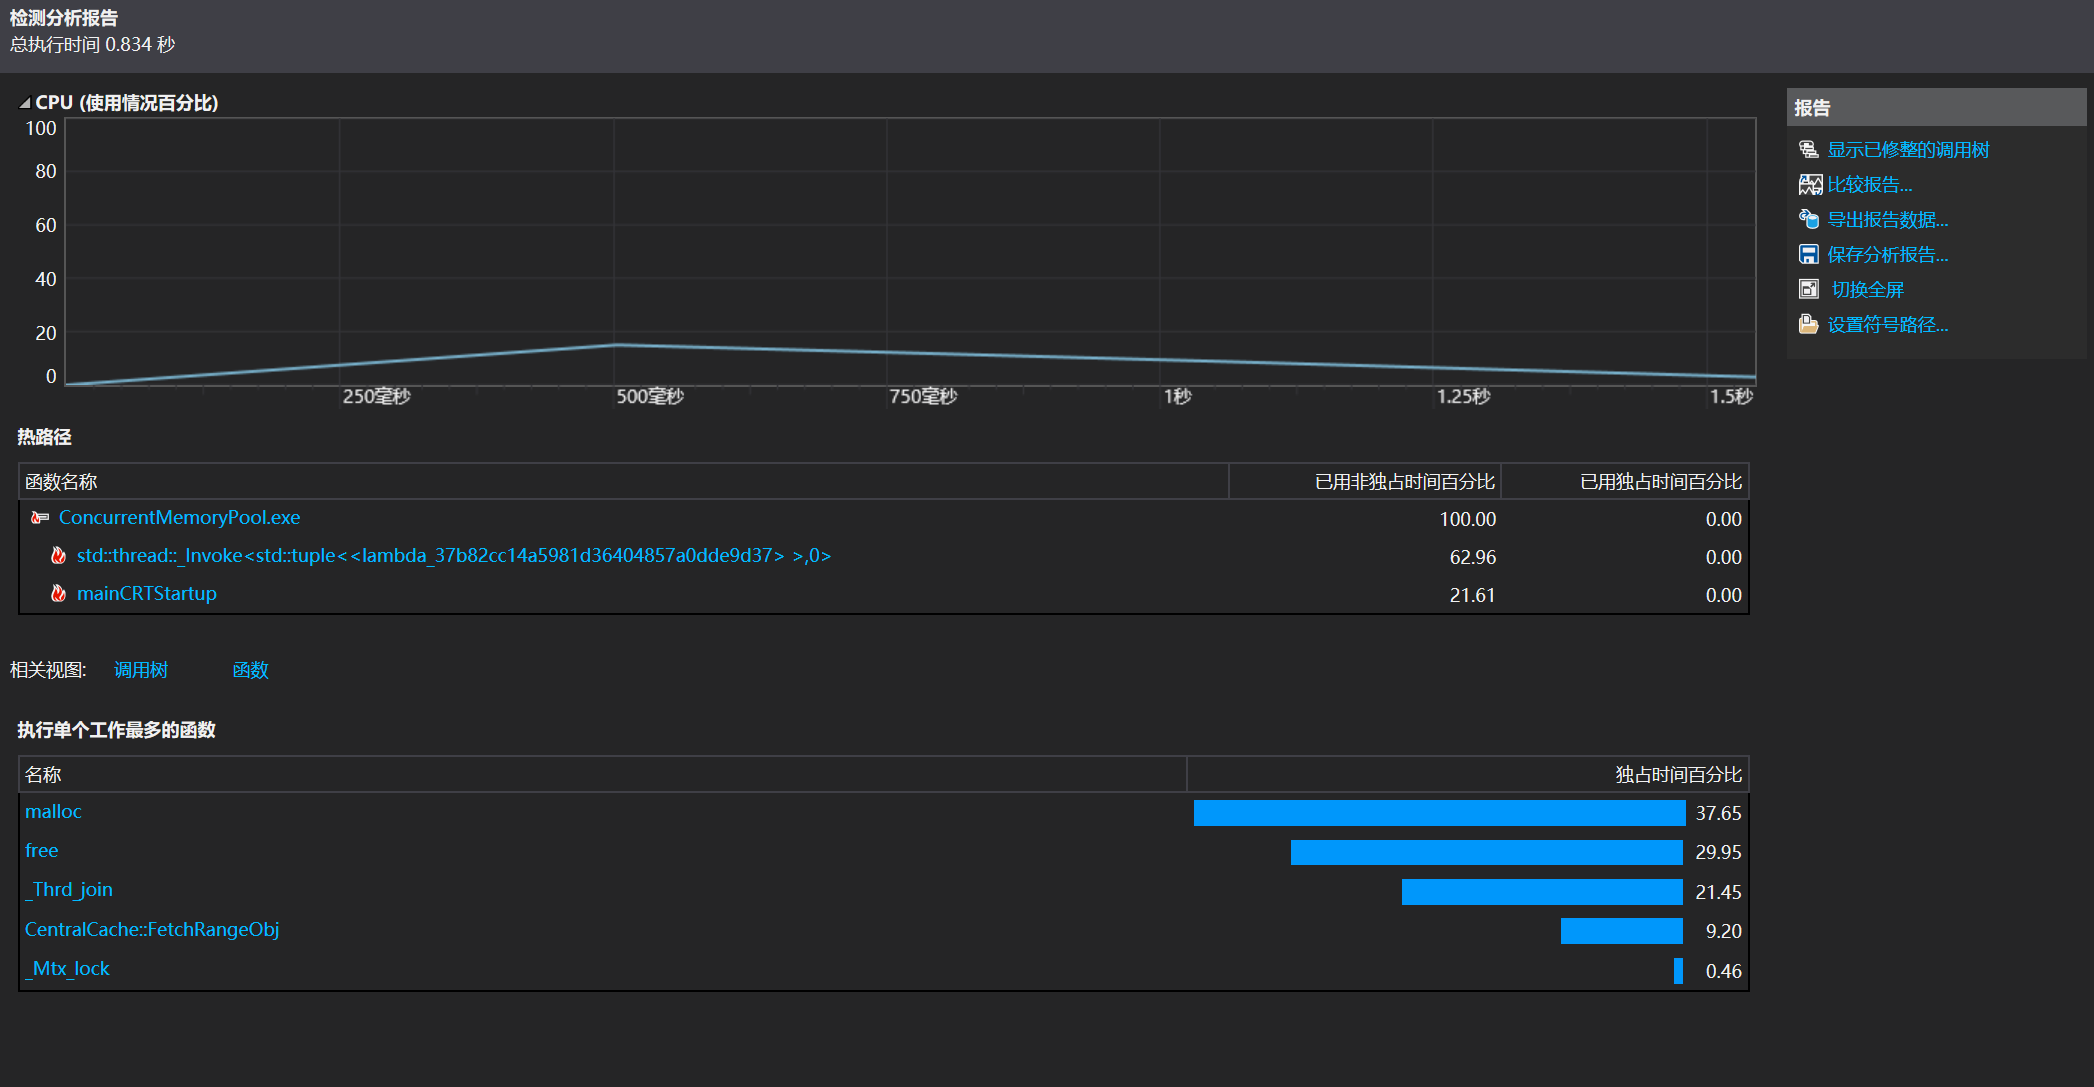
可以看到,此时最耗时的操作不再是 lock,而 malloc 和 free 作为我们被优化的对象理应排在了前列。
我们再看看 BenchMark.cpp 的运行结果:
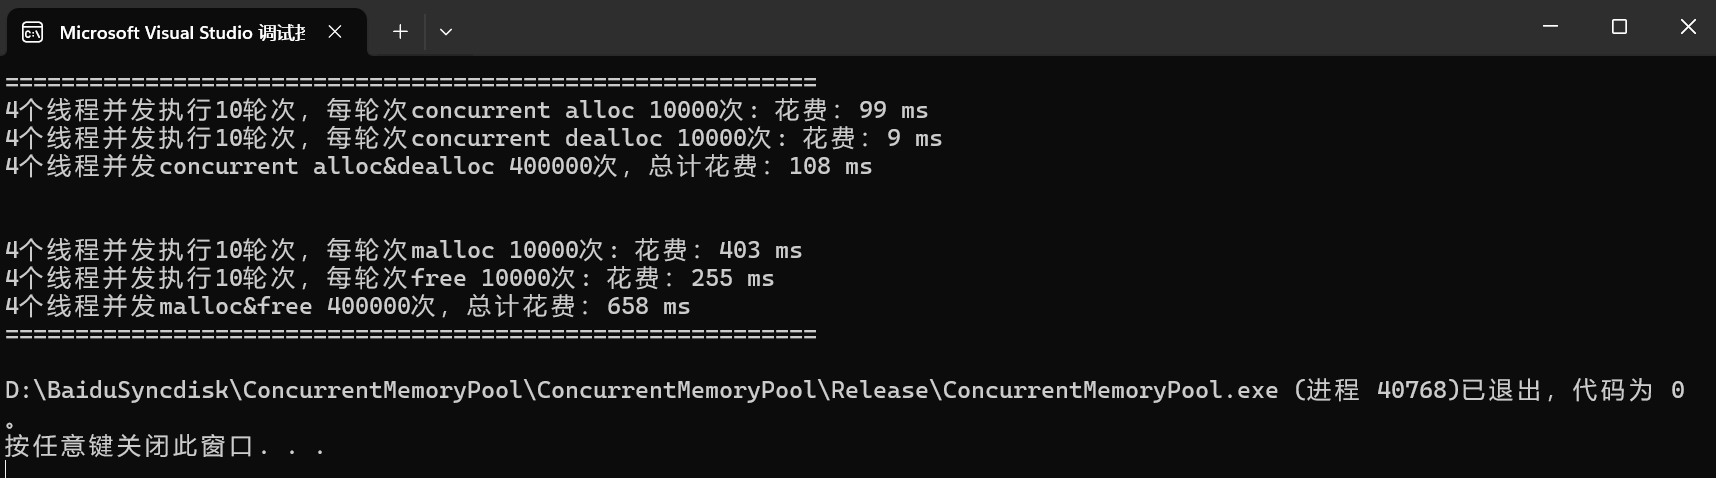
可以看出,这次 ConcurrentAlloc/ConcurrentFree 的运行速度相比 malloc/free 快了不少。
到这里,这个小项目就算告一段落了。最后再强调一遍:本项目的目的并不是完全复刻 tcmalloc 的源码,而是学习大佬的思路,深入理解其核心机制,从而提升自己的能力。
毕竟真正的 tcmalloc 源码多达几万行,我这边最终也就写了不到两千行代码,只是挑选其中的关键逻辑做了实现与讲解。如果你对源码感兴趣,推荐直接去 GitHub 上阅读原版,收获肯定会更大。