1. Hard Prompt
定义: Hard prompt 是一种更为具体和明确的提示,要求模型按照给定的信息生成精确的结果,通常用于需要模型提供准确答案的任务.
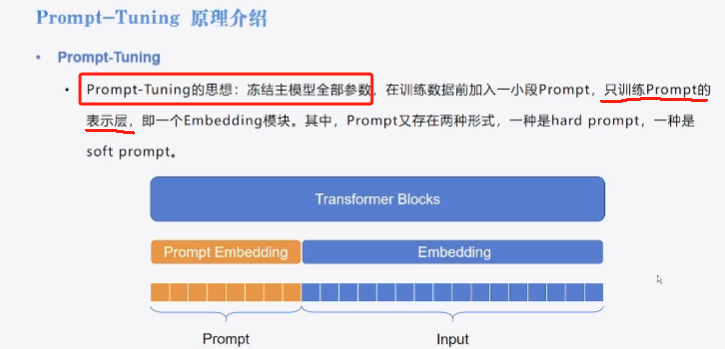
原理: Prompt Tuning原理如下图所示:冻结主模型全部参数,在训练数据前加入一小段Prompt,只训练Prompt的表示层,即一个Embedding模块。论文实验表明,只要模型规模够大,简单加入 Prompt tokens 进行微调,就能取得很好的效果。
优点: 资源消耗比 Soft Prompt 小,容易收敛。
2. Soft Prompt
**定义:**Soft prompt 通常指的是一种较为宽泛或模糊的提示,允许模型在生成结果时有更大的自由度,通常用于启发模型进行创造性的生成。
缺点: 资源消耗大,参数都是随机初始化的,Loss 会有震荡。
python
from datasets import load_from_disk
from transformers import AutoTokenizer, AutoModelForCausalLM, DataCollatorForSeq2Seq
from transformers import pipeline, TrainingArguments, Trainer
from peft import PromptTuningConfig, get_peft_model, TaskType, PromptTuningInit, PeftModel

# 分词器
tokenizer = AutoTokenizer.from_pretrained("Langboat/bloom-1b4-zh")

# 函数内将instruction和response拆开分词的原因是:
# 为了便于mask掉不需要计算损失的labels, 即代码labels = [-100] * len(instruction["input_ids"]) + response["input_ids"]
def process_func(example):
    MAX_LENGTH = 256
    input_ids, attention_mask, labels = [], [], []
    instruction = tokenizer("\n".join(["Human: " + example["instruction"], example["input"]]).strip() + "\n\nAssistant: ")
    response = tokenizer(example["output"] + tokenizer.eos_token)
    input_ids = instruction["input_ids"] + response["input_ids"]
    attention_mask = instruction["attention_mask"] + response["attention_mask"]
    labels = [-100] * len(instruction["input_ids"]) + response["input_ids"]
    if len(input_ids) > MAX_LENGTH:
        input_ids = input_ids[:MAX_LENGTH]
        attention_mask = attention_mask[:MAX_LENGTH]
        labels = labels[:MAX_LENGTH]
    return {
        "input_ids": input_ids,
        "attention_mask": attention_mask,
        "labels": labels
    }

if __name__ == "__main__":
    # 加载数据集
    dataset = load_from_disk("./PEFT/data/alpaca_data_zh")

    # 处理数据
    tokenized_ds = dataset.map(process_func, remove_columns = dataset.column_names)
    # print(tokenizer.decode(tokenized_ds[1]["input_ids"]))
    # print(tokenizer.decode(list(filter(lambda x: x != -100, tokenized_ds[1]["labels"]))))

    # 创建模型
    model = AutoModelForCausalLM.from_pretrained("Langboat/bloom-1b4-zh", low_cpu_mem_usage=True)

    # 设置 Prompt-Tuning
    # Soft Prompt
    # config = PromptTuningConfig(task_type=TaskType.CAUSAL_LM, num_virtual_tokens=10) # soft_prompt会随机初始化
    # Hard Prompt
    config = PromptTuningConfig(task_type = TaskType.CAUSAL_LM,
                                prompt_tuning_init = PromptTuningInit.TEXT,
                                prompt_tuning_init_text = "下面是一段人与机器人的对话。", # 设置hard_prompt的具体内容
                                num_virtual_tokens = len(tokenizer("下面是一段人与机器人的对话。")["input_ids"]),
                                tokenizer_name_or_path = "Langboat/bloom-1b4-zh")
    model = get_peft_model(model, config) # 生成Prompt-Tuning对应的model
    print(model.print_trainable_parameters())

    # 训练参数
    args = TrainingArguments(
        output_dir = "/tmp_1203",
        per_device_train_batch_size = 1,
        gradient_accumulation_steps = 8,
        logging_steps = 10,
        num_train_epochs = 1
    )

    # trainer
    trainer = Trainer(
        model = model,
        args = args,
        train_dataset = tokenized_ds,
        data_collator = DataCollatorForSeq2Seq(tokenizer = tokenizer, padding = True)
    )

    # 训练模型
    trainer.train()

    # 模型推理
    model = AutoModelForCausalLM.from_pretrained("Langboat/bloom-1b4-zh", low_cpu_mem_usage=True)
    peft_model = PeftModel.from_pretrained(model = model, model_id = "/tmp_1203/checkpoint-500/")
    peft_model = peft_model.cuda()
    ipt = tokenizer("Human: {}\n{}".format("考试有哪些技巧?", "").strip() + "\n\nAssistant: ", return_tensors="pt").to(peft_model.device)
    print(tokenizer.decode(peft_model.generate(**ipt, max_length=128, do_sample=True)[0], skip_special_tokens=True))