Spark-SQL(四)

一 在Spark 环境下使用 Hive 功能,创建表、加载数据、查询数据以及进行数据转换

1 先将需要用的movie.txt文件放到Spark-SQL/input目录下
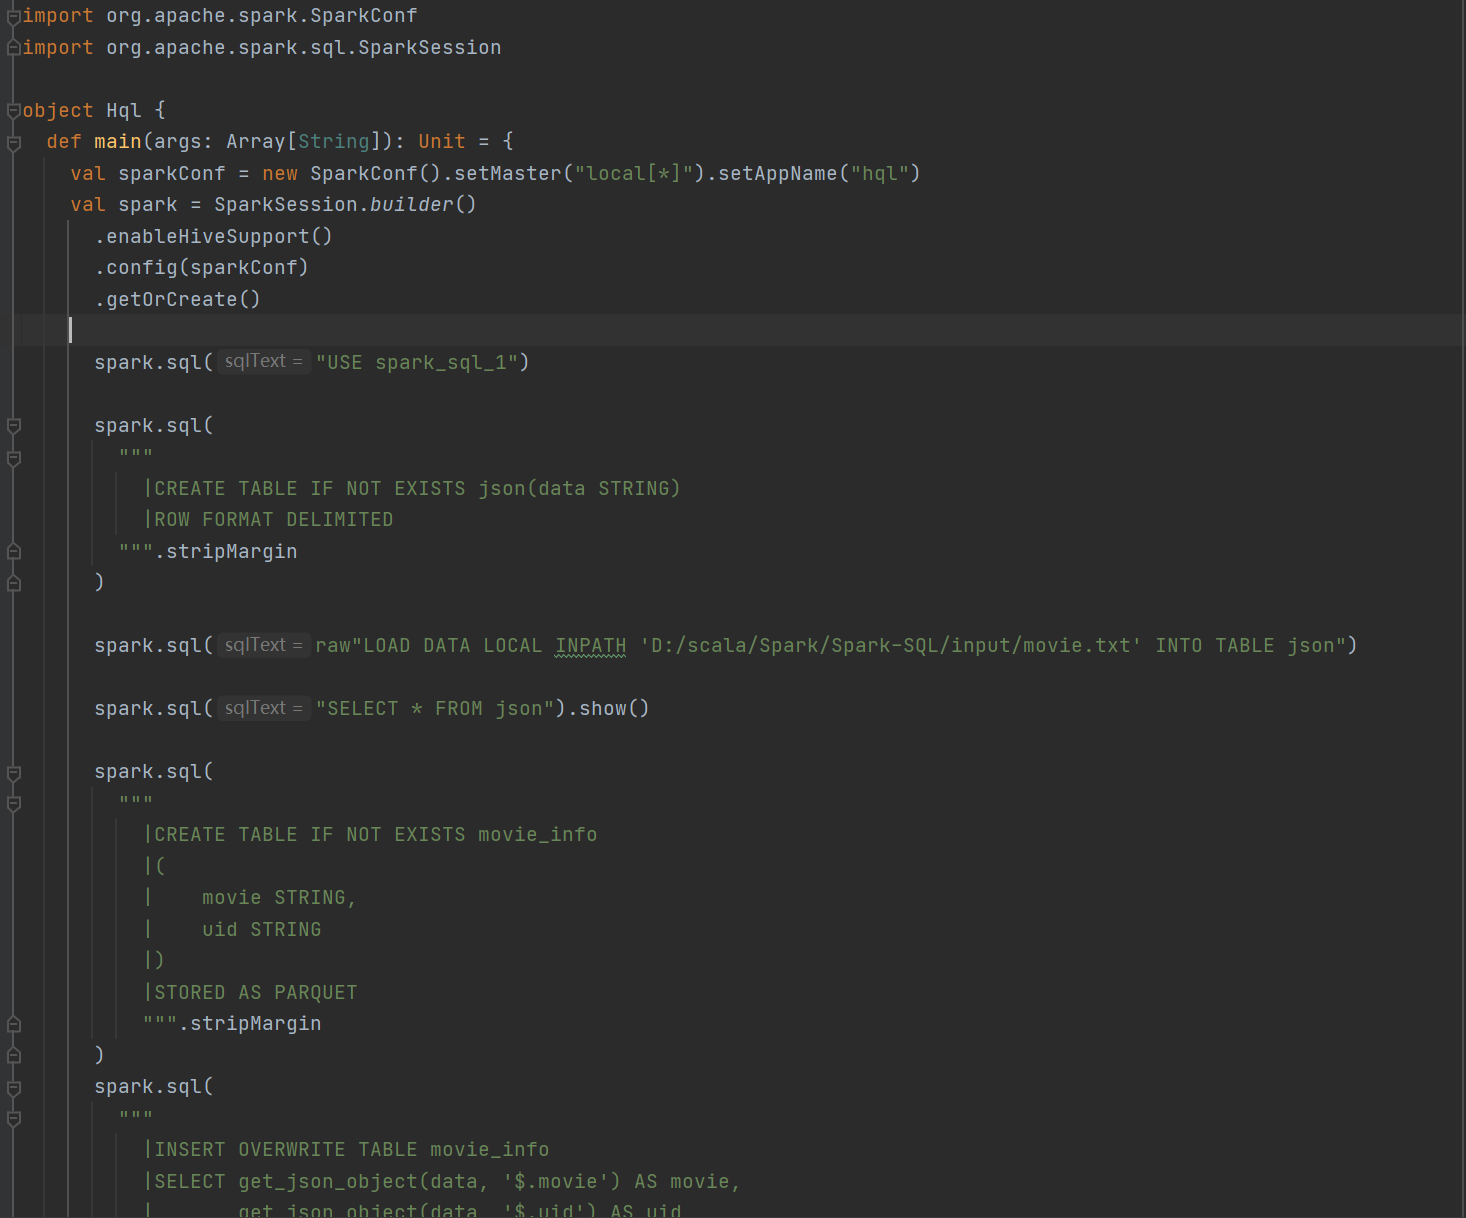
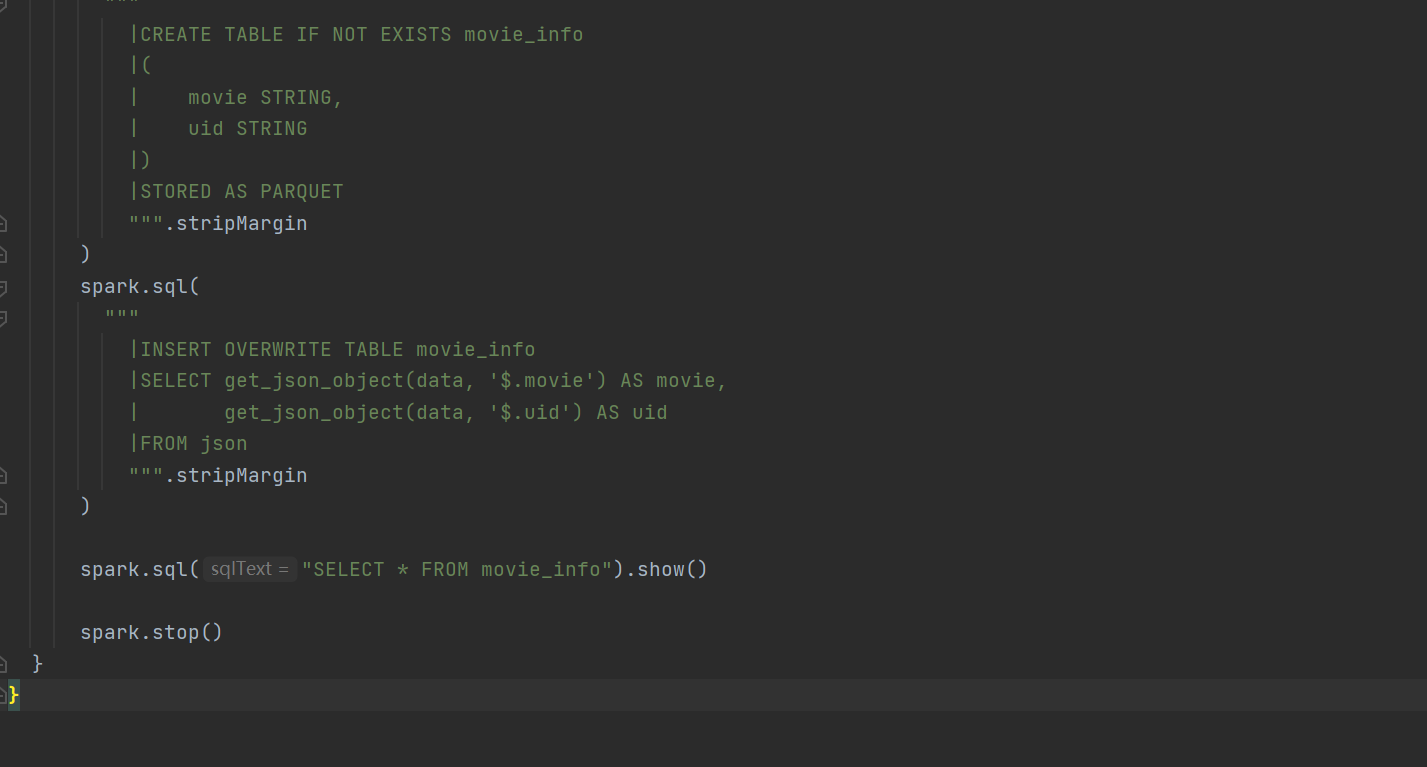
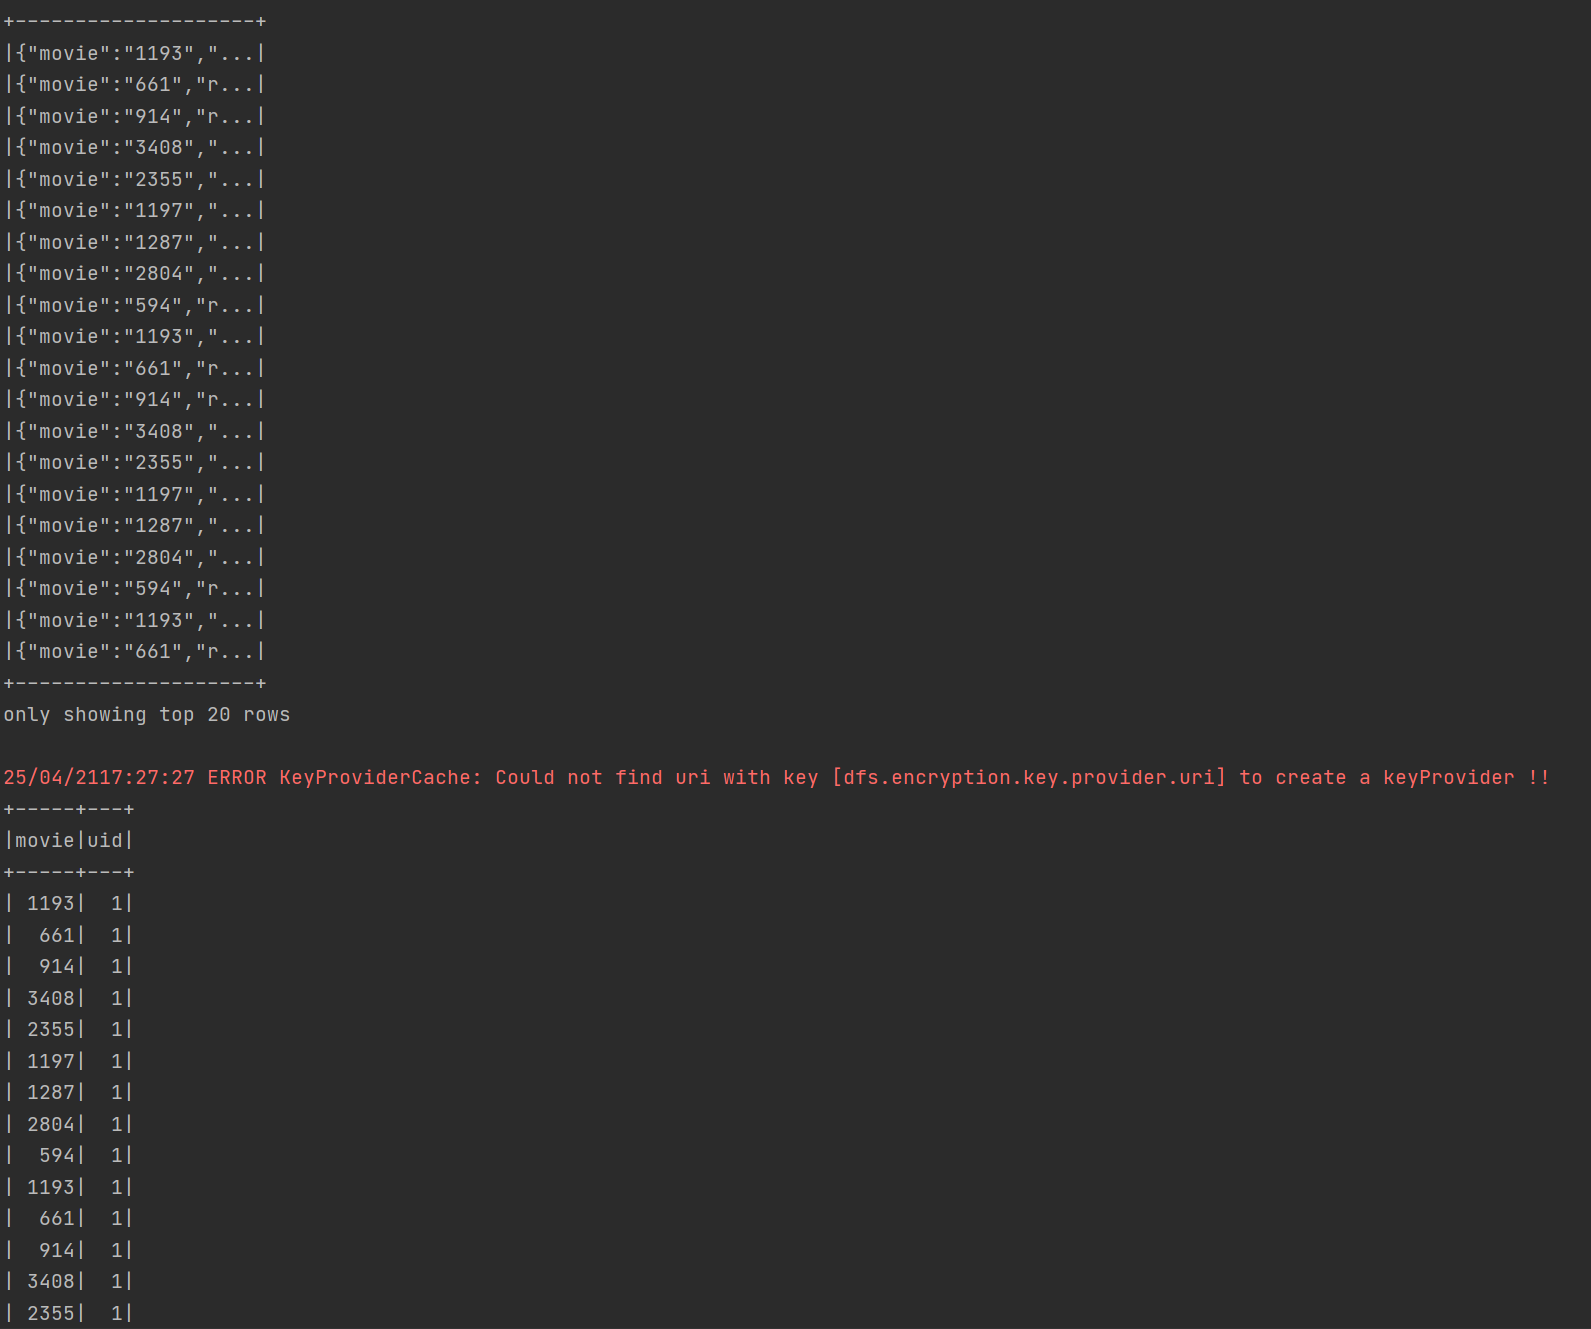
  1. 代码如图

1)进行数据转换,创建表、加载数据、查询数据进行数据转换

运行结果
二 spark-sql实验

实验内容:统计有效数据条数 及用户数量最多的前二十个地址。

实验过程:

1 先将需要用的user_login_info.json文件放到Spark-SQL/input目录下

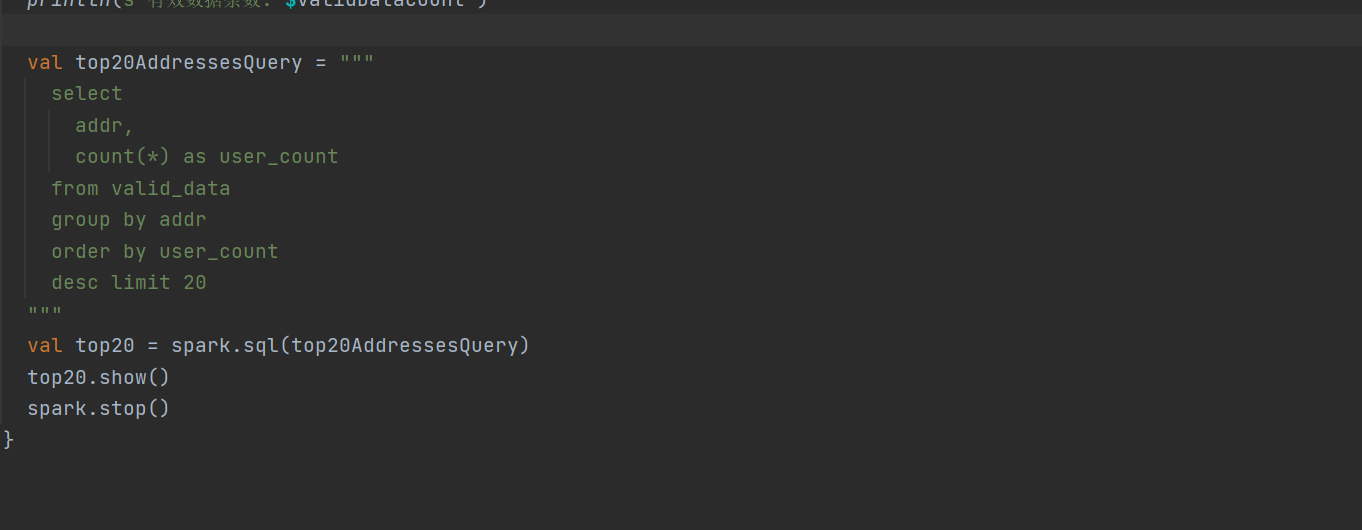
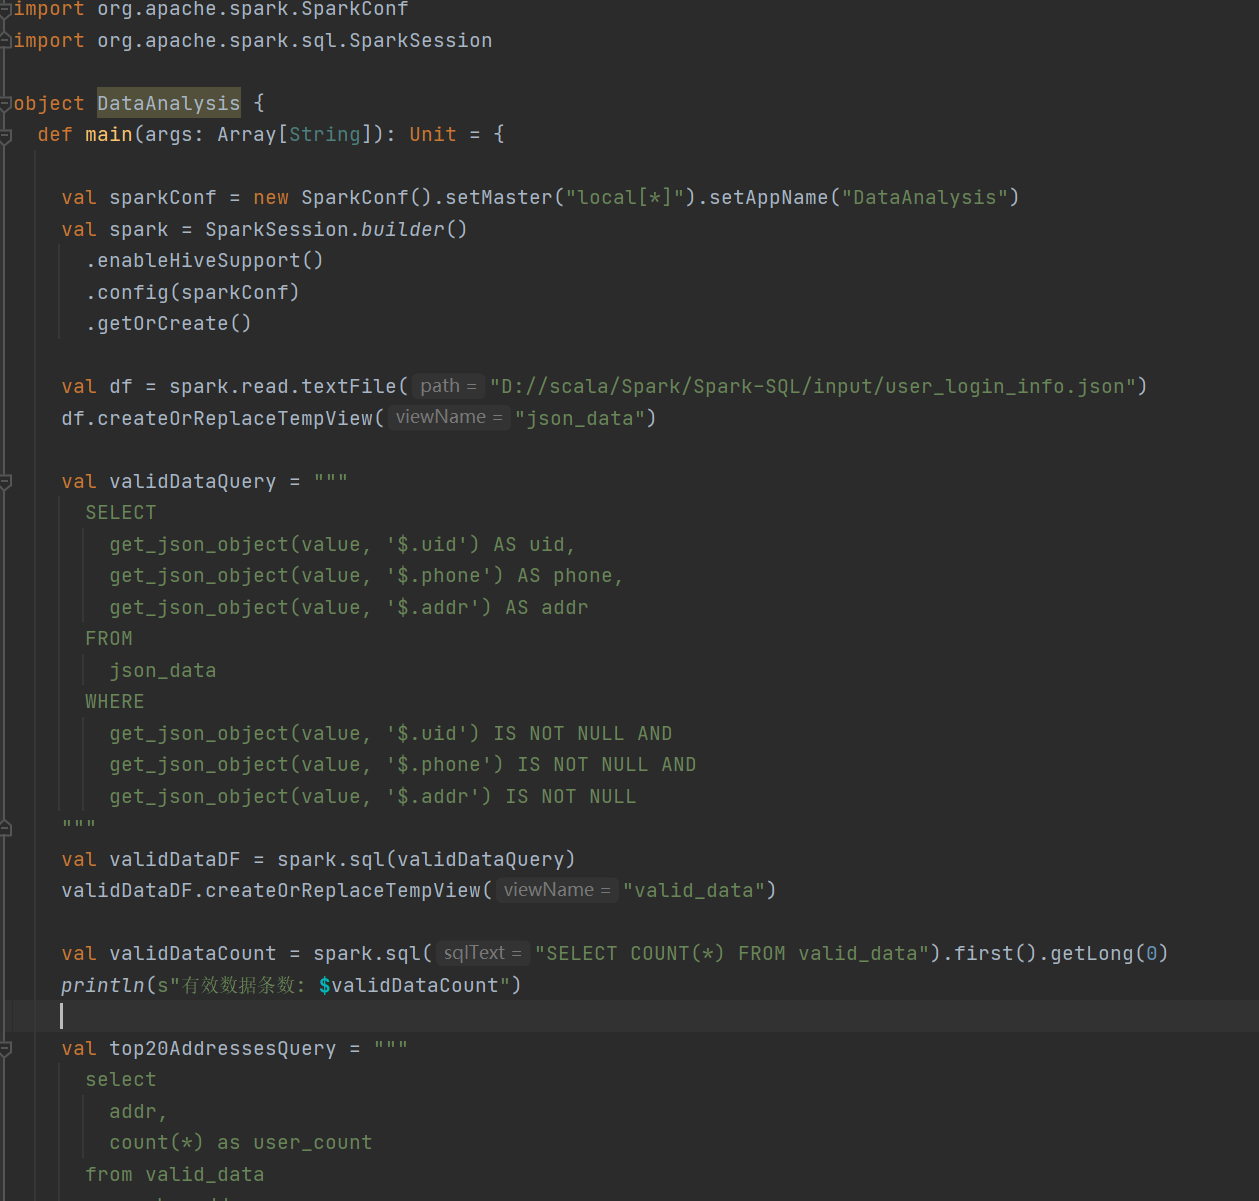
2 运行代码

统计有效数据条数及用户数量最多的前二十个地址。
运行结果
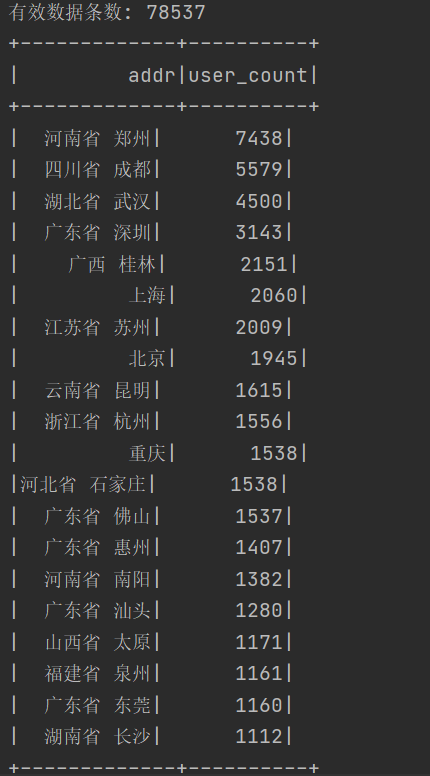
可以得到文件中有效的数据有78537条,以及用户数量最多的前二十个地址。

相关推荐
大大大大晴天2 小时前
每天认识一个组件:Apache StreamPark
大数据
演艺大赏6 小时前
NiFi 的权限模型不是 RBAC:users.xml、authorizers.xml 与组件级策略
大数据
yuanyuan3347 小时前
2026枣庄带检测报告伸缩门品牌测评|本地服务
大数据·数据库·人工智能·伸缩门
严肃小白兔8 小时前
Cloudflare Durable Objects 支持自动重试:分布式调用如何避免重复执行?
分布式
方方洛9 小时前
ray教程-27-附录F-RayClient与runtime_env与多语言
人工智能·分布式·机器学习
玖米GEO运营王总监9 小时前
2026年账号矩阵协同效应怎么量化:三个指标与公式结构
java·大数据·数据库
飞飞传输1 天前
飞驰云联文件交换建设方法论:从单点传输到持续治理
大数据·运维·安全
得帆低代码PaaS1 天前
企业级 Agent 架构:MCP、Integration、数据与治理能力
大数据·人工智能·架构·ai agent·企业数字化·mcp
阿里云大数据AI技术1 天前
EMR Serverless Ray:让 AI 推理融入数据处理
人工智能·spark