DStream创建(kafka数据源)
1.在idea中的 pom.xml 中添加依赖
<dependency>
    <groupId>org.apache.spark</groupId>
    <artifactId>spark-streaming-kafka-0-10_2.12</artifactId>
    <version>3.0.0</version>
</dependency>
2.创建一个新的object,并写入以下代码
import org.apache.kafka.clients.consumer.ConsumerConfig
import org.apache.kafka.common.serialization.StringDeserializer
import org.apache.spark.SparkConf
import org.apache.spark.streaming.dstream.InputDStream
import org.apache.spark.streaming.kafka010.{ConsumerStrategies, KafkaUtils, LocationStrategies}
import org.apache.spark.streaming.{Seconds, StreamingContext}
import org.apache.kafka.clients.consumer.ConsumerRecord

/**
 * 通过 DirectAPI 0 - 10 消费 Kafka 数据
 * 消费的 offset 保存在 _consumer_offsets 主题中
 */
object DirectAPI {
  def main(args: Array[String]): Unit = {
    val sparkConf = new SparkConf().setMaster("local[*]").setAppName("direct")
    val ssc = new StreamingContext(sparkConf, Seconds(3))

    // 定义 Kafka 相关参数
    val kafkaPara: Map[String, Object] = Map[String, Object](
      ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG -> "node01:9092,node02:9092,node03:9092",
      ConsumerConfig.GROUP_ID_CONFIG -> "kafka",
      "key.deserializer" -> classOf[StringDeserializer],
      "value.deserializer" -> classOf[StringDeserializer]
    )

    // 通过读取 Kafka 数据,创建 DStream
    val kafkaDStream: InputDStream[ConsumerRecord[String, String]] = KafkaUtils.createDirectStream[String, String](
      ssc,
      LocationStrategies.PreferConsistent,
      ConsumerStrategies.Subscribe[String, String](Set("kafka"), kafkaPara)
    )

    // 提取出数据中的 value 部分
    val valueDStream = kafkaDStream.map(record => record.value())

    // WordCount 计算逻辑
    valueDStream.flatMap(_.split(" "))
      .map((_, 1))
      .reduceByKey(_ + _)
      .print()

    ssc.start()
    ssc.awaitTermination()
  }
}
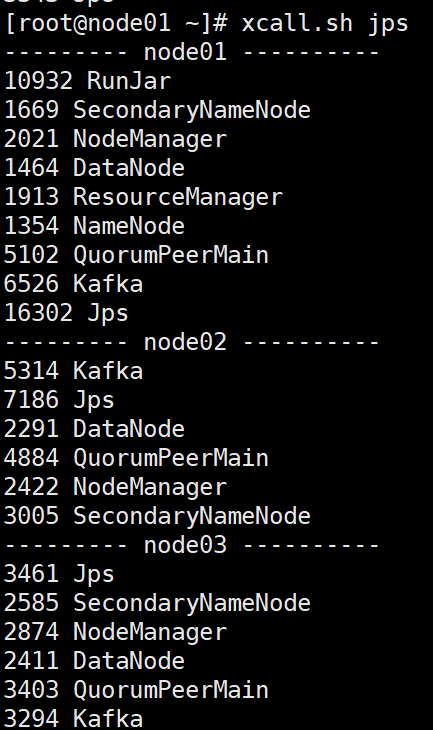
3.在虚拟机中,开启kafka、zookeeper、yarn、dfs集群
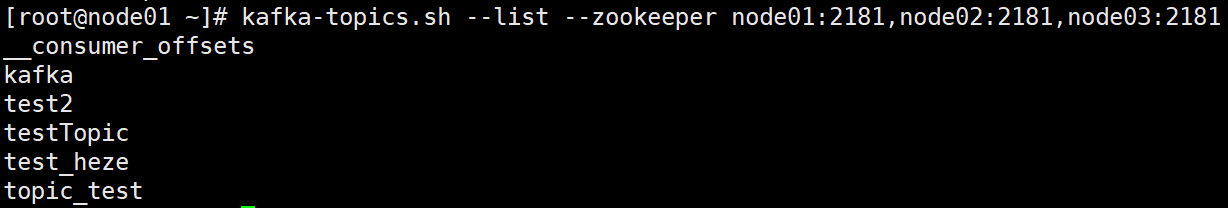
4.创建一个新的topic---kafka,用于接下来的操作

查看所有的topic(是否创建成功)
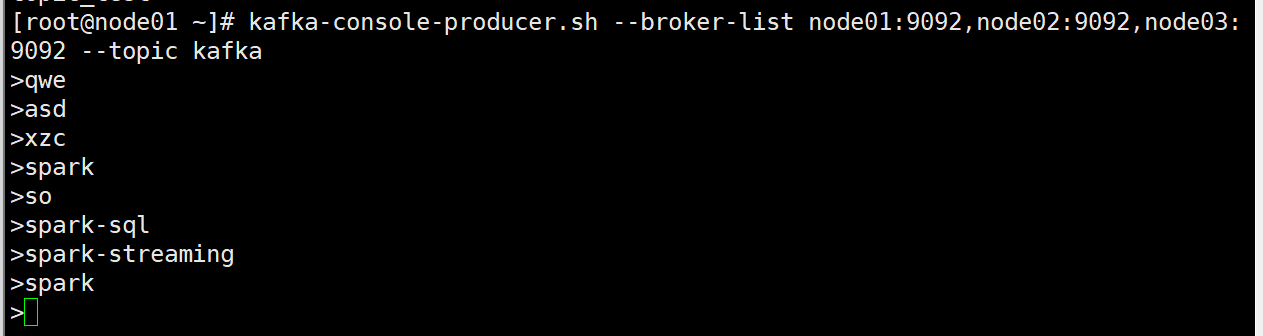
开启kafka生产者,用于产生数据

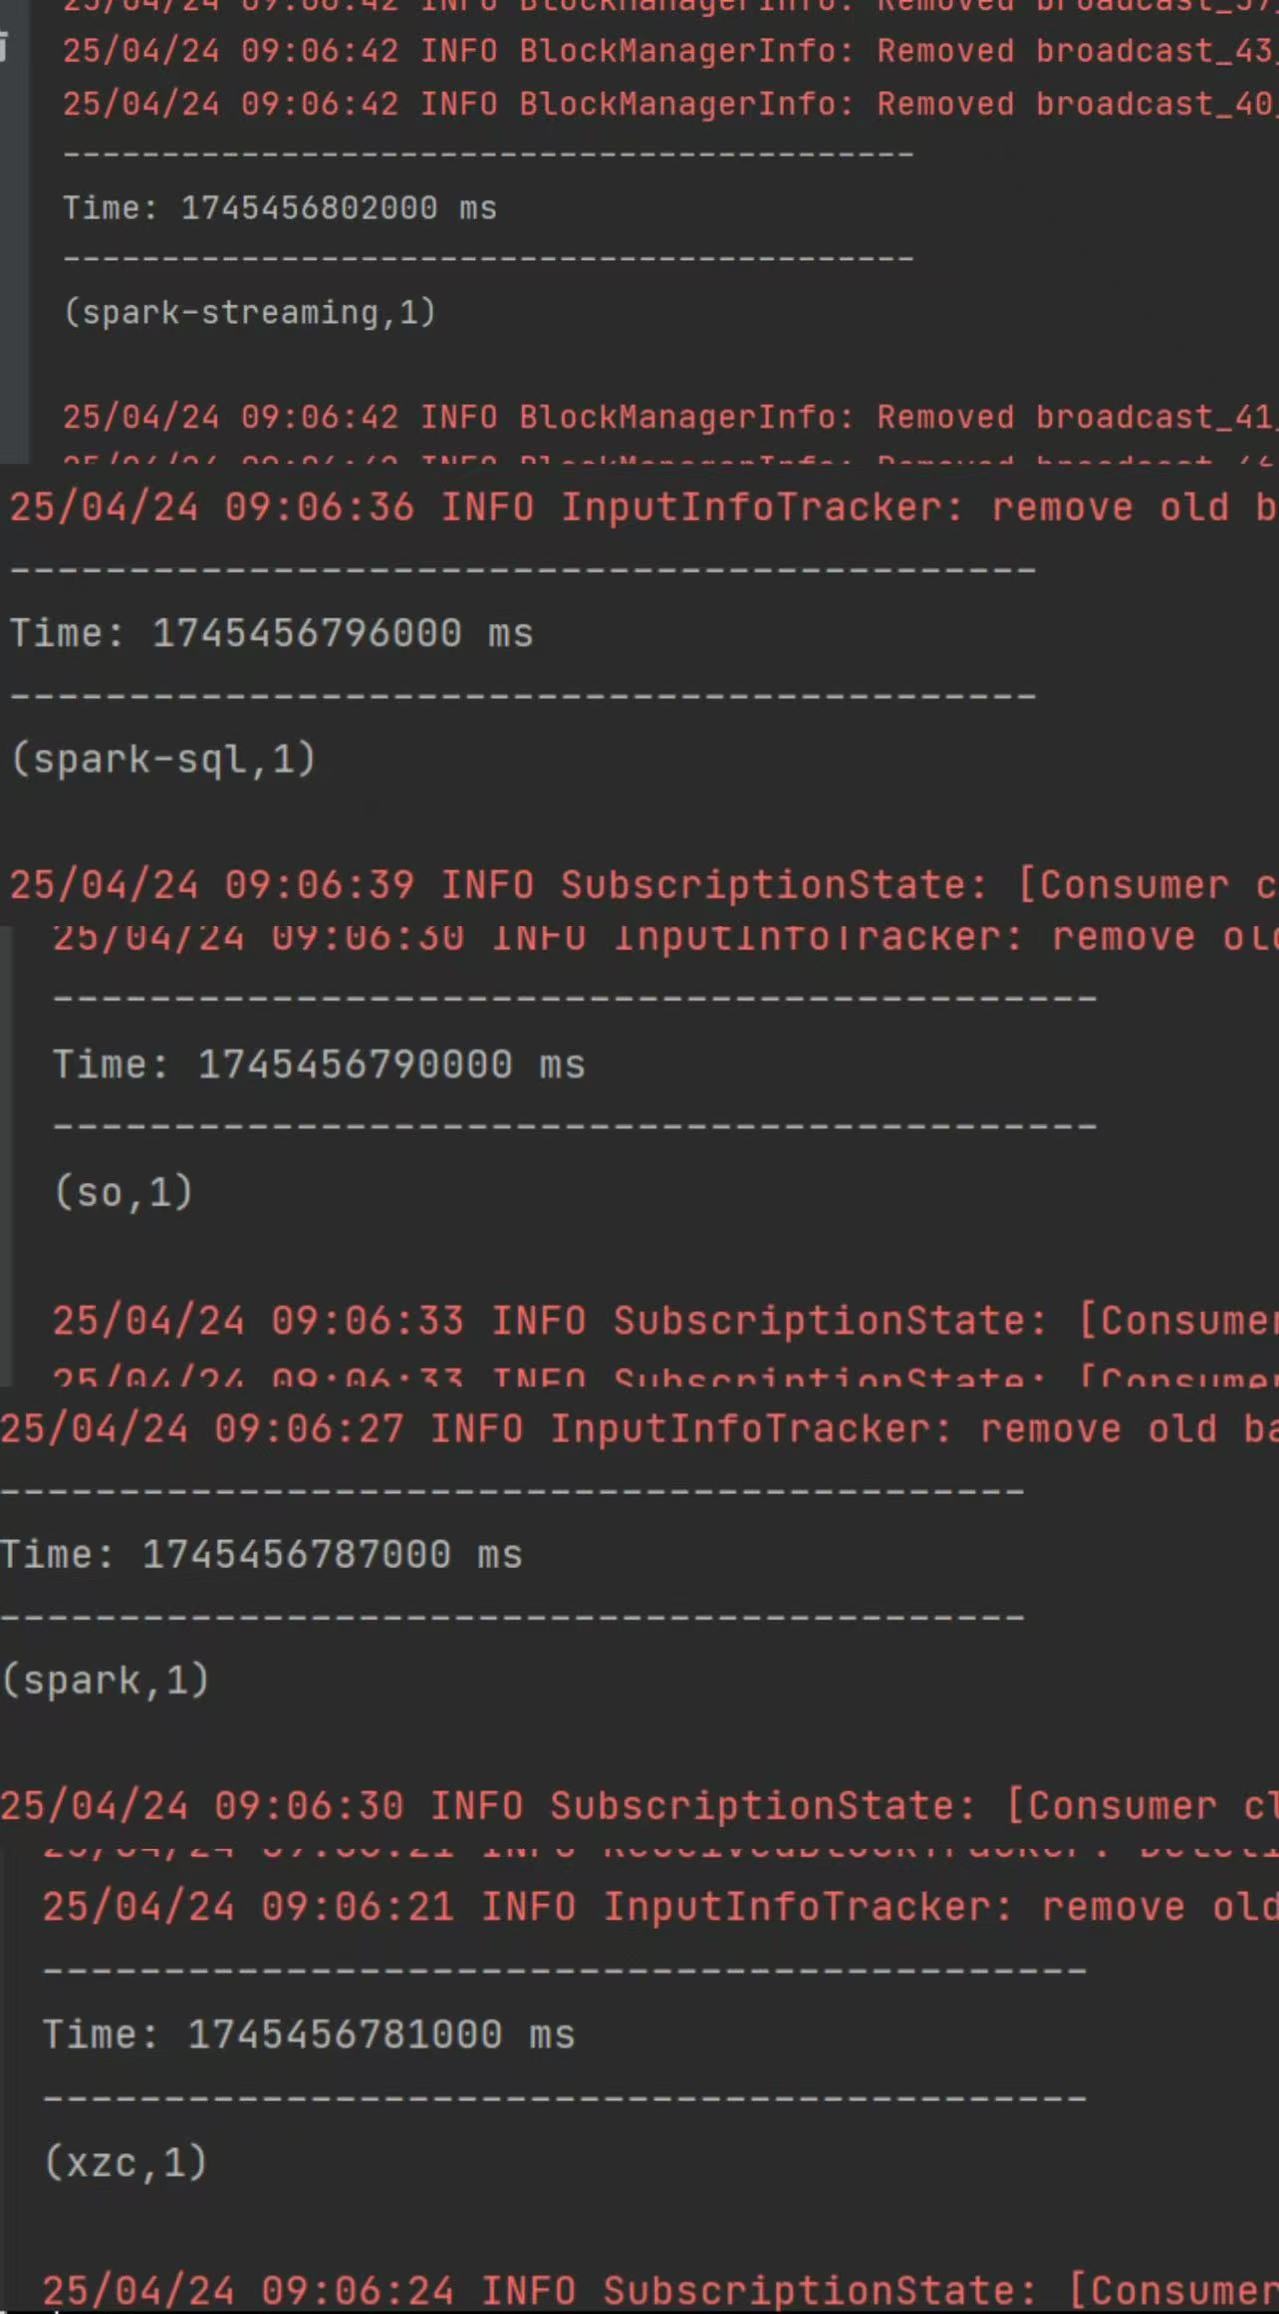
启动idea中的代码,在虚拟机中输入数据
输入后可以在idea中查看到
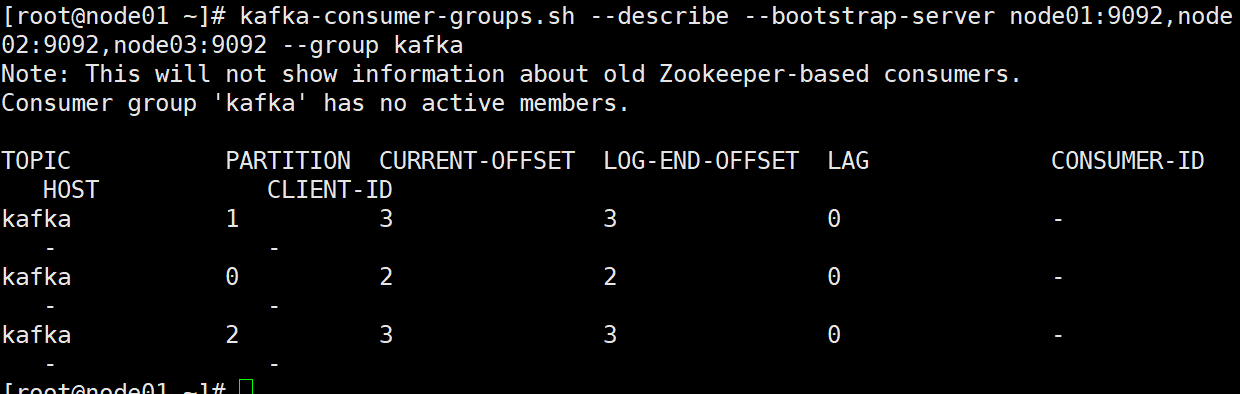
查看消费进度