DStream创建
Kafka数据源:
ReceiverAPI:需要一个专门的 Executor 去接收数据,然后发送给其他的 Executor 做计算。存在的问题,接收数据的 Executor 和计算的 Executor 速度会有所不同,特别在接收数据的 Executor速度大于计算的 Executor 速度,会导致计算数据的节点内存溢出。
DirectAPI:是由计算的 Executor 来主动消费 Kafka 的数据,速度由自身控制。
Kafka 0-10 Direct 模式
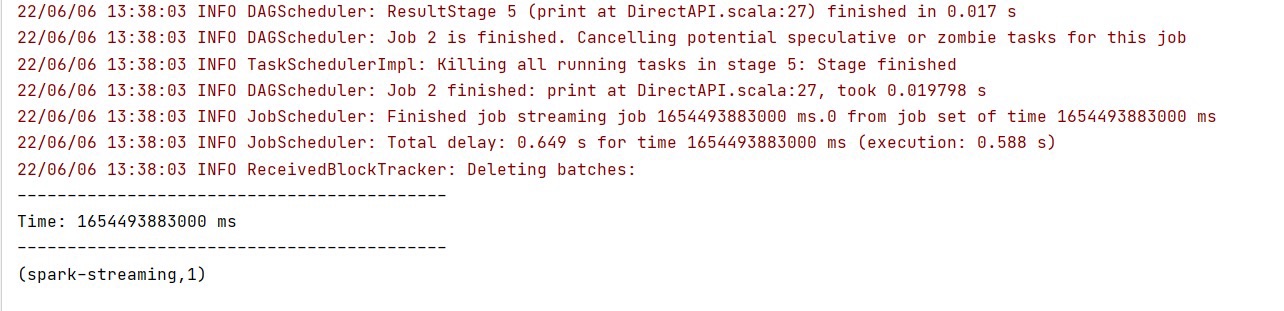
需求:通过 SparkStreaming 从 Kafka 读取数据,并将读取过来的数据做简单计算,最终打印到控制台。
导入依赖
<dependency>
<groupId>org.apache.spark</groupId>
<artifactId>spark-streaming-kafka-0-10_2.12</artifactId>
<version>3.0.0</version>
</dependency>
编写代码
/**
* 通过DirectAPI 0-10 消费kafka数据
* 消费的offset保存在_consumer_offsets主题中
*/
object DirectAPI {
def main(args: ArrayString): Unit = {
val sparkConf = new SparkConf().setMaster("local\*").setAppName("direct")
val ssc = new StreamingContext(sparkConf,Seconds(3))
//定义kafka相关参数
val kafkaPara :MapString,Object = MapString,Object(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG ->"node01:9092,node02:9092,node03:9092",
ConsumerConfig.GROUP_ID_CONFIG->"kafka",
"key.deserializer"->"org.apache.kafka.common.serialization.StringDeserializer",
"value.deserializer" -> "org.apache.kafka.common.serialization.StringDeserializer"
)
//通过读取kafka数据,创建DStream
val kafkaDStream:InputDStreamConsumerRecord\[String,String] = KafkaUtils.createDirectStreamString,String(
ssc,LocationStrategies.PreferConsistent,
ConsumerStrategies.SubscribeString,String(Set("kafka"),kafkaPara)
)
//提取出数据中的value部分
val valueDStream :DStreamString = kafkaDStream.map(record=>record.value())
//wordCount计算逻辑
valueDStream.flatMap(_.split(" "))
.map((_,1))
.reduceByKey(+)
.print()
ssc.start()
ssc.awaitTermination()
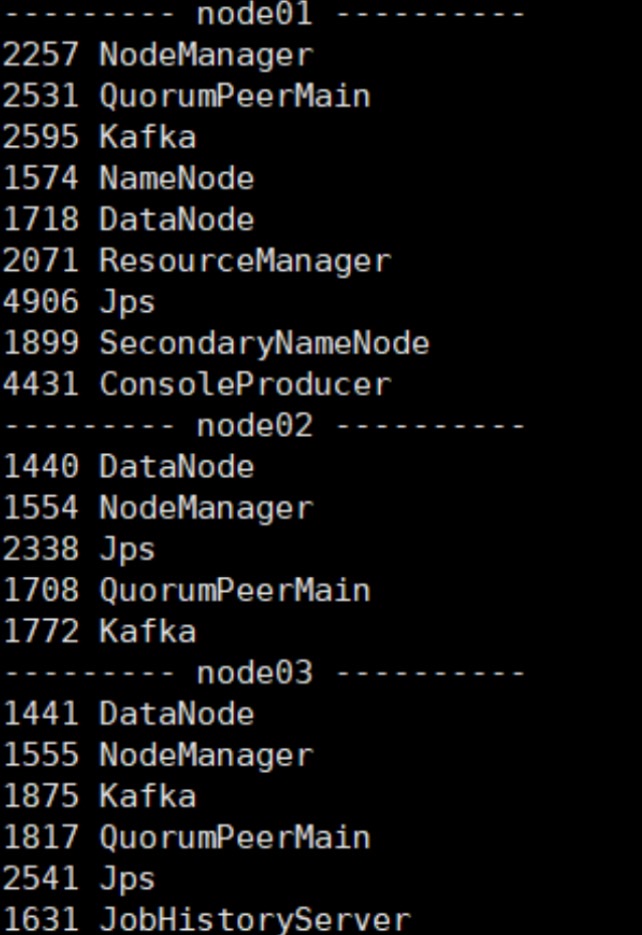
开启Kafka集群
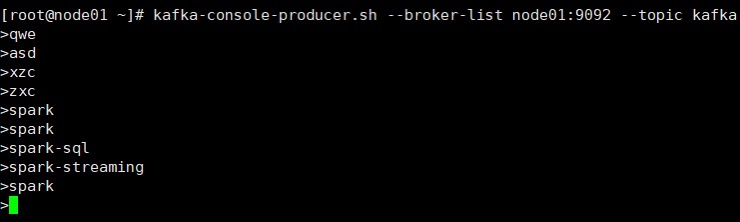
开启Kafka生产者,产生数据
kafka-console-producer.sh --broker-list node01:9092,node02:9092,node03:9092 --topic kafka
运行程序,接收Kafka生产的数据并进行相应处理
查看消费进度
kafka-consumer-groups.sh --describe --bootstrap-server node01:9092,node02:9092,node03:9092 --group kafka