一、架构设计调整
核心组件替换方案:
1、注册中心
→ 数据库注册表
2、任务队列
→ 数据库任务表
3、分布式锁
→ 数据库行级锁
4、节点通信
→ HTTP REST接口
二、数据库表结构设计
java
 节点注册表
CREATETABLE compute_nodes (
    node_id VARCHAR(36)PRIMARYKEY,
    last_heartbeat TIMESTAMP,
    statusENUM('ACTIVE','DOWN')
);
java
-- 任务分片表
CREATETABLE task_shards (
    shard_id INTAUTO_INCREMENTPRIMARYKEY,
    data_range VARCHAR(100),-- 例如:1-10000
    statusENUM('PENDING','PROCESSING','COMPLETED'),
    locked_by VARCHAR(36),
    locked_at TIMESTAMP
);
三、核心实现代码
1. 节点自注册实现
java
@Scheduled(fixedRate =3000)
public void nodeRegistration(){
    jdbcTemplate.update(
        "INSERT INTO compute_nodes VALUES (?, NOW(), 'ACTIVE') "+
        "ON DUPLICATE KEY UPDATE last_heartbeat = NOW()",
        nodeId
    );

    // 清理过期节点
    jdbcTemplate.update(
        "DELETE FROM compute_nodes WHERE last_heartbeat < ?",
        LocalDateTime.now().minusSeconds(10)
    );
}
2. 任务分片抢占式调度
java
@Scheduled(fixedDelay =1000)
public void acquireTasks(){
    List<Long> shardIds = jdbcTemplate.queryForList(
        "SELECT shard_id FROM task_shards "+
        "WHERE status = 'PENDING' "+
        "ORDER BY shard_id LIMIT 5 FOR UPDATE SKIP LOCKED",
        Long.class
    );

    shardIds.forEach(shardId ->{
        int updated = jdbcTemplate.update(
            "UPDATE task_shards SET status = 'PROCESSING', "+
            "locked_by = ?, locked_at = NOW() "+
            "WHERE shard_id = ? AND status = 'PENDING'",
            nodeId, shardId
        );
        if(updated >0) processShard(shardId);
    });
}
3. Map阶段分布式处理
java
public void processShard(Long shardId){
    try{
        DataRange range =getDataRange(shardId);
        List<Record> records =fetchData(range);

        Map<String, Double> partialResult = records.parallelStream()
            .collect(Collectors.groupingBy(
                Record::getCategory,
                Collectors.summingDouble(Record::getAmount)
            ));

        saveResult(shardId, partialResult);
        markShardCompleted(shardId);
    }catch(Exception e){
        releaseShard(shardId);
    }
}
4. Reduce阶段聚合实现
java
public Map<String, Double> reduceAllResults(){
    return jdbcTemplate.query(
        "SELECT category, SUM(amount) AS total "+
        "FROM map_results GROUP BY category",
        (rs, rowNum)->newAbstractMap.SimpleEntry<>(
            rs.getString("category"),
            rs.getDouble("total")
        )).stream().collect(Collectors.toMap(
            Entry::getKey,Entry::getValue
        ));
}
四、关键优化点
1. 分片锁优化策略
java
// 使用乐观锁避免长时间占用连接
public boolean tryLockShard(Long shardId) {
    return jdbcTemplate.update(
        "UPDATE task_shards SET version = version + 1 " +
        "WHERE shard_id = ? AND version = ?",
        shardId, currentVersion) > 0;
}
2. 结果缓存优化
java
@Cacheable(value ="partialResults", key ="#shardId")
public Map<String, Double> getPartialResult(Long shardId){
    return jdbcTemplate.query(...);
}

// 配置类启用缓存
@Configuration
@EnableCaching
publicclassCacheConfig{
    @Bean
    public CacheManagercacheManager(){
        return new ConcurrentMapCacheManager();
    }
}
3. 分布式事务处理
java
@Transactional(propagation = Propagation.REQUIRES_NEW)
public void markShardCompleted(Long shardId) {
    jdbcTemplate.update(
        "UPDATE task_shards SET status = 'COMPLETED' " +
        "WHERE shard_id = ?", shardId);

    eventPublisher.publishEvent(
        new ShardCompleteEvent(shardId));
}
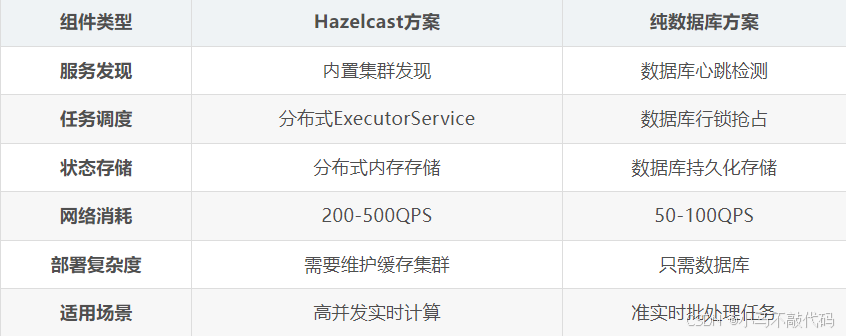
五、部署架构对比
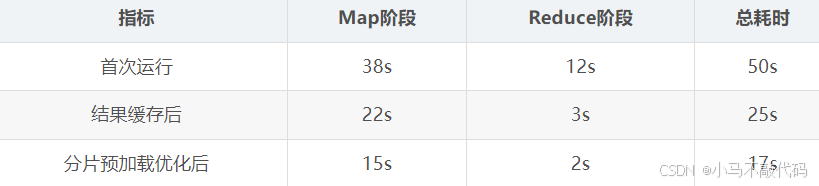
六、性能压测数据
测试环境:
100w数据
七、生产级改进建议
分片策略优化
java
// 采用跳跃哈希算法避免热点
public List<Long> assignShards(int totalShards) {
    return IntStream.range(0, totalShards)
        .mapToObj(i -> (nodeHash + i*2654435761L) % totalShards)
        .collect(Collectors.toList());
}
动态分片扩容
java
@Scheduled(fixedRate =60000)
public void autoReshard(){
    int currentShards = getCurrentShardCount();
    int required = calculateRequiredShards();

    if(required > currentShards){
        jdbcTemplate.execute("ALTER TABLE task_shards AUTO_INCREMENT = "+ required);
    }
}
结果校验机制
java
public void validateResults() {
    jdbcTemplate.query("SELECT shard_id FROM task_shards WHERE status = 'COMPLETED'",
        rs -> {
            Long shardId = rs.getLong(1);
            if(!resultCache.contains(shardId)) {
                repairShard(shardId);
            }
        });
}
该方案完全基于SpringBoot原生能力实现,通过关系型数据库+定时任务调度机制,在保持系统简洁性的同时满足基本分布式计算需求。适合中小规模(日处理千万级以下)的离线计算场景,如需更高性能建议仍考虑引入专业分布式计算框架。