概述
本代码实现了一个基于PyTorch的图像特征提取与分类模型训练流程。核心功能包括:
使用预训练ResNet18模型进行图像特征提取
将提取的特征保存为标准化格式
基于提取的特征训练分类模型
代码结构详解
1. 库导入
python
import torch
import torch.nn as nn
import torchvision
from torchvision import transforms, datasets
from torch.utils.data import DataLoader, Subset
import numpy as np
import os
from ml.model_trainer import ModelTrainer-
关键库说明:
-
torch:PyTorch核心库 -
torch.nn:神经网络模块 -
torchvision:计算机视觉专用模块 -
numpy:数值计算库 -
os:文件系统操作 -
ModelTrainer:自定义模型训练类(需另行实现)
-
2. 特征提取器类(FeatureExtractor)
初始化方法 __init__
python
def __init__(self):
    self.device = torch.device("cuda" if torch.cuda.is_available() else "cpu")
    self.model = torchvision.models.resnet18(weights='IMAGENET1K_V1')
    self.model = nn.Sequential(*list(self.model.children())[:-1])
    self.model = self.model.to(self.device).eval()
self.transform = transforms.Compose([...])-
功能说明:
-
设备检测:自动选择GPU/CPU
-
模型加载:使用ImageNet预训练的ResNet18
-
模型修改:移除最后的全连接层(保留卷积特征提取器)
-
预处理设置:标准化图像尺寸和颜色空间
-
特征提取方法 extract_features
python
def extract_features(self, data_dir):
    full_dataset = datasets.ImageFolder(...)
    loader = DataLoader(...)

    features = []
    labels = []
    with torch.no_grad():
        for inputs, targets in loader:
            inputs = inputs.to(self.device)
            outputs = self.model(inputs)
            features.append(outputs.squeeze().cpu().numpy())
            labels.append(targets.numpy())

    features = np.concatenate(...)
    labels = np.concatenate(...)
return features, labels, full_dataset.classes-
关键参数:
-
data_dir:包含分类子目录的图像数据集路径 -
batch_size=32:平衡内存使用与处理效率 -
num_workers=4:多线程数据加载
-
-
处理流程:
-
创建ImageFolder数据集
-
使用DataLoader批量加载
-
禁用梯度计算加速推理
-
特征维度压缩(squeeze)
-
设备间数据传输(GPU->CPU)
-
合并所有批次数据
-
3. 主执行流程
参数配置
python
DATA_DIR = "/home/.../data"  # 实际数据路径
SAVE_PATH = "./features.npz"  # 特征保存路径
特征提取与保存
python
extractor = FeatureExtractor()
if not os.path.exists(SAVE_PATH):
    features, labels, classes = extractor.extract_features(DATA_DIR)
    np.savez(SAVE_PATH, features=features, labels=labels, classes=classes)
else:
    data = np.load(SAVE_PATH)
    features = data['features']
labels = data['labels']-
文件结构:
-
features: N_samples, 512 的特征矩阵
-
labels: N_samples 的标签数组
-
classes: 类别名称列表
-
模型训练与保存
python
X, y = features, labels
trainer = ModelTrainer()
model = trainer.train_model(X, y)
joblib.dump(model, 'pest_classifier.pkl')-
假设条件:
-
ModelTrainer需实现训练逻辑(如SVM、随机森林等)
-
默认使用全部数据进行训练(建议实际添加数据分割)
-
技术细节说明
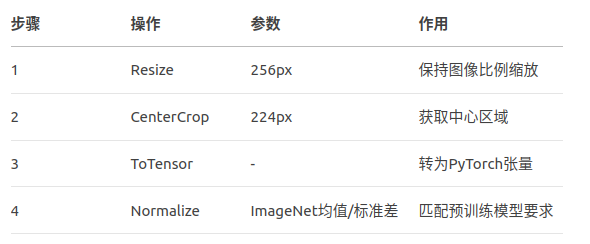
1. 图像预处理流程
2. 特征维度分析
-
ResNet18最后层输出:512维特征向量
-
假设1000张图像:
-
原始图像:1000×3×224×224 (约150MB)
-
提取特征:1000×512 (约2MB) → 显著降维
-
3. 性能优化策略
-
GPU加速:自动检测CUDA设备
-
批量处理:32张/批平衡效率与内存
-
缓存机制:避免重复特征提取
-
梯度禁用:减少内存消耗