通义千问Qwen3全面解析:最强开源大模型+Ollama本地运行实战
🔥 最新重大好消息! 经过漫长的等待,今天凌晨阿里云正式发布了Qwen3大语言模型 !本次更新带来了0.6b 1.7b 4b 8b 14b 30b 32b 235b超大参数模型,更实现了推理速度翻倍 与多语言能力突破,堪称开源LLM领域的里程碑事件!
访问官方github -> https://github.com/QwenLM/Qwen3
简介
Qwen3是阿里云推出的新一代大规模语言模型(LLM),基于混合专家架构(MoE)和动态注意力机制设计,支持多模态输入、长上下文处理及复杂任务推理。本文将从核心特性 、性能表现 、部署方案 到实战体验全面解析Qwen3的技术亮点,并结合Ollama工具演示其轻量化部署效果。
核心特性
1. 混合推理模式(快思考 & 慢思考)
| 模式 | 特点 |
|---|---|
| 快思考 | 低延迟响应,适合简单问答或指令执行(如"翻译"、"总结")。 |
| 慢思考 | 多步链式推理能力,支持数学证明、代码调试等复杂任务(通过enable_thinking=True切换)。 |
2. 超大规模预训练数据
- 36万亿token 训练数据量,覆盖 119种语言 和 STEM领域知识(如编程、物理公式)。
- 数据增强:通过Qwen2.5-Math/Coder生成合成数据,提升专业场景泛化能力。
3. 多样化模型架构
| 模型类型 | 示例 | 参数规模 | 适用场景 |
|---|---|---|---|
| Dense模型 | Qwen3-8B、Qwen3-32B | 全参数激活 | 通用文本生成/对话 |
| MoE模型 | Qwen3-235B-A22B、Qwen3-30B-A3B | 动态参数激活 | 高性能低资源消耗场景 |
4. 技术突破
- 动态注意力机制:自动识别关键信息并调整权重分配。
- 混合架构设计:融合树状神经网络(逻辑推理)与Transformer(语义理解)。
- MCP协议支持:优化多Agent协作效率。
性能表现
1. 基准测试领先
| 模型 | 代码生成 | 数学推理 | 通用能力 | 激活参数 |
|---|---|---|---|---|
| Qwen3-235B-A22B | SOTA | SOTA | SOTA | 220B |
| Qwen3-30B-A3B | ≈Grok-3 | ≈Gemini | ≈GPT-4o | 30B |
| Qwen3-4B | >LLaMA3-70B | 中等水平 | 高 | 4B |
2. 低资源高效推理
- MoE模型仅需 10%激活参数 即可达到Dense模型性能,显著降低GPU显存占用。
应用场景
| 场景 | 技术实现 |
|---|---|
| 复杂任务处理 | 数学证明(慢思考模式)、代码调试(长上下文优化)。 |
| 实时交互 | 客服对话(快思考模式)、快速问答(低延迟响应)。 |
| 多语言服务 | 支持119种语言,适配国际化业务需求。 |
| Agent系统集成 | 通过Qwen-Agent框架简化工具调用,构建自动化工作流。 |
部署方案
1. 云端部署
- 阿里云平台 :提供一键API调用(如
dashscopeSDK)。 - 第三方平台:Fireworks AI、Hyperbolic等支持模型托管。
2. 本地部署
bash
# 安装依赖
pip install transformers torch

# 下载Qwen3-14B模型
from transformers import AutoModelForCausalLM, AutoTokenizer
model = AutoModelForCausalLM.from_pretrained("Qwen/Qwen3-14B", device_map="auto")
tokenizer = AutoTokenizer.from_pretrained("Qwen/Qwen3-14B")

# 推理示例
input_text = "请解释相对论的核心原理"
inputs = tokenizer(input_text, return_tensors="pt").to("cuda")
outputs = model.generate(**inputs, max_new_tokens=200)
print(tokenizer.decode(outputs[0], skip_special_tokens=True))
Ollama使用Qwen3-14B
1. 轻量化部署实践
通过Ollama工具,Qwen3-14B可在普通PC端实现高效运行:
安装步骤
bash
# 注意首次没有安装Ollama要先安装。
# 拉取Qwen3-14B模型
ollama pull qwen3:14B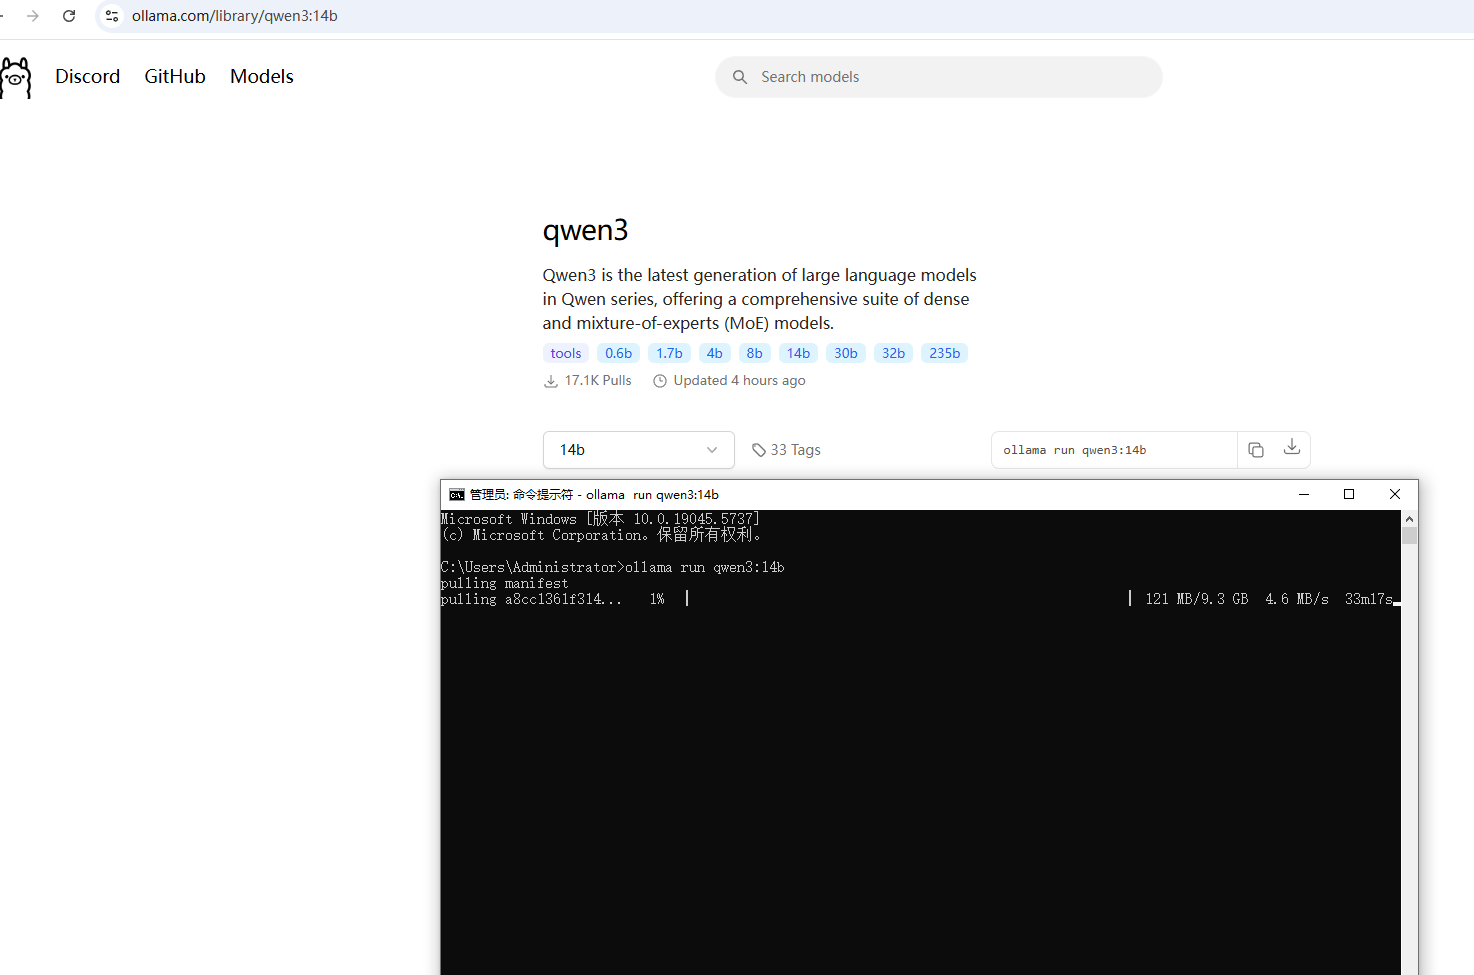
调用API
python
import ollama

response = ollama.chat(model='qwen3:14B', messages=[
  {
    'role': 'user',
    'content': '请用Python实现一个快速排序算法'
  },
])
print(response['message']['content'])
2. 实测效果对比
| 工具 | 响应时间 | 显存占用 | 代码准确性 |
|---|---|---|---|
| Ollama+Qwen3-14B | <2s | ~12GB | 高 |
| GPT-4o | ~1s | N/A | 高 |
| LLaMA3-70B | >5s | ~140GB | 中 |
优势:Ollama通过量化压缩和内存优化,使14B模型在消费级硬件上稳定运行,性价比远超同类方案。
行业意义
- 技术竞争 :Qwen3在开源领域首次实现 220B MoE模型 的高性能推理,挑战闭源模型统治地位。
- 生态构建:通过开源策略和Agent能力,推动AI在电商、云计算、内容创作等领域的规模化落地。
总结
Qwen3标志着大语言模型进入"混合推理时代",通过灵活架构设计和高效资源利用,为学术研究和工业应用提供了全新范式。结合Ollama工具,开发者可轻松实现高性能模型的本地化部署,加速AI技术普及。