Decoder
Decoder结构介绍
-
Transformer Decoder是Transformer模型的核心生成组件,负责基于编码器输出和已生成内容预测后续token。通过堆叠多层结构相同的解码层(Decoder Layer),每层包含自注意力机制、编码器-解码器注意力机制和前馈神经网络,实现序列生成的上下文感知。
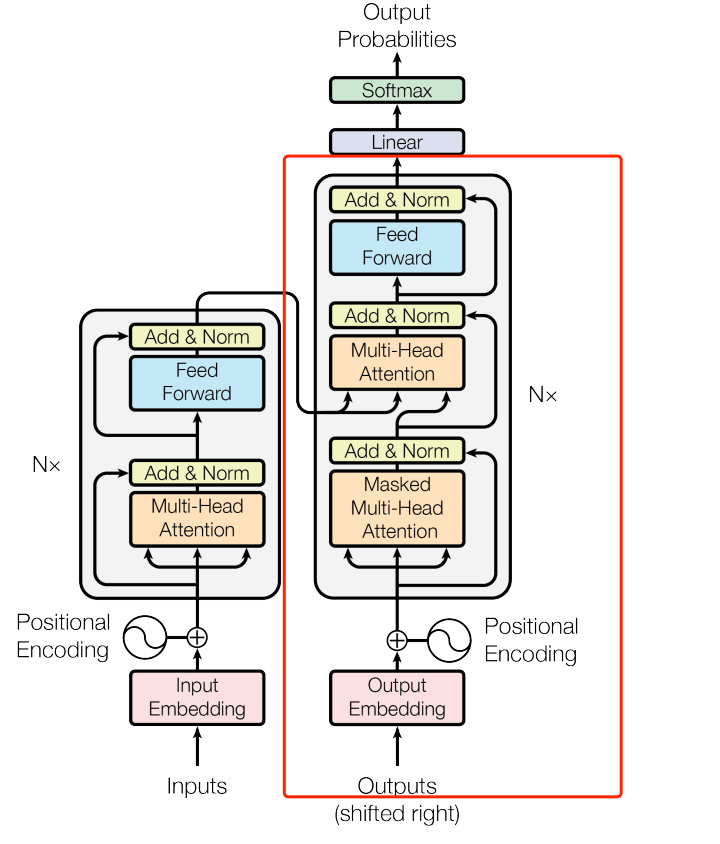
实现上图红色框中的整个Decoder结构
主要组件包含:
- 词嵌入层:将目标序列token映射为连续向量
- 位置编码:加入自回归生成的位置信息
- 多层解码层:通过三类注意力机制进行上下文建模
数学流程
-
解码器的计算过程可形式化为:
Embedding : Y e m b e d = Embedding ( Y i n p u t ) PositionEncode : Y p o s = Y e m b e d + PositionEncoding ( s e q _ l e n ) DecoderLayers : H o u t = LayerNorm ( FFN ( EncDec-Attn ( Self-Attn ( Y p o s ) ) ) ) \begin{aligned} \text{Embedding} &: Y_{embed} = \text{Embedding}(Y_{input}) \\ \text{PositionEncode} &: Y_{pos} = Y_{embed} + \text{PositionEncoding}(seq\len) \\ \text{DecoderLayers} &: H{out} = \text{LayerNorm}( \text{FFN}( \text{EncDec-Attn}( \text{Self-Attn}(Y_{pos}) ) ) ) \end{aligned} EmbeddingPositionEncodeDecoderLayers:Yembed=Embedding(Yinput):Ypos=Yembed+PositionEncoding(seq_len):Hout=LayerNorm(FFN(EncDec-Attn(Self-Attn(Ypos))))每个解码层(DecoderLayers)包含:
- 带掩码的多头自注意力(Masked Multi-Head Self-Attention)
- 编码器-解码器注意力(Encoder-Decoder Attention)
- 前馈神经网络(Feed-Forward Network)
- 三次残差连接 + 层归一化
代码实现
-
其他层的实现
层名 链接 PositionEncoding https://blog.csdn.net/hbkybkzw/article/details/147431820 calculate_attention https://blog.csdn.net/hbkybkzw/article/details/147462845 MultiHeadAttention https://blog.csdn.net/hbkybkzw/article/details/147490387 FeedForward https://blog.csdn.net/hbkybkzw/article/details/147515883 LayerNorm https://blog.csdn.net/hbkybkzw/article/details/147516529 EncoderLayer https://blog.csdn.net/hbkybkzw/article/details/147591824 Encoder https://blog.csdn.net/hbkybkzw/article/details/147616115 DecoderLayer https://blog.csdn.net/hbkybkzw/article/details/147616556 下面统一在before.py中导入
-
实现 transformer 解码器 Decoder
pythonimport torch from torch import nn from before import PositionEncoding,calculate_attention,MultiHeadAttention,FeedForward,LayerNorm,DecoderLayer class Decoder(nn.Module): def __init__(self, vocab_size, padding_idx, d_model, n_heads, ffn_hidden, dropout_prob=0.1, num_layers=6, max_seq_len=512): super(Decoder, self).__init__() # 词嵌入层(含padding掩码) self.embedding = nn.Embedding( num_embeddings=vocab_size, embedding_dim=d_model, padding_idx=padding_idx ) # 位置编码器 self.position_encode = PositionEncoding( d_model=d_model, max_seq_len=max_seq_len ) # 解码层堆叠 self.decode_layers = nn.ModuleList([ DecoderLayer( n_heads=n_heads, d_model=d_model, ffn_hidden=ffn_hidden, dropout_prob=dropout_prob ) for _ in range(num_layers) ]) def forward(self, x, encoder_kv, dst_mask=None, src_dst_mask=None): # 输入形状: [batch_size, tgt_seq_len] embed_x = self.embedding(x) # 词向量映射 pos_encode_x = self.position_encode(embed_x) # 位置编码 # 逐层处理(携带编码器输出) for layer in self.decode_layers: pos_encode_x = layer( x=pos_encode_x, encoder_kv=encoder_kv, dst_mask=dst_mask, src_dst_mask=src_dst_mask ) return pos_encode_x # 输出形状: [batch_size, tgt_seq_len, d_model]关键组件说明:
- 双注意力机制:每层包含自注意力和编码器-解码器注意力
- 掩码控制 :
dst_mask:防止解码时看到未来信息(三角掩码)src_dst_mask:控制编码器-解码器注意力范围
- 信息融合:将编码器输出作为Key/Value供解码器查询
-
维度变化
处理阶段 张量形状变化示例 原始输入 batch_size, tgt_seq_len 词嵌入层输出 batch_size, tgt_seq_len, d_model 位置编码 batch_size, tgt_seq_len, d_model 编码器输出 batch_size, src_seq_len, d_model 解码层输出 batch_size, tgt_seq_len, d_model
使用示例
-
测试用例
pythonif __name__ == "__main__": # 模拟输入:batch_size=4,目标序列长度32 y = torch.randint(0, 100, (4, 32)) # 编码器输出:batch_size=4,源序列长度64,维度512 encoder_out = torch.randn(4, 64, 512) decoder = Decoder(vocab_size=100,padding_idx=0,d_model=512,n_heads=8,ffn_hidden=2048,num_layers=6,max_seq_len=51) out = decoder(y, encoder_out) print("输入形状:", y.shape) print("编码器输出形状:", encoder_out.shape) print("解码器输出形状:", out.shape) -
参数解释
参数名 典型值 作用描述 vocab_size 30000 目标语言词表大小 padding_idx 0 指定padding token的索引 d_model 512 模型隐藏层维度 n_heads 8 注意力头数量 ffn_hidden 2048 前馈网络中间层维度 num_layers 6 解码层堆叠数量 max_seq_len 512 支持的最大序列长度 encoder_kv - 编码器输出,用于交叉注意力计算 dst_mask - 目标序列自注意力掩码(三角形) src_dst_mask - 源-目标序列交叉注意力掩码