Spark,HDFS客户端操作

hadoop客户端环境准备

找到资料包路径下的Windows依赖文件夹,拷贝hadoop-3.1.0到非中文路径(比如d:\hadoop-3.1.0)

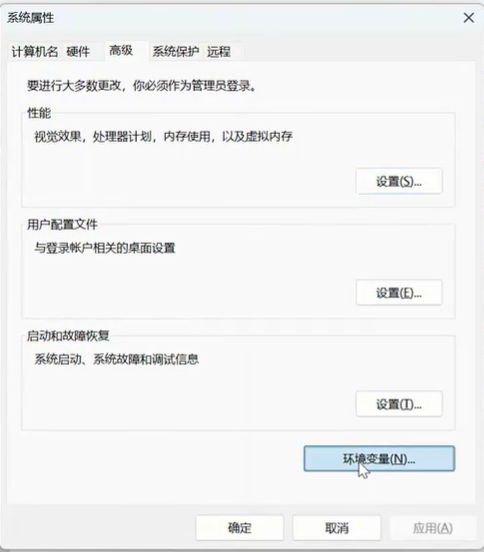
++①++打开环境变量
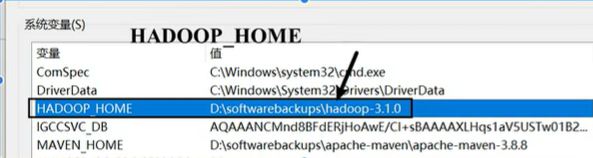
++②++在下方系统变量中新建HADOOP_HOME环境变量,值就是保存hadoop的目录。
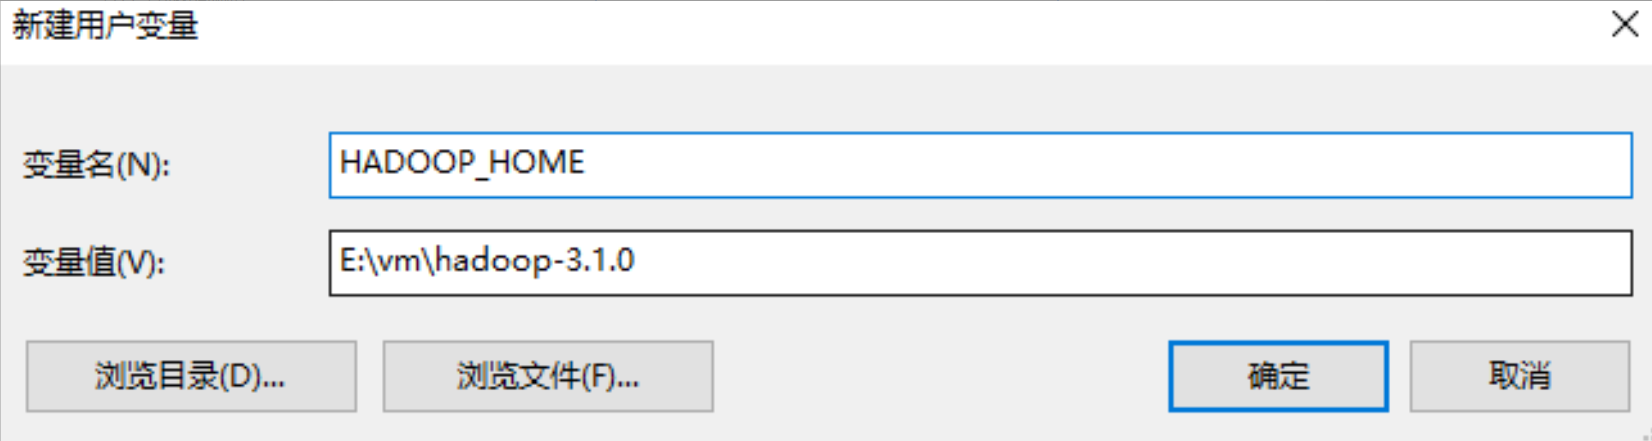
效果如下:
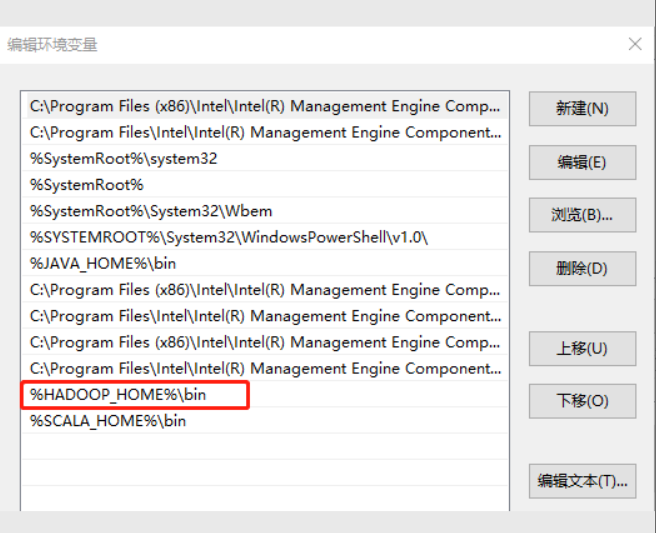
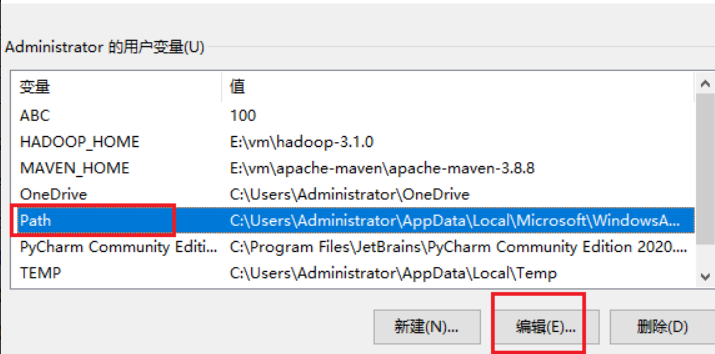
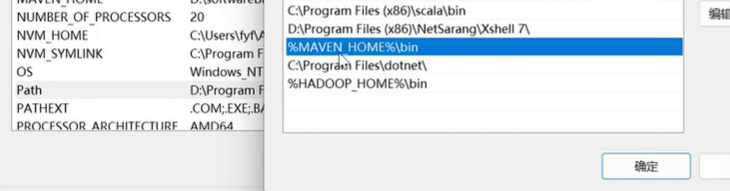
++③++配置Path环境变量。
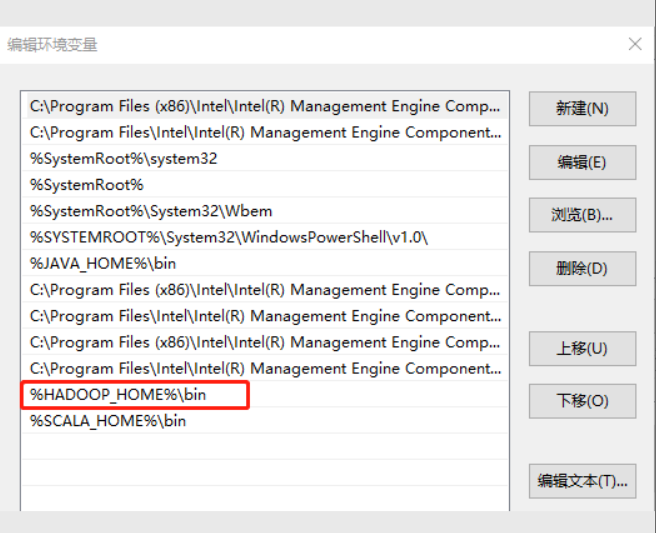
++④++新建一项
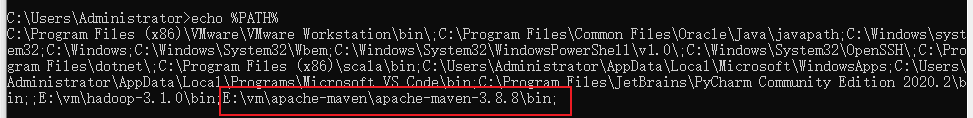
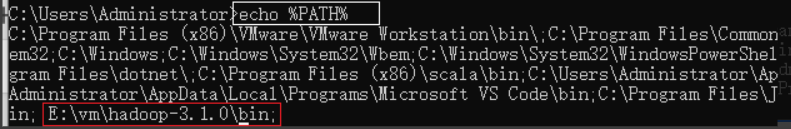
++⑤++打开电脑终端验证Hadoop环境变量是否正常
Maven的配置同上
相关推荐
wuyk5552 小时前
Spider-第11讲-工程化改造与可维护性
大数据·爬虫·elasticsearch·搜索引擎
墨林陌3 小时前
AI 热点日报(2026-11-16):黄仁勋或重返英伟达,华为发具身世界模型,ChatGPT Wallet打通支付
大数据
starzy19904 小时前
Structured Streaming 结构化流概述:把流数据当作一张无限增长的表
大数据·spark
wuyk5554 小时前
Spider-第12讲-asyncio异步并发爬取
大数据·爬虫·elasticsearch·搜索引擎
筑梦之人5 小时前
Elasticsearch 9.x 从入门到精通(4/7):聚合分析与文本分析
大数据·elasticsearch·jenkins
数字新视界15 小时前
信创动环监控在机房环境管理中的智能化应用与实践分析
大数据·人工智能·物联网·信息与通信·动环监控系统
大大大大晴天19 小时前
数仓分层架构设计:ODS、DWD、DWS、ADS、DIM 如何各司其职
大数据
东鸿电子Eastron1 天前
工厂节能降本落地指南:从精准能源计量搭建数字化管理基础
大数据·人工智能·能源·智能电表·能耗管理
吾AI科技1 天前
基于Tez引擎的 Hive SQL 性能优化 —— 为什么脚本运行越来越慢
大数据·hive·性能优化·tez
P1Browser2 天前
账号触发平台安全审核?拆解标准申诉流程与材料清单
大数据·人工智能·安全·多账号管理·指纹浏览器·账户安全·运营合规