将temperature.log中的气象数据导入到Hive的temperature表中,
根据气象站id分组计算每个气象站30年来的*最高*气温,
然后将统计结果导出到MySQL当中。
思路:
1.在hive中创建表
2.数据导入到表中
3.计算后的结果写入另外的表
4.用sqoop导出到mysql
1.在hive中创建表
hive

hive> create database if not exists temperature_db;

hive> use temperature_db;

hive> create table temperature_tb(id int,year string,temperature string) row format delimited fields terminated by ',';
2.数据导入到表中
先上传文件到虚拟机,然后输入load data local inpath... into命令加载数据到数据库。
load data local inpath '/home/hadoop/temperature.log' into table temperature_tb;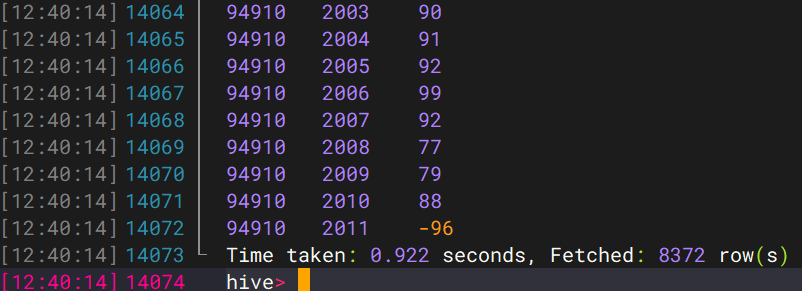
3.计算后的结果写入另外的表
CREATE TABLE temperature_max_by_id AS
SELECT id, MAX(temperature) AS max_temperature
FROM temperature_tb
WHERE `year` >= STRING(YEAR(CURRENT_DATE()) - 30)
GROUP BY id;
DESCRIBE FORMATTED temperature_db.temperature_max_by_id;
可以查看表在hdfs中的位置。
4.使用 Sqoop 导出到 MySQL
注意:要提前在mysql中创建表
USE temperature_db; CREATE TABLE IF NOT EXISTS temperature (id INT, max_temperature VARCHAR(50));
~/sqoop/bin/sqoop export \
  --connect jdbc:mysql://localhost/temperature_db \
  --username root \
  --password 123456 \
  --table temperature \
  --export-dir /user/hive/warehouse/temperature_db.db/temperature_max_by_id \
  --input-fields-terminated-by ',' \
  -m 1