Hive实战任务 - 9.5 实现网址去重

文章目录

  • [1. 实战概述](#1. 实战概述)
  • [2. 实战步骤](#2. 实战步骤)
  • [3. 实战总结](#3. 实战总结)

1. 实战概述

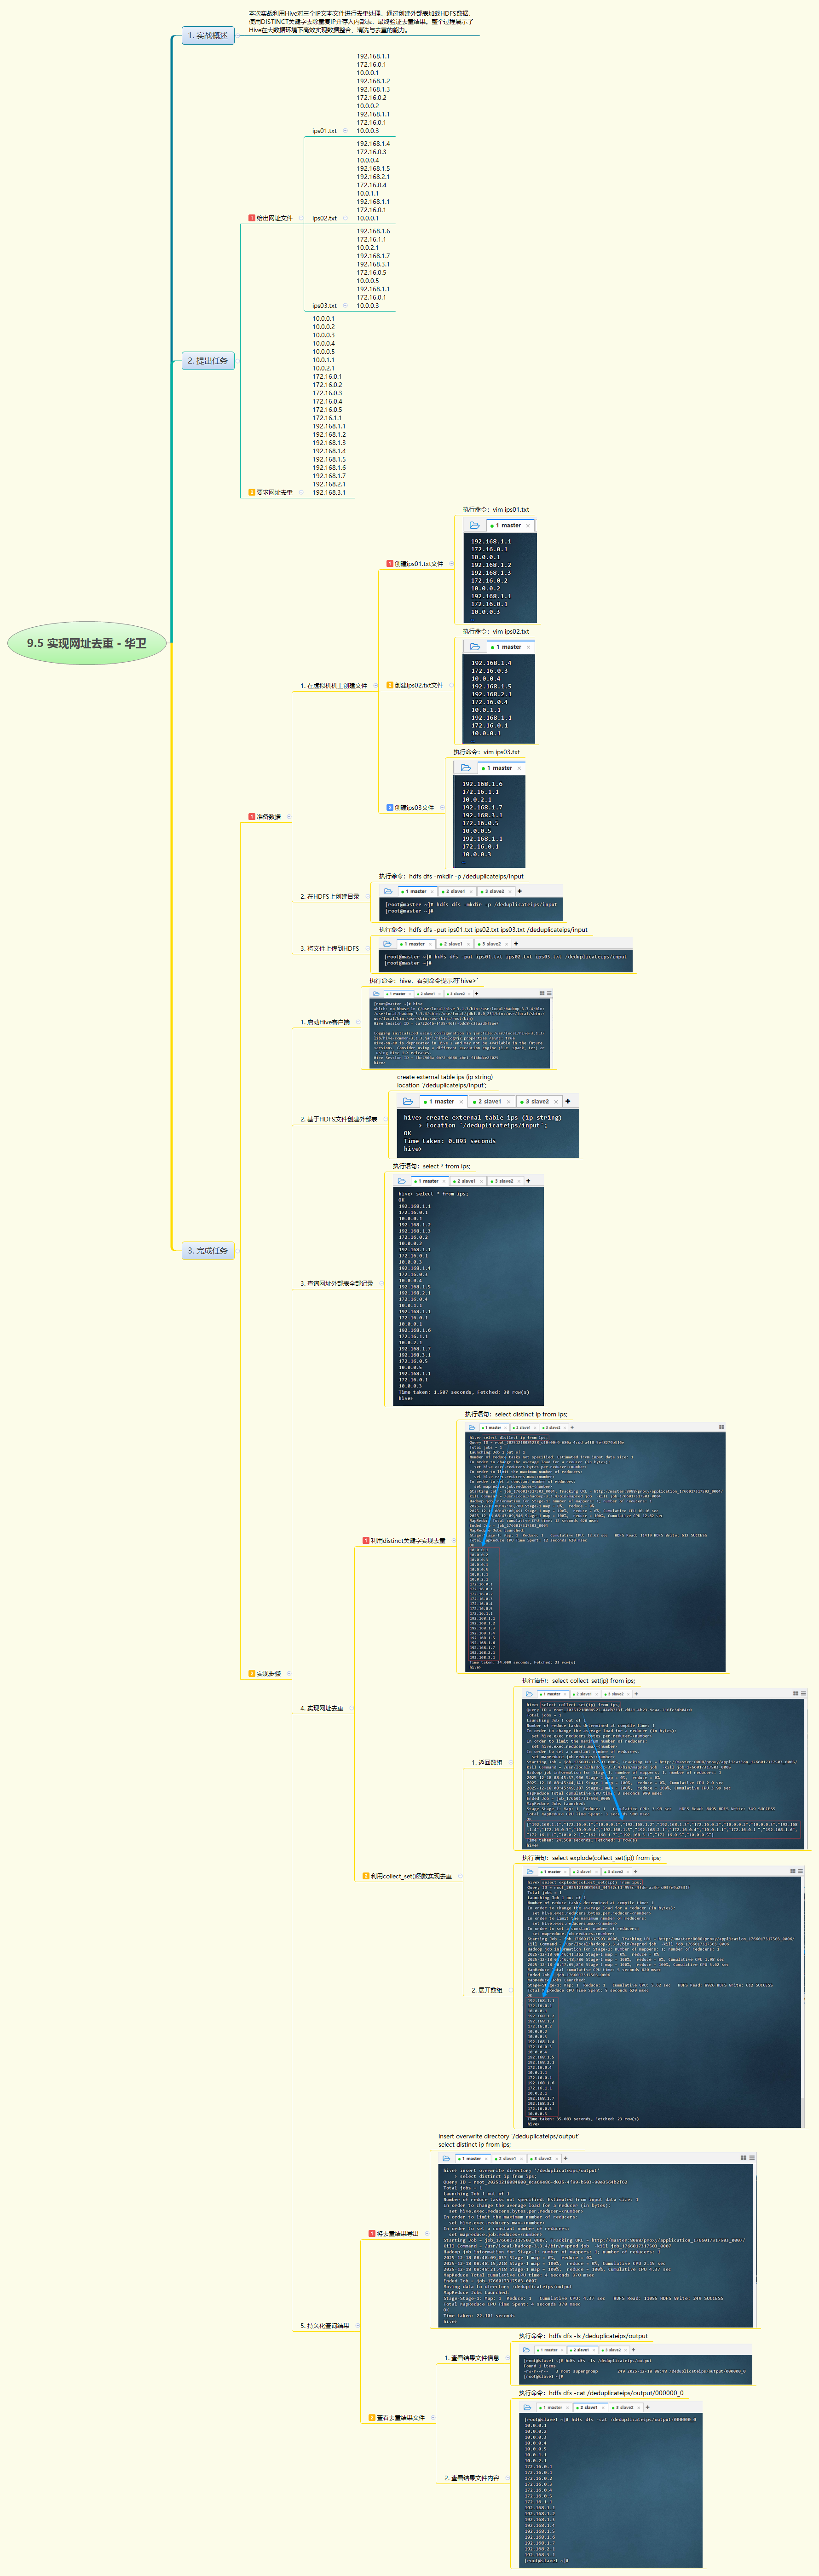
  • 本实战通过Hive对三个含重复IP的文本文件进行去重处理,创建外部表加载HDFS数据,使用DISTINCT或collect_set+explode实现去重,并将唯一IP列表持久化至HDFS输出目录,完整展示了Hive在大数据清洗与去重场景中的高效应用。

2. 实战步骤
3. 实战总结

  • 本次实战聚焦于IP地址去重任务,系统完成了从数据准备到结果输出的全流程。首先将三个包含重复IP的本地文件上传至HDFS,创建外部表ips直接映射目录数据;随后通过SELECT DISTINCT ip快速获取唯一IP集合,同时对比使用collect_set(ip)聚合函数生成无重复数组,并结合explode展开为行,验证了多种去重方法的可行性;最终利用INSERT OVERWRITE DIRECTORY将去重结果导出至HDFS指定路径,便于下游系统使用。整个过程体现了Hive在数据整合、清洗和去重方面的简洁性与高效性,尤其适用于日志分析、用户行为追踪等需处理海量重复标识的场景,为大数据预处理提供了可靠的技术路径。
相关推荐
freejackman4 天前
【工程化】从“单兵作战”到“多引擎架构”:基于门面模式的重构实战
大数据·数据库·hive·sql·测试工具·设计模式·架构
skywalk81637 天前
hive 常驻集群:像 OSPF 一样在线,像 git 一样可信
运维·人工智能·hive
Francek Chen8 天前
【大数据处理与分析】数据仓库Hive:09 Hive 编程实践
大数据·数据仓库·hive·hadoop·sql
skywalk816311 天前
卡不等于分支:我用 TRAE 宝配合 Hive 跑三张任务卡的一天
运维·人工智能·hive·trae
freejackman12 天前
【架构篇】双遍历 + 多栈协同:手撸 SQL 血缘引擎的架构思考
java·大数据·数据库·hive·sql·架构·spark
陈年老古董12 天前
ClickHouse 单机搭建记录
hive·笔记·学习·clickhouse·硬件架构
陈年老古董12 天前
Spark 3.1.3 集群搭建 + Spark-SQL 整合 Hive 记录
hive·sql·spark
FserSuN12 天前
Hive 分区表存储与查询优化学习总结
hive·hadoop·学习
步行cgn13 天前
为什么既要 web.xml 又要 springmvc.xml?能不能只配一个?
xml·前端·hive
@小匠14 天前
Flink + Iceberg 批量失败复盘:一次超时如何变成 Hive Metastore 锁泄漏
大数据·hive·flink