【hadoop】Flume的相关介绍

1 概述

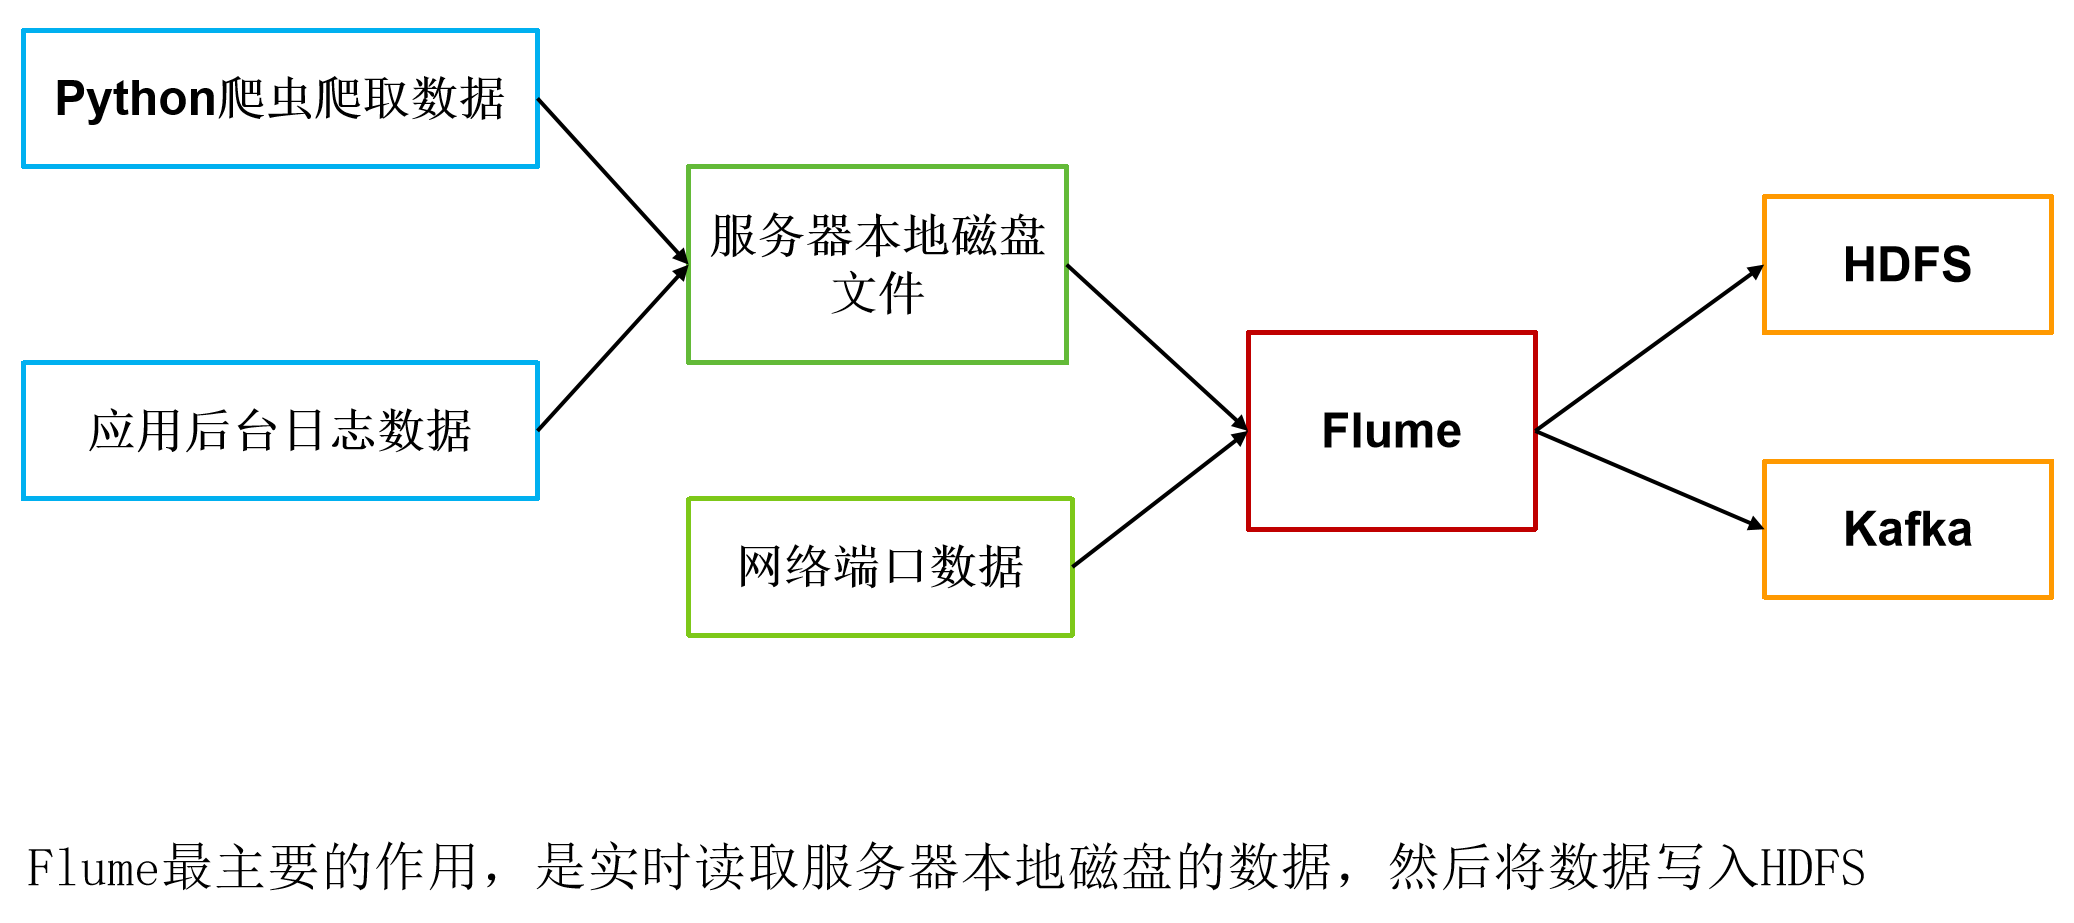
Flume是Cloudera开发的一个分布式的、可靠的、高可用的系统,它能够将不同数据源的海量日志数据进行高效收集、聚合、移动,最后存储到一个中心化的数据存储系统中。随着互联网的发展,特别是移动互联网的兴起,产生了海量的用户日志信息,为了实时分析和挖掘用户需求,需要使用Flume高效快速采集用户日志,同时对日志进行聚合避免小文件的产生,然后将聚合后的数据通过管道移动到存储系统进行后续的数据分析和挖掘。

2 作用
3 架构

Source

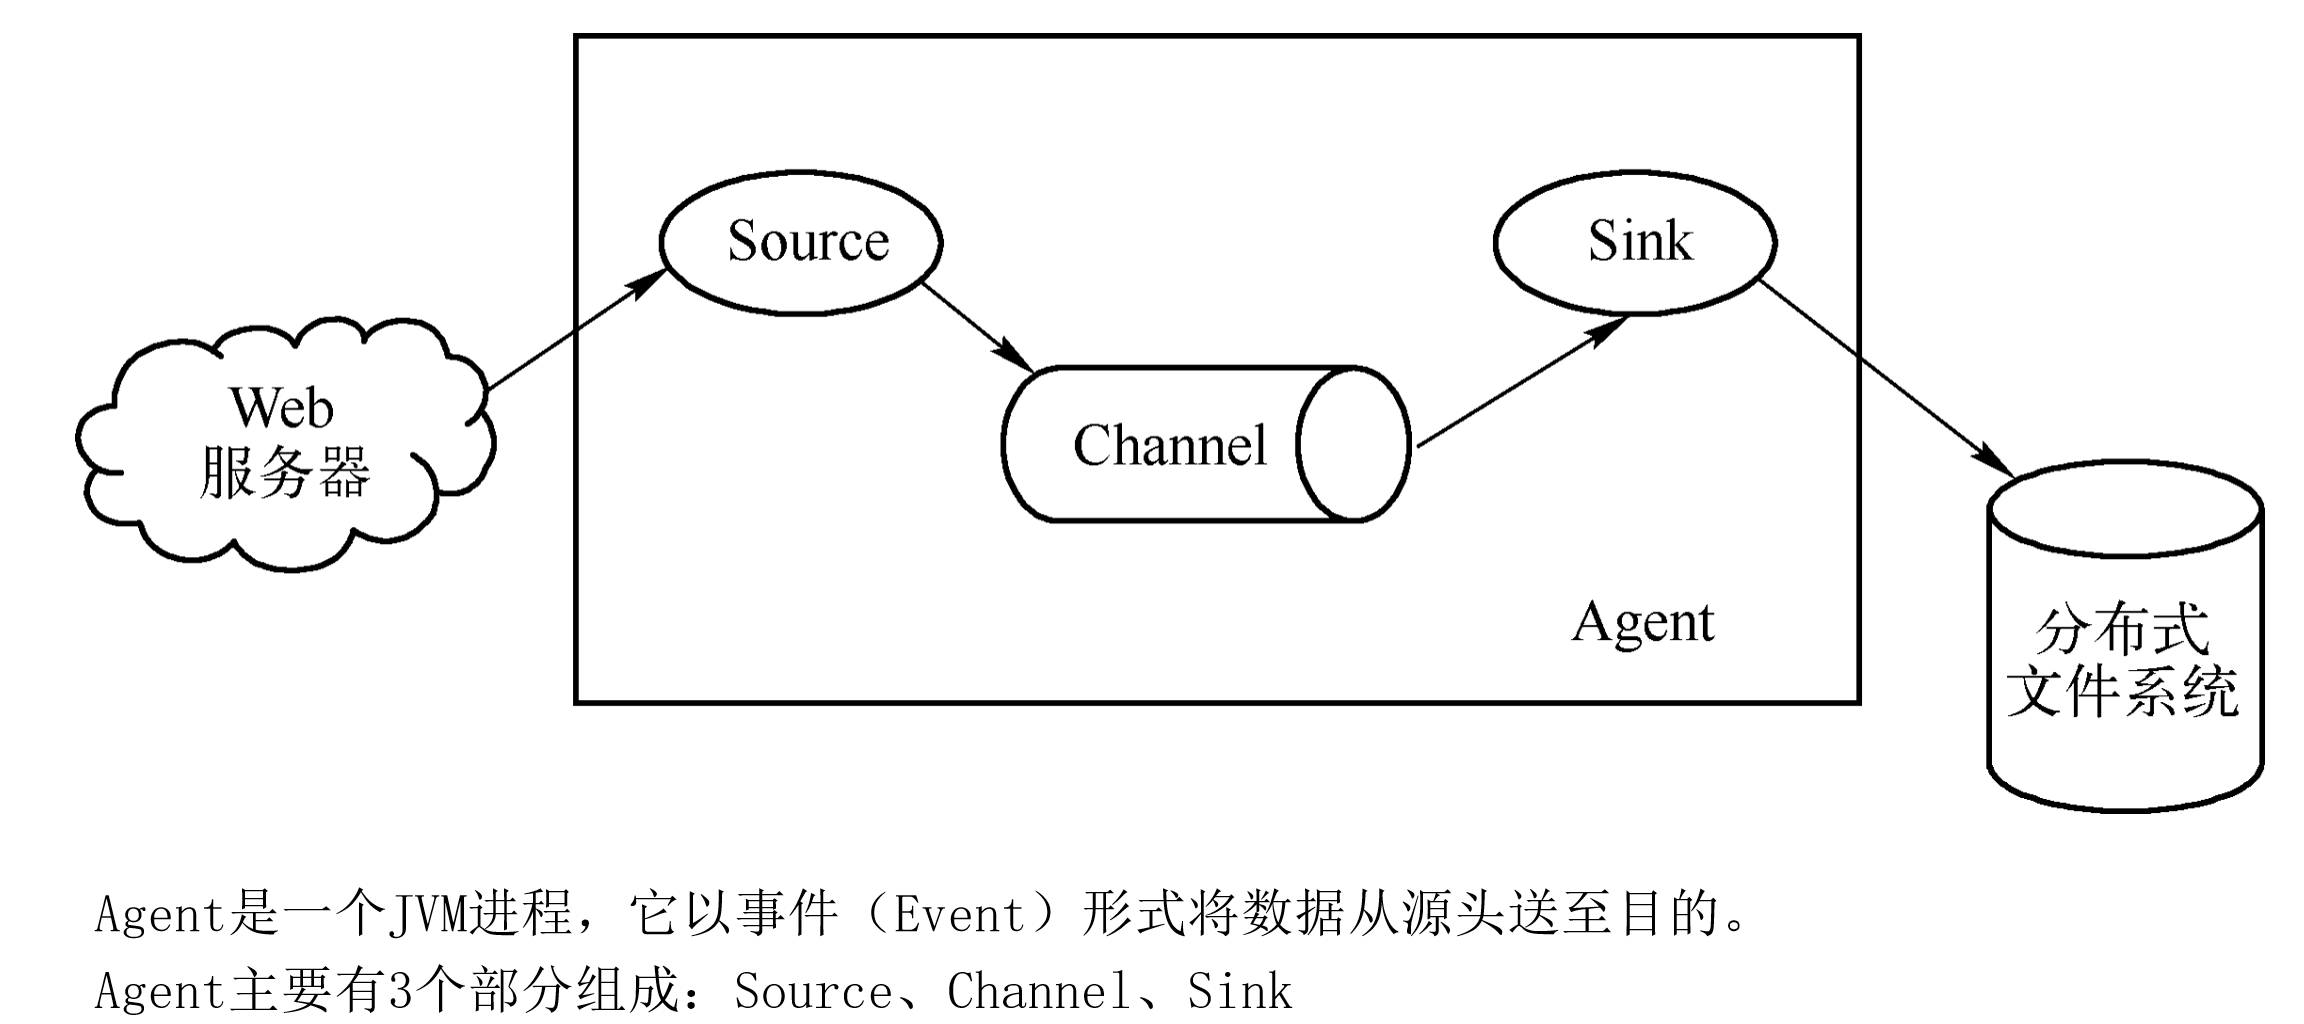
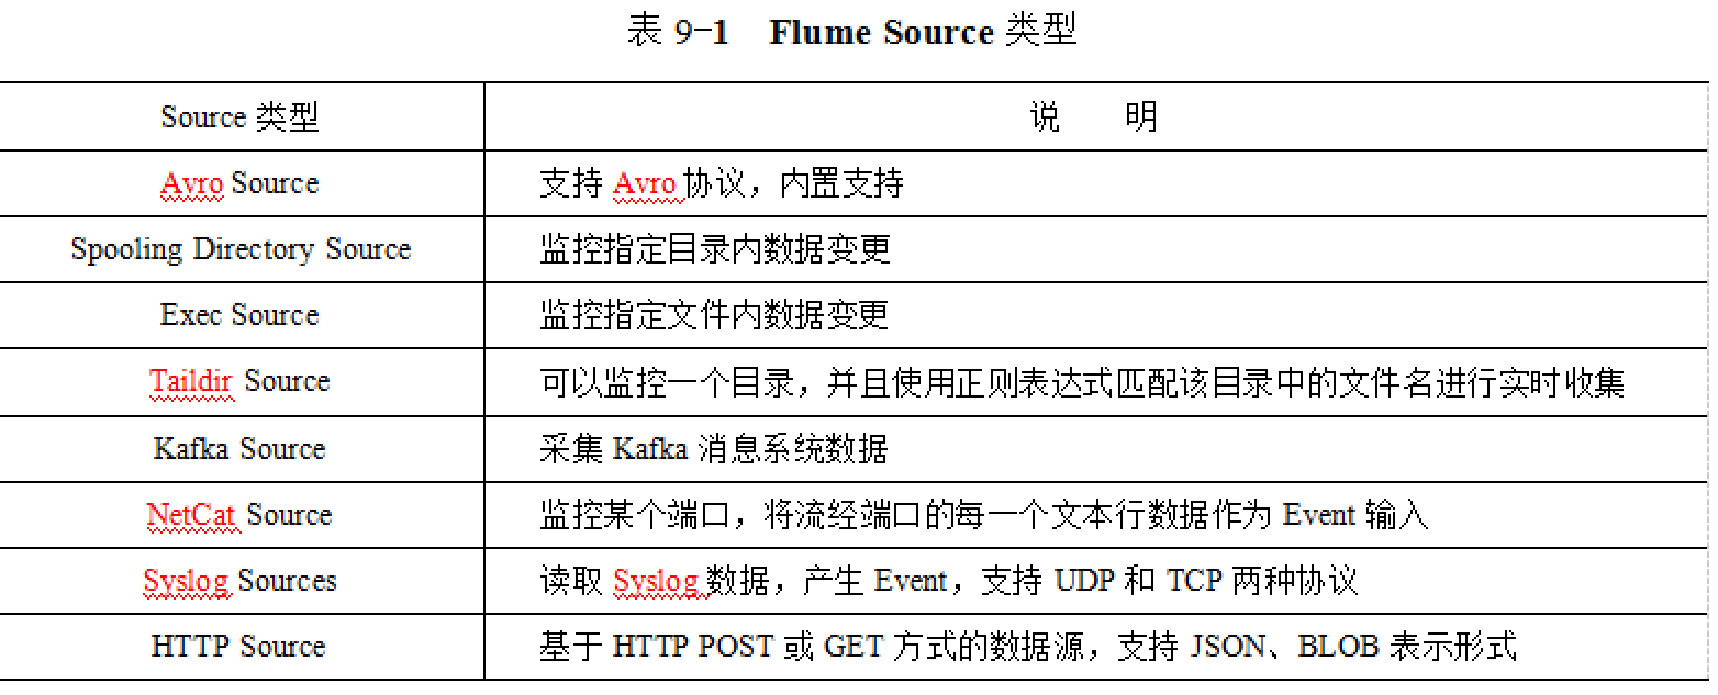
Source负责接收外部源发送过来的数据,指定各种类型的Source以使用各种方式接收数据。

Sink

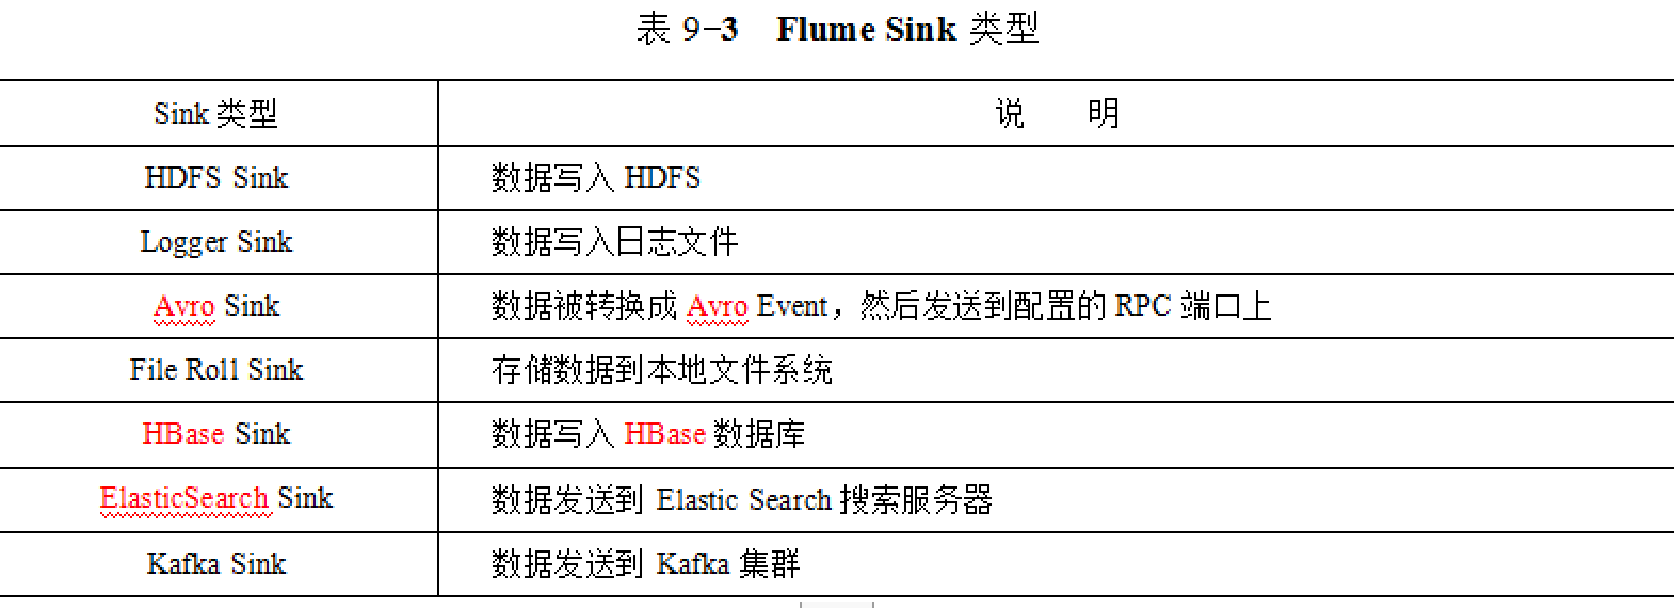
Sink负责消费Channel中的数据,然后发送给外部数据存储中心。

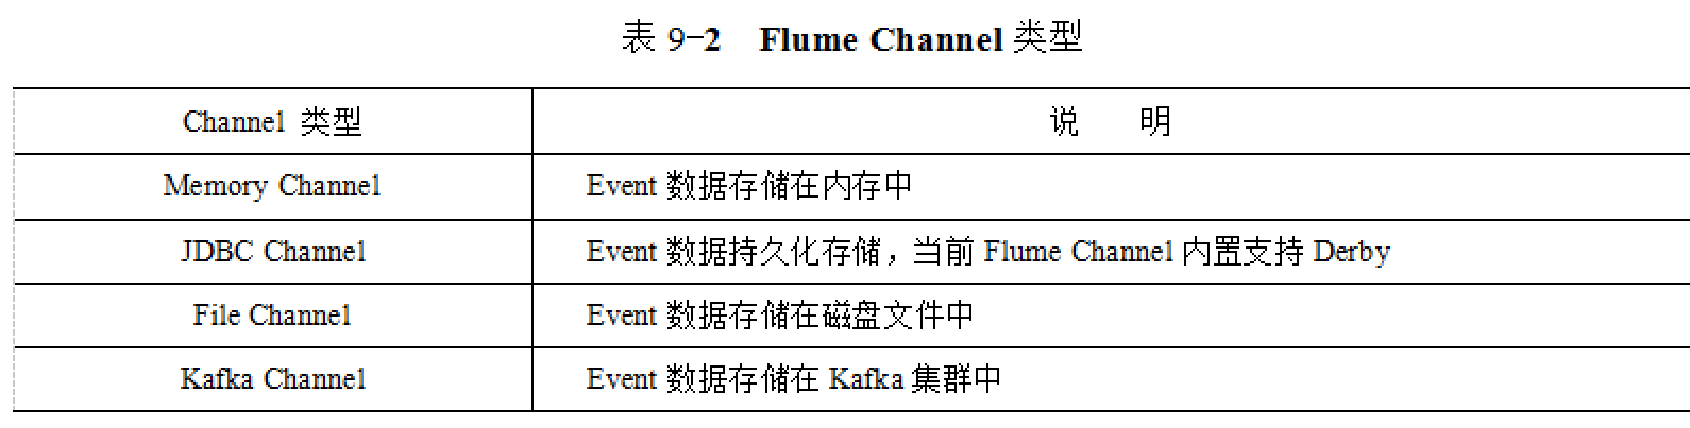
Channel

Channel是位于Source和Sink之间的缓冲区,它的存在使得Source和Sink可以运作在不同的数据处理速率上。
相关推荐
瑞克-桑切斯5 小时前
docker Harbor 单机部署手册
大数据·运维·elasticsearch·docker·容器
演艺大赏7 小时前
NiFi 起不来、登不上、节点被挤掉:一份按日志定位的排错清单
大数据
freejackman7 小时前
【实战三】撕开脱敏盲区:深度解析 CASE WHEN 与窗口函数血缘
大数据·数据库·sql
wafrdggh18 小时前
2026电商快递批量查询怎么用?固乔助手模板设置评测
大数据·数据库·小程序
大大大大晴天20 小时前
OLTP、OLAP、数据湖、数据集市、湖仓一体到底是什么关系?
大数据
正在走向自律1 天前
AI Agent 落地这一年:从“能跑起来”到“敢放出去”
大数据·人工智能·ai agent·智能体·mcp·a2a
freejackman1 天前
【实战二】字段级血缘追踪:拆解 AST 迷局,精准穿透函数链与子查询
大数据·数据库·sql
goujunwe1 天前
GEO 内容的“可摘录性”打磨技巧:段落、表格、小标题怎么写,方便大模型提取独立答案块
大数据·人工智能
小田学Python1 天前
DeepSeek Harness 完整上手指南:安装部署 + 必装插件 + 用一周就回不去的功能
大数据·大模型·agent·ai工具·deepseek
且从容.1 天前
Ubuntu安装flume
linux·ubuntu·flume