SparkConf 类用于配置 Spark 应用程序的各种参数。通过 SparkConf 类,你可以设置应用程序的名称、运行模式(如本地模式、集群模式)、资源分配(如内存、CPU 核心数)等。主要作用配置应用程序参数:可以设置 Spark 应用程序的各种属性,如应用程序名称、主节点地址等。
SparkContext 是 Spark 应用程序的入口点,它代表了与 Spark 集群的连接。通过 SparkContext,你可以创建 RDD(弹性分布式数据集)、累加器、广播变量等,还可以与外部数据源进行交互。
准备工作:启动hdfs集群,打开hadoop100:9870,在wcinput目录下上传一个包含很多个单词的文本文件。
写交互式代码:启动之后在spark-shell中写代码。
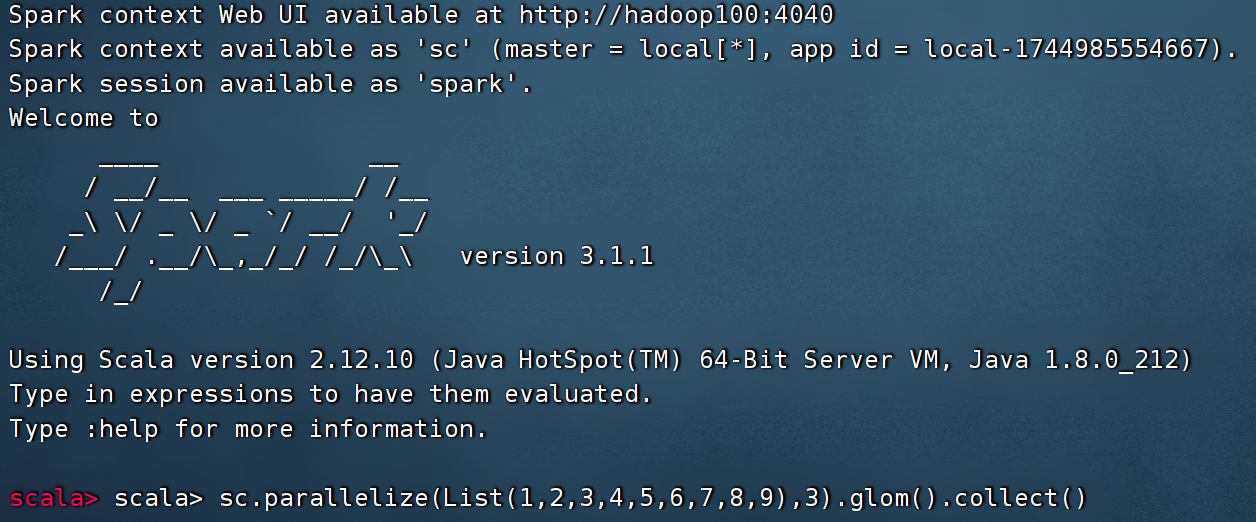
进入环境:spark-shell --master yarn
逐句写代码:
java
// 读取文件,得到RDD
    val rdd1 = sc.textFile("hdfs://hadoop100:8020/wcinput/words.txt")
    // 将单词进行切割,得到一个存储全部单词的RDD
    val rdd2= fileRDD.flatMap(line => line.split(" "))
    // 将单词转换为元组对象,key是单词,value是数字1
    val rdd3= wordsRDD.map(word => (word, 1))
    // 将元组的value按照key来分组,对所有的value执行聚合操作(相加)
    val rdd4= wordsWithOneRDD.reduceByKey((a, b) => a + b)
    // 收集RDD的数据并打印输出结果
    rdd4.collect().foreach(println)