一、数据集介绍
sklearn库中的玩具数据集,葡萄酒数据集。在前两次发布的内容《机器学习基础中》有介绍。
1.1葡萄酒列标签名:
wine.feature_names
结果:
'alcohol', 'malic_acid', 'ash', 'alcalinity_of_ash', 'magnesium', 'total_phenols', 'flavanoids', 'nonflavanoid_phenols', 'proanthocyanins', 'color_intensity', 'hue', 'od280/od315_of_diluted_wines', 'proline'
解释:
以下是葡萄酒数据集中各化学特征标签的详细解释:
1.**** 酒精相关
alcohol
酒精含量百分比,反映葡萄酒的酒精浓度。
2.**** 酸类成分
malic_acid
苹果酸含量(g/L),影响口感酸度与果香。
ash
灰分含量(g/L),燃烧后残留的无机物总量。
alcalinity_of_ash
灰分碱度(mEq/L),衡量灰分的碱性强度。
3. 矿物质与微量元素
magnesium
镁元素含量(mg/L),与葡萄酒的营养价值和口感相关。
4.**** 酚类物质
total_phenols
总酚含量(mg/L),包括单宁、色素等,影响抗氧化性和风味复杂度。
flavanoids
类黄酮含量(mg/L),具有抗氧化作用,贡献苦味和收敛性。
nonflavanoid_phenols
非类黄酮酚含量(mg/L),其他酚类化合物的总和。
proanthocyanins
原花青素含量(mg/L),影响口感涩度和色泽稳定性。
5. 颜色与光学特性
color_intensity
颜色强度(吸光度单位),通过光谱测量反映颜色深浅。
hue
色调(1-10),描述色彩偏向(如红、紫等)的数值指标。
od280/od315_of_diluted_wines
稀释后葡萄酒样品的光密度比值,用于评估特定化学成分(如酚类)的浓度。
6.**** 其他特征
proline
脯氨酸含量(μg/L),一种氨基酸,影响风味和微生物稳定性。
1.2葡萄酒行目标名:
wine.target_names
结果:
'class_0' 'class_1' 'class_2'
解释:
类别标识 :代表葡萄酒的三个不同品种或类别,用于区分样本所属的类别归属。
数据集包含 178 个样本,每个样本对应 13 种化学特征(如酒精浓度、酸度等)。
类别标签通过数值化(0/1/2)或字符串(class_0/class_1/class_2)形式存储,便于模型训练和预测。
二、大致步骤
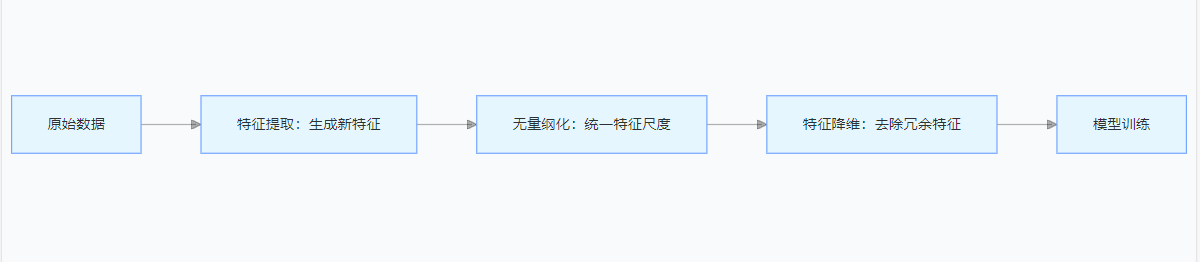
2.1 数据加载
使用sklearn库加载葡萄酒数据集,并转换为dataframe格式查看前几条相关信息。
2.2数据预处理
(1)划分数据集;(2)标准化处理
2.3特征降维
应用主成份分析(PCA)降维方法进行特征降维,设置参数为0.95,即保存95%的方差数据信息。
2.4模型训练与预测
使用随机森林分类器对降维数据进行训练,并对测试集进行预测。
2.5模型评估
计算模型准确率。
2.6可视化分析
展示图像,数形结合。
三、代码实现
python
from sklearn.datasets import load_wine
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.decomposition import PCA
from sklearn.ensemble import RandomForestClassifier
#加载数据集
wine = load_wine()
print(wine.data.shape) #打印数据集形状(有多少条数据,列标签有多少)
#其他基础操作不再重复,前几篇有介绍

#划分数据集
x_train,x_test,y_train,y_test = train_test_split(wine.data,wine.target,test_size=0.3,random_state=42)

#标准化数据集
scaler = StandardScaler()
x_train_scaler = scaler.fit_transform(x_train)
x_test_scaler = scaler.transform(x_test)
#一般不会对y进行标准化

#特征降维
pca = PCA(n_components=0.95)
x_train_pca = pca.fit_transform(x_train_scaler)
x_test_pca = pca.transform(x_test_scaler)

#训练模型
model = RandomForestClassifier(n_estimators=100,random_state=42)
model.fit(x_train_pca,y_train)

#预测
y_pred = model.predict(x_test_pca)
print(y_pred)

#评估模型准确率
score = model.score(x_test_pca,y_test)
print(score)
结果:
(178, 13)
[0 0 2 0 1 0 1 2 1 2 1 2 0 2 0 1 1 1 0 1 0 1 1 2 2 2 1 1 1 0 0 1 2 0 0 0 2
2 1 2 1 1 1 1 2 0 1 1 2 0 1 0 0 2]
0.9444444444444444