elastic 有弹力的
ElaticSearch (ES)是一个基于 Lucene 的分布式全文检索引擎。可以做到近乎实时地存储、检索数据,并且本身具有良好的扩展性,可以扩展到上百台服务器,处理PB级别(1 Petabyte = 1024TB)的数据。
ES 常用于日志分析、全文搜索、安全智能、业务分析和运维智能等场景。
文章目录
- 使用
- 原理
-
-
- 倒排索引
- 分词
- Lucene
- Elasticsearch
- [Elasticsearch 分布式原理](#Elasticsearch 分布式原理)
- [ELK Stack](#ELK Stack)
-
使用
可用 docker 部署 elasticsearch 程序,默认有安全检测不好连接,生产环境可以见下面命令绕过连接启动:
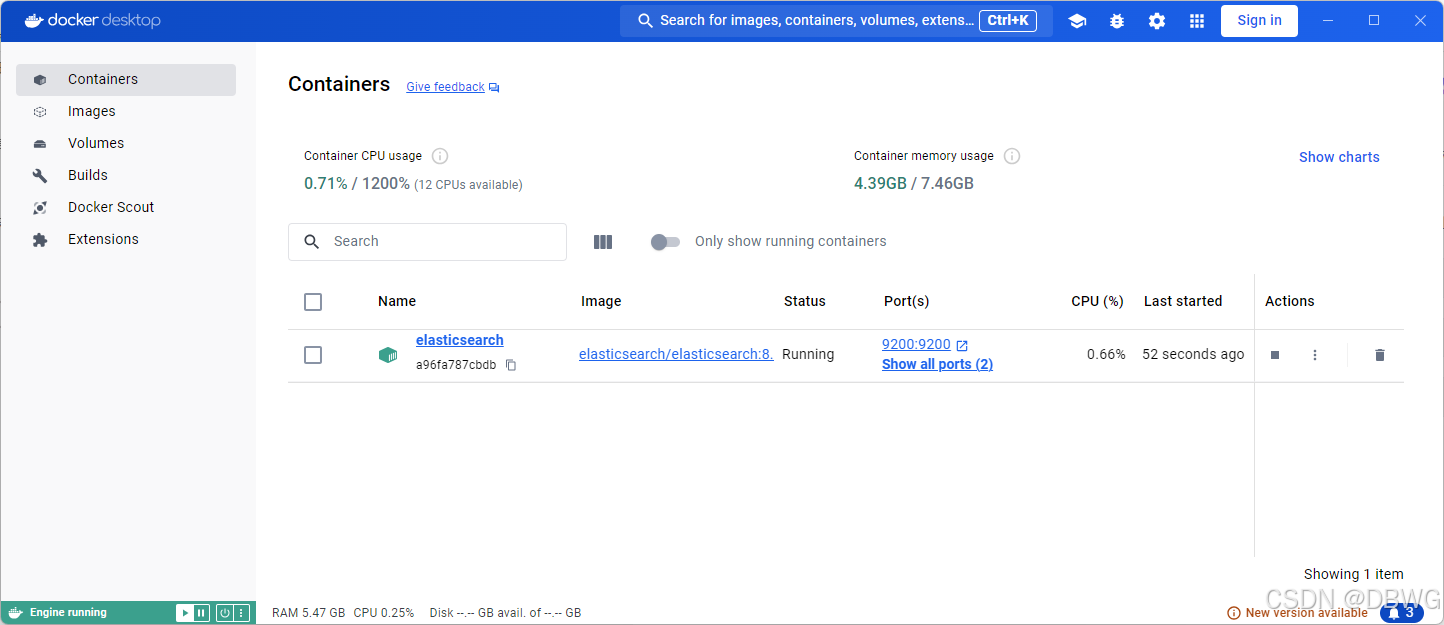
访问测试:
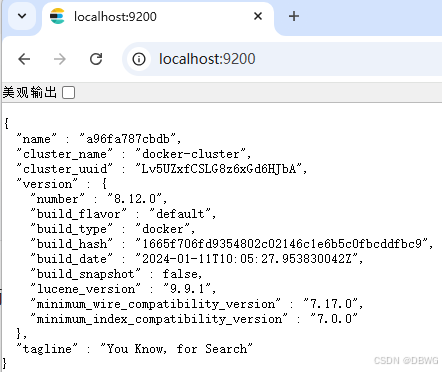
也可以用 curl http://localhost:9200 来测试
相关docker命令:
-- 关闭 Elasticsearch 安全认证(仅测试环境) (没有应该会下载,注意版本)
docker run -d -p 9200:9200 -p 9300:9300 `
  -e "discovery.type=single-node" `
  -e "xpack.security.enabled=false" `
  --name elasticsearch docker.elastic.co/elasticsearch/elasticsearch:8.12.0


-- 之后直接 start 启动即可:
docker start elasticsearch
docker stop elasticsearch
docker rm elasticsearch

docker ps -a  # 查看所有容器(包括停止的)
docker logs elasticsearch
写java时:
SpringbootFramework 管理的 elasticsearch 只需配置即可使用:
- ElasticsearchRepository已经提供了基础的 CRUD 操作
这里交互方法也只需声明继承的接口: - 自定义方法则能通过命名规则来扩展更多查询功能------也不需要实现,Spring Data 框架能够依据方法名称自动生成对应的实现。
java
package org.example.searchservice.repository;


import org.example.common.dto.Question;
import org.springframework.data.elasticsearch.repository.ElasticsearchRepository;
import org.springframework.stereotype.Repository;

import java.util.List;


@Repository
public interface QuestionEsRepository extends ElasticsearchRepository<Question, String> {
    // 标题或内容模糊搜索(自动解析成 bool should)
    List<Question> findByTitleContainingOrContentContaining(String title, String content);

    // 根据标签精确匹配(List<String> 是 keyword 类型)
    List<Question> findByTagsIn(List<String> tags);
}


//你不需要手动实现插入方法,ElasticsearchRepository 已经帮你准备好了常用的 CRUD 方法,包括插入。
//        🧩 一、插入数据的方式
//ElasticsearchRepository 继承了 CrudRepository,所以它自动拥有以下方法:
//
//方法	作用
//save(T entity)	插入或更新单条数据
//saveAll(Iterable<T> entities)	批量插入或更新
//findById(ID id)	根据 ID 查询
//deleteById(ID id)	根据 ID 删除
//findAll()	查询所有
//count()	统计数量
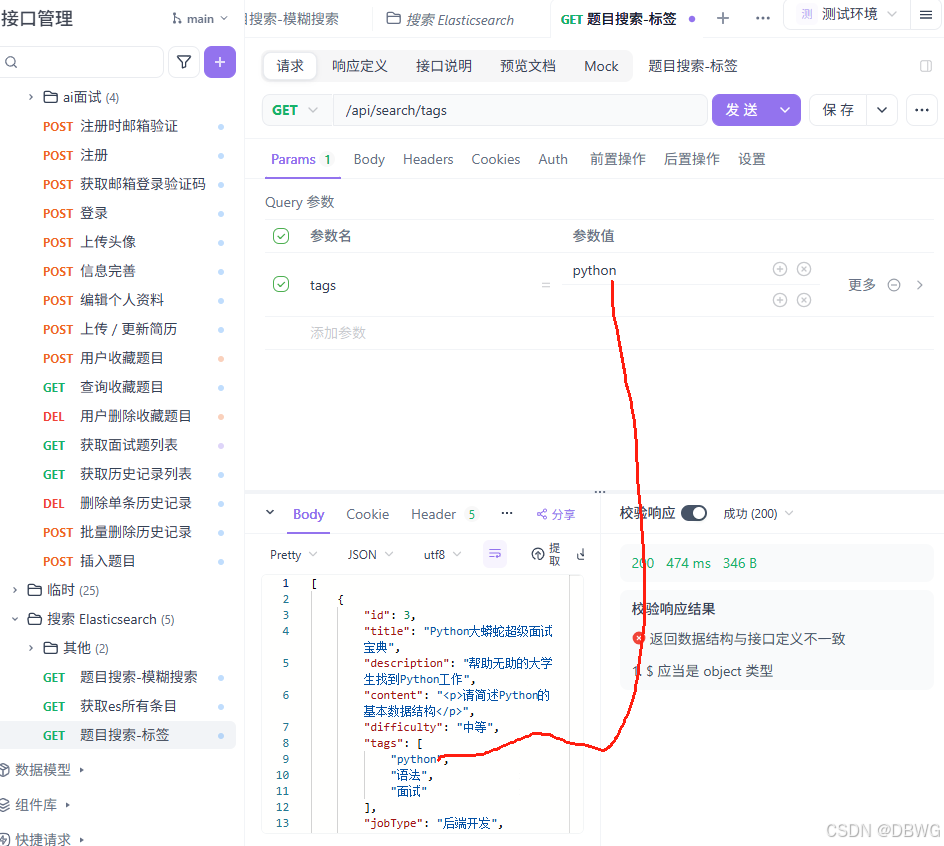
检索:(需先把要检索的插入ES,如上的save方法)
原理
(图画故事参考 https://zhuanlan.zhihu.com/p/589967518)
倒排索引
像 map 是 kv 的,通过索引 key 获得对应的 value
现在我们为 value 建立索引,来找 value,即为倒排索引:
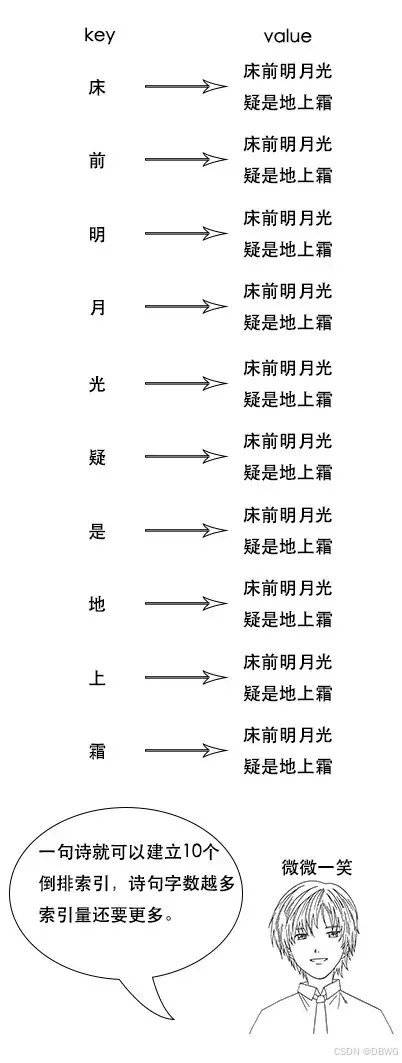
不过这样数据量确实会更多,我们索引原先的 key 即可:
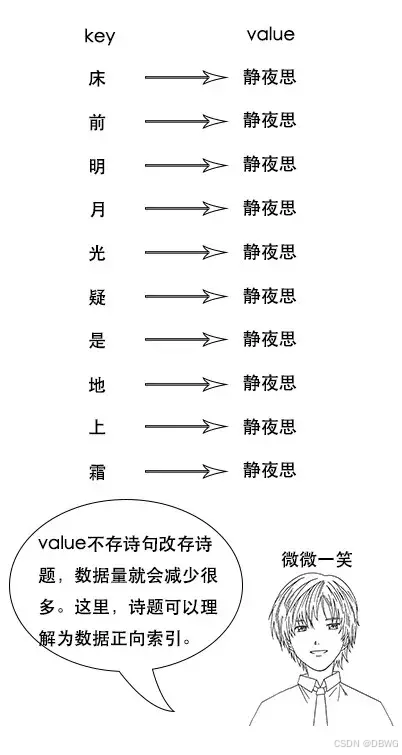
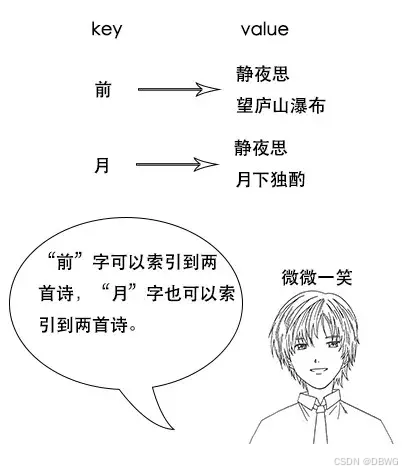
现在新建立的反向索引也可一次索引多个 key!
分词
其实谷歌,百度这些搜素引擎原理就是建立倒排索引。
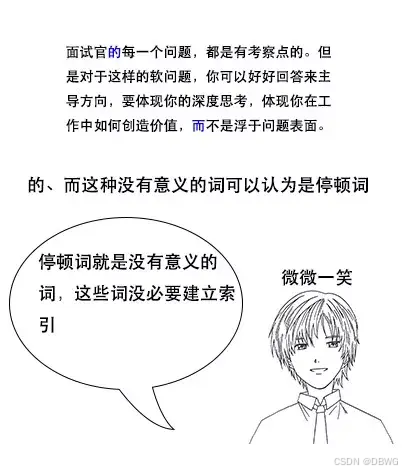
搜索引擎对文章分词后,才根据关键字建立倒排索引的。
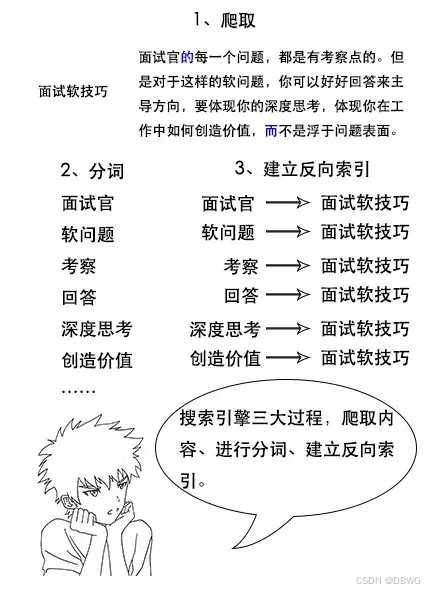
中文分词的挑战
中文是无空格语言,不像英文能天然用空格区分词语,因此必须借助分词器进行预处理。
常见中文分词器:
- IKAnalyzer(IK 分词器):主流的开源分词器,支持最细粒度分词和智能分词。
- jieba:Python 中广泛使用的分词库,可通过插件方式接入 ES。
- THULAC、HanLP、NLPIR:更偏学术或 NLP 应用,灵活性强但引入复杂度较高。
分词粒度与搜索效果的平衡
粒度细 ,命中就多,但是召回差
粒度粗,精度高,召回差
例:搜索"深圳大学图书馆",分成"深圳"、"大学"、"图书馆"可能命中大量无关文档。
若仅保留"深圳大学图书馆",可能"深大图书馆"或"深圳大学图书室"都无法匹配。
Lucene
Lucene库可以方便的建立倒排索引,不过不懂原理的人很难调用,所以后来有人封装其为 Elasticsearch。
Lucene 是一个全文检索引擎工具包 。它是一款 纯Java的全文检索引擎工具包,提供了完整的查询引擎和索引引擎,主要用于实现全文搜索功能。
Lucene 主要是基于倒排索引的文本检索,通过创建并建立索引器(IndexWriter)来读取需要建立全文索引的文本内容 ------ 即读入一堆文本文件并将其转换为易于搜索的数据结构
Elasticsearch
ElasticSearch 是基于 Lucene 做了封装和增强,通过简单的 RESTful API 来隐藏 Lucene 的复杂性。
它还考虑了海量数据,实现了分布式,是一个可以存储海量数据的分布式搜索引擎。
- 索引:elasticsearch 存放数据的地方。
- 类型:定义数据结构
- 文档:数据
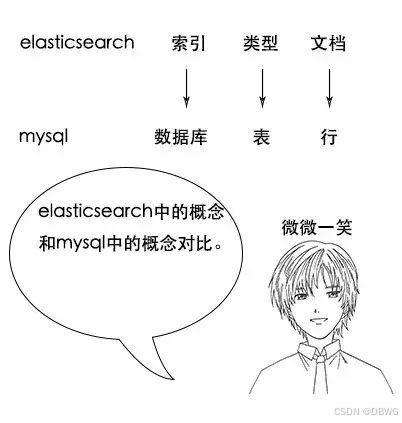
要存一系列个体,就先为这种个体创建索引,索引内定义类型(一个带各种属性的结构体)
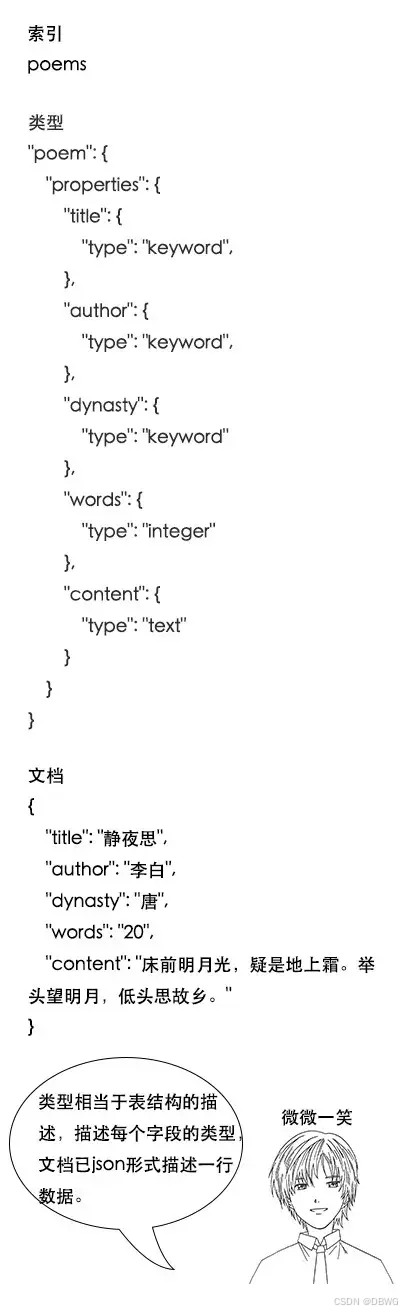
keyword 类型不会分词而直接建立反向索引,text会。
Elasticsearch 分布式原理
- hdfs (Hadoop Distributed File System) Hadoop分布式文件系统
是指被设计成适合运行在通用硬件(commodity hardware)上的分布式文件系统
elasticsearch 也会对数据进行切分时每一个分片会保存多个副本 。(其原因和 HDFS 是一样的,都是为了保证分布式环境下的高可用 ------ 主从架构,redis也是子结点分担读请求)
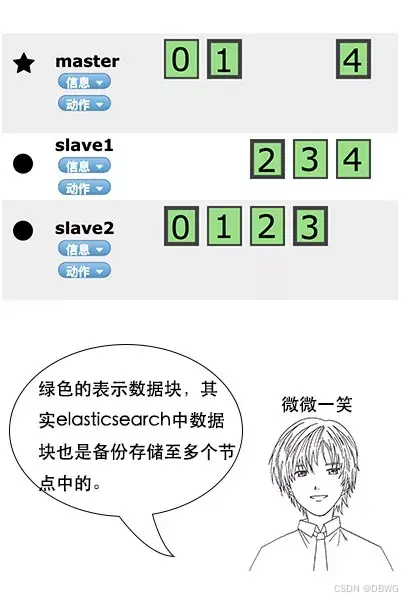
节点间会通过自己的一些规则选取集群的 Master
Master 会负责集群状态信息的改变,并同步给其他节点。
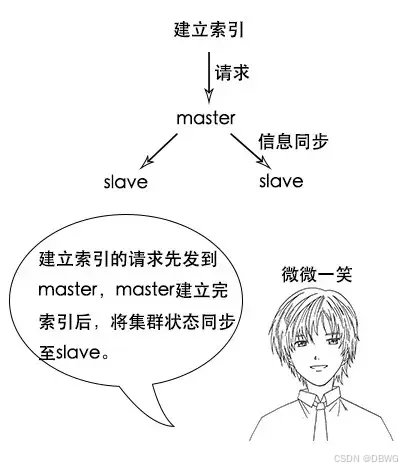
注意,只有建立索引和类型 需要经过 Master,数据的写入有一个简单的 Routing 规则,可以 Route 到集群中的任意节点,所以数据写入压力是分散在整个集群的。
ELK Stack
ES与Logstash、Beats和Kibana等工具协同工作,共同提供数据收集、存储、分析、可视化和监控等功能,组成 ELK 。
- Logstash:数据收集与处理 管道工具(采集日志数据、过滤清洗)
- Beats:轻量级的数据采集器(日志或指标)
- Kibana:可视化工具
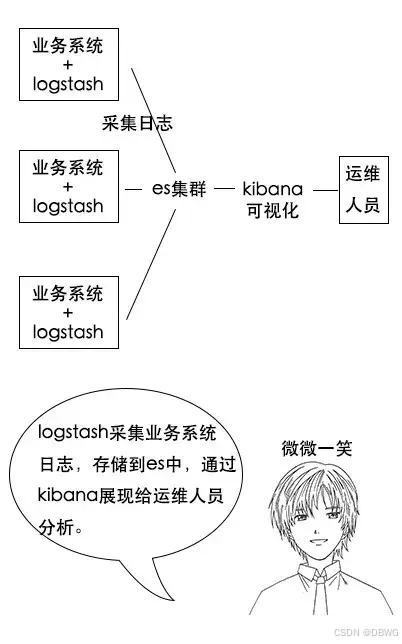
工作流程:

[ 日志 / 数据 ]
      ↓
    Beats(轻量上报器)
      ↓
  Logstash(采集 + 清洗)
      ↓
Elasticsearch(存储 + 查询)
      ↓
Kibana(可视化)分析日志的用处可大了,你想,假如一个分布式系统 有 1000 台机器,系统出现故障时,我要看下日志,还得一台一台登录上去查看,是不是非常麻烦?
但是如果日志接入了 ELK 系统就不一样。比如系统运行过程中,突然出现了异常,在日志中就能及时反馈,日志进入 ELK 系统中,我们直接在 Kibana 就能看到日志情况。如果再接入一些实时计算模块,还能做实时报警功能。