Apache Kafka 实现原理深度解析:生产、存储与消费全流程
引言
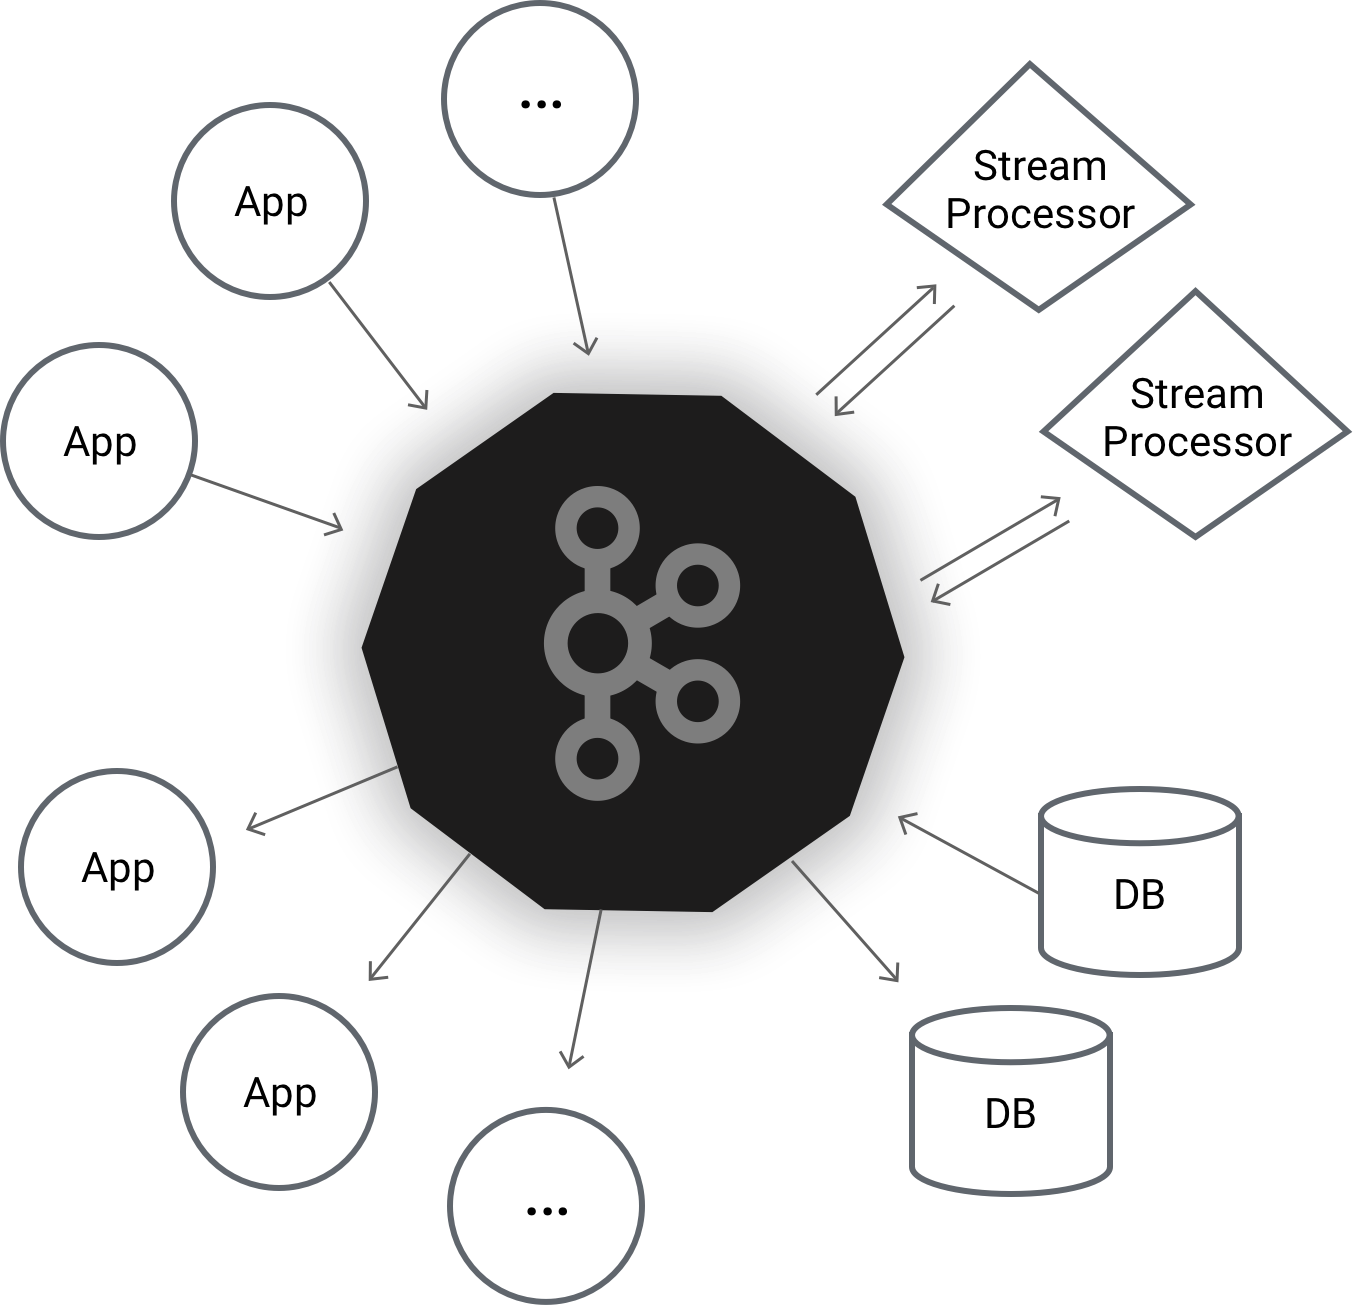
Apache Kafka 作为分布式流处理平台的核心,其高吞吐、低延迟、持久化存储的设计使其成为现代数据管道的事实标准。本文将从消息生产、持久化存储、消息消费三个阶段拆解 Kafka 的核心实现原理。
一、生产者(Producer)阶段:高效消息投递
Producer 的作用是将消息高效、可靠地发送到 Kafka 的指定 Topic 中。
1. 分区选择策略
Kafka 通过**分区(Partition)**实现并行处理与水平扩展。生产者发送消息时,采用以下策略确定目标分区:
java
// 默认分区策略示例(基于 Key 哈希)
public int partition(String topic, Object key, byte[] keyBytes,
                    Object value, byte[] valueBytes, Cluster cluster) {
    List<PartitionInfo> partitions = cluster.partitionsForTopic(topic);
    return Math.abs(Utils.murmur2(keyBytes)) % partitions.size();
}| 策略类型 | 适用场景 | 特点 |
|---|---|---|
| 轮询(Round Robin) | 无 Key 的消息 | 负载均衡,但可能无序 |
| Key 哈希 | 保证相同 Key 消息顺序性 | 可能引发数据倾斜 |
| 自定义策略 | 复杂路由需求 | 需实现 Partitioner 接口 |
2. 消息批处理与压缩
- 批次(Batch):生产者将消息按 linger.ms 和 batch.size 聚合发送
- 压缩算法:支持 Snappy、LZ4、Zstandard,降低网络开销
- 内存池:复用缓冲区减少 JVM GC 压力
3. 消息确认机制(ACKs)
| ACK 配置 | 可靠性 | 延迟 | 适用场景 |
|---|---|---|---|
| 0 | 最低 | 最低 | 日志收集等容忍丢失场景 |
| 1(默认) | 中等 | 中 | 常规业务场景 |
| all/-1 | 最高 | 最高 | 金融交易等关键场景 |
二、存储(Storage)阶段:持久化架构设计
Kafka Broker 是核心服务器组件,负责接收生产者数据、存储日志、处理消费者请求等。
1. 分区日志结构
bash
# 分区目录结构示例
topic-name-0/
├── 00000000000000000000.log   # 消息日志文件
├── 00000000000000000000.index # 位移索引
├── 00000000000000000000.timeindex # 时间戳索引
└── leader-epoch-checkpoint    # Leader 纪元记录
2. 写入优化技术
- 顺序写盘:日志追加写(
append-only)利用磁盘顺序 I/O 优势 页缓存(Page Cache):通过mmap直接操作内存,避免 JVM 堆开销零拷贝(Zero-Copy):sendfile系统调用实现内核态数据传输
3. 日志分段策略
| 策略类型 | 配置参数 | 触发条件 |
|---|---|---|
| 基于时间 | log.roll.hours | 当前段创建超过指定时间 |
| 基于大小 | log.segment.bytes | 当前段大小超过阈值(默认1GB) |
| 基于起始位移 | log.roll.ms | 第一条消息时间超过阈值 |
4. 副本同步机制
- ISR(In-Sync Replicas):与 Leader 保持同步的副本集合
- HW(High Watermark):已成功复制到所有 ISR 的最高消息位移
- Leader Epoch:防止副本数据不一致的机制
三、消费者(Consumer)阶段:精准消息消费
Kafka Consumer 负责从 Broker 中拉取消息并处理,是数据消费端的关键组成部分。
1. 消费者组(Consumer Group)
Consumer Group Consumer 1 Consumer 2 Consumer 3 Topic with 6 Partitions
2. 位移管理
- __consumer_offsets:内部 Topic 存储消费位移
- 提交策略:
- auto.commit.interval.ms:自动提交
- 同步/异步手动提交
- 位移重置策略:earliest, latest, none
3. 消费流程优化
- Max Poll Records:单次拉取最大消息数(默认500)
- Fetch Min Bytes:等待最小数据量(默认1字节)
- Max Partition Fetch Bytes:单分区最大拉取量(默认1MB)
四、典型场景实现原理
1. 精确一次语义(Exactly-Once)
java
// 生产者配置
props.put("enable.idempotence", "true");
props.put("transactional.id", "my-transactional-id");

// 消费者配置
props.put("isolation.level", "read_committed");
2. 流处理基础
- Kafka Streams:利用 state store 实现有状态处理
- KSQL:通过持续查询实现流表关联
总结:Kafka 设计哲学
| 设计原则 | 实现手段 | 收益 |
|---|---|---|
| 顺序读写 | 分区日志追加写 | 高吞吐(百万级 QPS) |
零拷贝 |
sendfile + mmap |
低延迟(毫秒级) |
| 分布式共识 | ZooKeeper/KRaft 协调 | 高可用(99.99% SLA) |
| 批量处理 | 消息批次 + 压缩 | 高网络效率 |
掌握 Kafka 的核心实现原理,有助于在业务场景中做出合理架构决策,充分发挥其在大规模实时数据流处理中的威力。