本期是《第33步 机器学习分类实战:误判病例分析》的R版本。
尝试使用Deepseek-R1来试试写代码,效果还不错。
下面上R语言代码,以Xgboost为例:
python
# 加载必要的库
library(caret)
library(pROC)
library(ggplot2)
library(xgboost)

# 假设 'data' 是包含数据的数据框
# 设置随机种子以确保结果可重复
set.seed(123)

# 将数据分为训练集和验证集(80% 训练集,20% 验证集)
trainIndex <- createDataPartition(data$X, p = 0.8, list = FALSE)
trainData <- data[trainIndex, ]
validData <- data[-trainIndex, ]

# 为 XGBoost 准备数据矩阵
dtrain <- xgb.DMatrix(data = as.matrix(trainData[, -which(names(trainData) == "X")]), label = trainData$X)
dvalid <- xgb.DMatrix(data = as.matrix(validData[, -which(names(validData) == "X")]), label = validData$X)

# 定义 XGBoost 的参数
params <- list(booster = "gbtree",
               objective = "binary:logistic",
               eta = 0.1,
               gamma = 0,
               max_depth = 6,
               min_child_weight = 1,
               subsample = 0.5,
               colsample_bytree = 0.9,
               lambda = 10,
               alpha = 5,
               eval_metric = "logloss")  # 使用 logloss 作为评估指标

# 训练 XGBoost 模型,并加入早停法
model <- xgb.train(params = params,
                   data = dtrain,
                   nrounds = 250,
                   watchlist = list(train = dtrain, eval = dvalid),  # 监控训练集和验证集
                   early_stopping_rounds = 10,  # 如果验证集性能在 10 轮内没有提升,则停止训练
                   verbose = 1)

# 对训练集和验证集进行预测
trainPredict <- predict(model, dtrain)
validPredict <- predict(model, dvalid)

# 将概率值转换为二分类预测结果(默认阈值为 0.5)
trainPredictBinary <- ifelse(trainPredict > 0.5, 1, 0)
validPredictBinary <- ifelse(validPredict > 0.5, 1, 0)

# 提取正常分类和误判样本
# 训练集
trainResults <- trainData
trainResults$Predicted <- trainPredictBinary  # 添加预测结果列
trainResults$Actual <- trainData$X  # 添加真实标签列
trainResults$Status <- ifelse(trainResults$Predicted == trainResults$Actual, "Correct", "Misclassified")  # 添加分类状态列

# 验证集
validResults <- validData
validResults$Predicted <- validPredictBinary  # 添加预测结果列
validResults$Actual <- validData$X  # 添加真实标签列
validResults$Status <- ifelse(validResults$Predicted == validResults$Actual, "Correct", "Misclassified")  # 添加分类状态列

# 分离正常分类和误判样本
trainCorrect <- trainResults[trainResults$Status == "Correct", ]
trainMisclassified <- trainResults[trainResults$Status == "Misclassified", ]

validCorrect <- validResults[validResults$Status == "Correct", ]
validMisclassified <- validResults[validResults$Status == "Misclassified", ]

# 输出正常分类和误判样本
print("训练集中的正常分类样本:")
print(trainCorrect)

print("训练集中的误判样本:")
print(trainMisclassified)

print("验证集中的正常分类样本:")
print(validCorrect)

print("验证集中的误判样本:")
print(validMisclassified)

# 将结果保存到文件(可选)
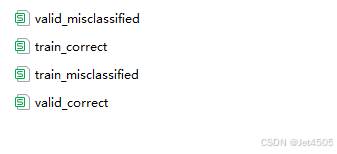
write.csv(trainCorrect, file = "train_correct.csv", row.names = FALSE)
write.csv(trainMisclassified, file = "train_misclassified.csv", row.names = FALSE)
write.csv(validCorrect, file = "valid_correct.csv", row.names = FALSE)
write.csv(validMisclassified, file = "valid_misclassified.csv", row.names = FALSE)
简单解说:
(A)最终结果输出成excel查看,输出地址就是你的工作路径,不懂的话可以使用代码 getwd() 展示出来。
(B)打开工作路径,可以发现四个文件,分别对应混淆矩阵的四个数字:
(C)题外话:Deepseek-R1-0528 改改代码感觉可以跟GPT类似了,平替的好手。