随机森林算法是一种强大的树集成算法,比使用单个决策树效果要好得多。
以下是生成树集成的方法:假设有一个大小为m的训练集,然后对于b=1到B,所以执行B次,可以使用有放回抽样来创建一个大小为m的训练集。所以如果有10个训练集。你会将这10个训练样本放在那个虚拟的袋子里,并进行10次有放回抽样以生成一个新的训练集,也包含10个样本,然后在这个训练集上训练一个决策树,所以这是使用有放回抽样生成的数据集,如果仔细观察,可能会注意到某些训练样本是重复的,那没关系。如果在这个数据集上训练决策树算法,最终会得到这个决策树。完成一次之后,再重复第二次,使用有放回抽样生成另一个包含m或10个训练样本的训练集,然后再这个新数据集上训练决策树,最终得到一个稍微不同的决策树,以此类推,总共可能这样做B次,B代表的是构建的树的数量,可能在100左右。构建了一个集成模型之后,比如100棵不同的树,然后,当你尝试进行预测时,让这些树都投票决定正确的最终预测结果,事实证明,设定更大的B并不会影响性能,但超过某个点之后,最终会面临收益递减,而且当B远大于这个数值时,实际效果并不会有明显提升,使用过大的数只会显著减慢计算速度,而不会显著提升整体性能。这种树集成的具体实例有时也被称为袋装决策树。
随机森林算法即使用这种有放回抽样的程序,有时最终总是在根节点使用相同的分裂以及在根节点附近进行非常相似的分裂。在这个特定例子中,训练记得小变化导致了根节点处的不同分裂,对于很多数据集来说这并不少见,最终在根节点选择了相同的特征,并且在根节点附近的一些节点处选择了相同的特征。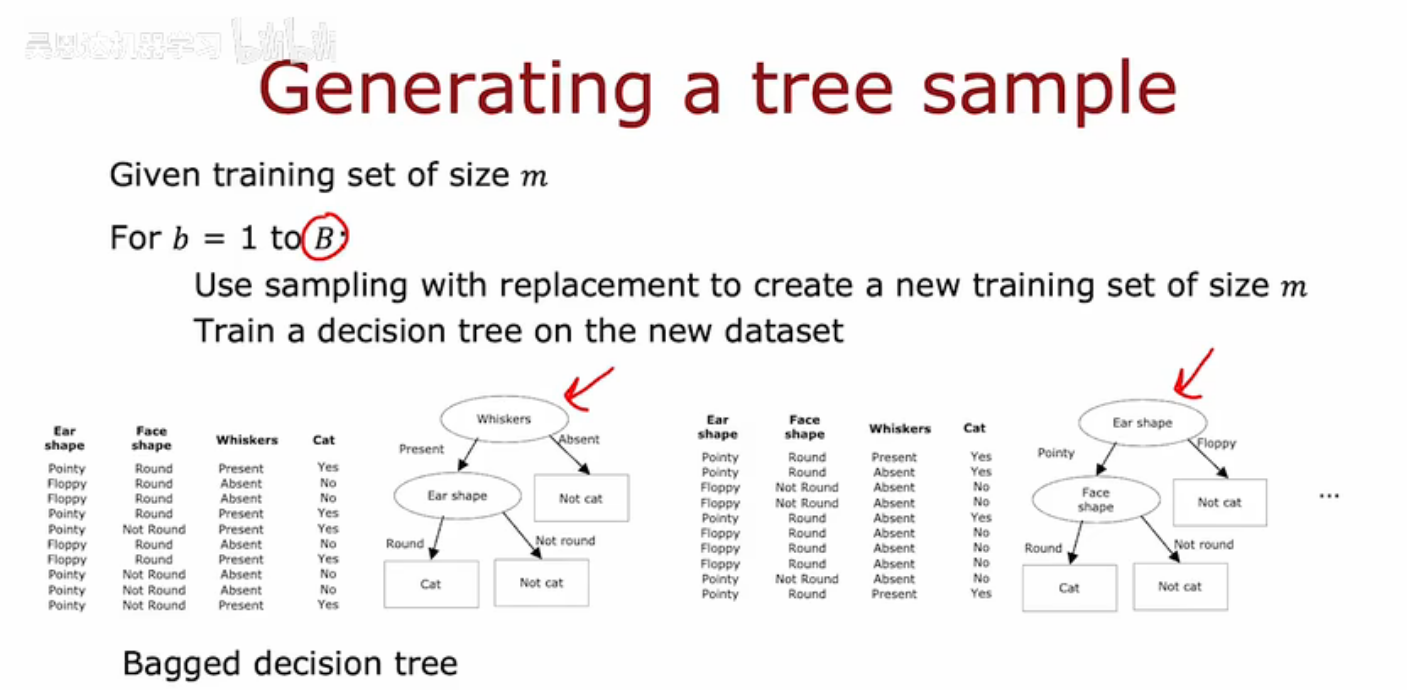
所以对算法有一种修改,可以进一步尝试在每个节点随机化特征选择,可能会导致所学到的树集合变得更加不同,这样当你对它们进行投票时,最终会得到更准确的预测。
通常的做法是,在每个节点选择特征进行分裂时,如果有n个特征可用,在我们的例子中有三个特征,而不是从所有n个特征中选择,我们会选择一个k个特征(k<n)的随机子集 ,并允许算法仅从这个k个特征子集中选择,换句话说,选择k个特征作为允许的特征,然后从这k个特征中,选择信息增益最高的特征作为分裂用的特征,当n很大时,比如n有几十或上百,k的一个典型选择是选择n的平方根。在我们的例子中,我们只有三个特征,这种技术往往更多用于大量特征的更大问题,通过对算法的进一步修改,就会得到随机森林算法。
随机森林算法稳健的原因:替换采样过程已经导致算法探索了数据的许多小变化,它在训练不同的决策树,并且平均所有这些由替换采样过程引起的数据变化,这意味着对训练集的任何小的进一步改动都不太可能对整体随机森林算法的输出产生巨大的影响,因为它已经探索并平均了训练集的许多小变化。