为了构建树集成模型,需要一种叫做有放回采样的技术。
以4个标记为演示,分别是红色、黄色、绿色和蓝色,用一个黑色的袋子把这四个标记的例子放进去,然后从这个袋子里有放回地抽取四次,抽出一个标记,结果是绿色的。有放回的意思是,在拿下一个标记之前,要把之前那个放回去,再次摇一摇,然后再拿一个,是黄色的,放回去,这就是有放回的部分,然后再来一次,是蓝色的,再放回去,再抽一次,又是蓝色的,所以抽到的顺序依次是绿色、黄色、蓝色和蓝色。抽到了两次蓝色,没有抽到一次红色。如果多次重复这个有放回的抽样程序,如果在做一次,可能会得到红色、黄色、红色和绿色或者绿色、绿色、蓝色和红色或者红色,蓝色、黄色和绿色。
**注意:**有放回抽样这一点非常关键,因为如果每次抽样后不把标记放回,如果从四个标记袋中抽出四个标记,总是会得到相同的四个标记,这就是为什么每次抽出标记后放回去很重要,以确保不会只得到相同的四个标记。
有放回抽样在构建树集成方法中的应用如下:我们将构建多个随机训练集,这些训练集与原始训练集略有不同,我们将采用10个猫和狗的例子,将这10个训练例子放入一个假想的袋子中,利用这个假想的袋子,我们将创建一个新的随机训练集,由十个与原始数据集大小相同的例子组成,这样做的方法是伸手进去,拿出一个随机的训练例子,假设已经拿到了这个训练例子,然后将它放回袋子里,然后再次随机拿出一个训练例子,如此反复,你拿到例子,然后再抽一次,再抽一次。注意到现在第五个训练例子和我们上面提到的第二个是相同的,但这没关系,在抽几次,我们得到另一个重复的例子,如此反复,只到最终得到10个训练例子,其中有例子是重复的,而且这个训练集并不包含原始的10个训练例子的全部。这没关系,这是带放回抽样过程的一部分。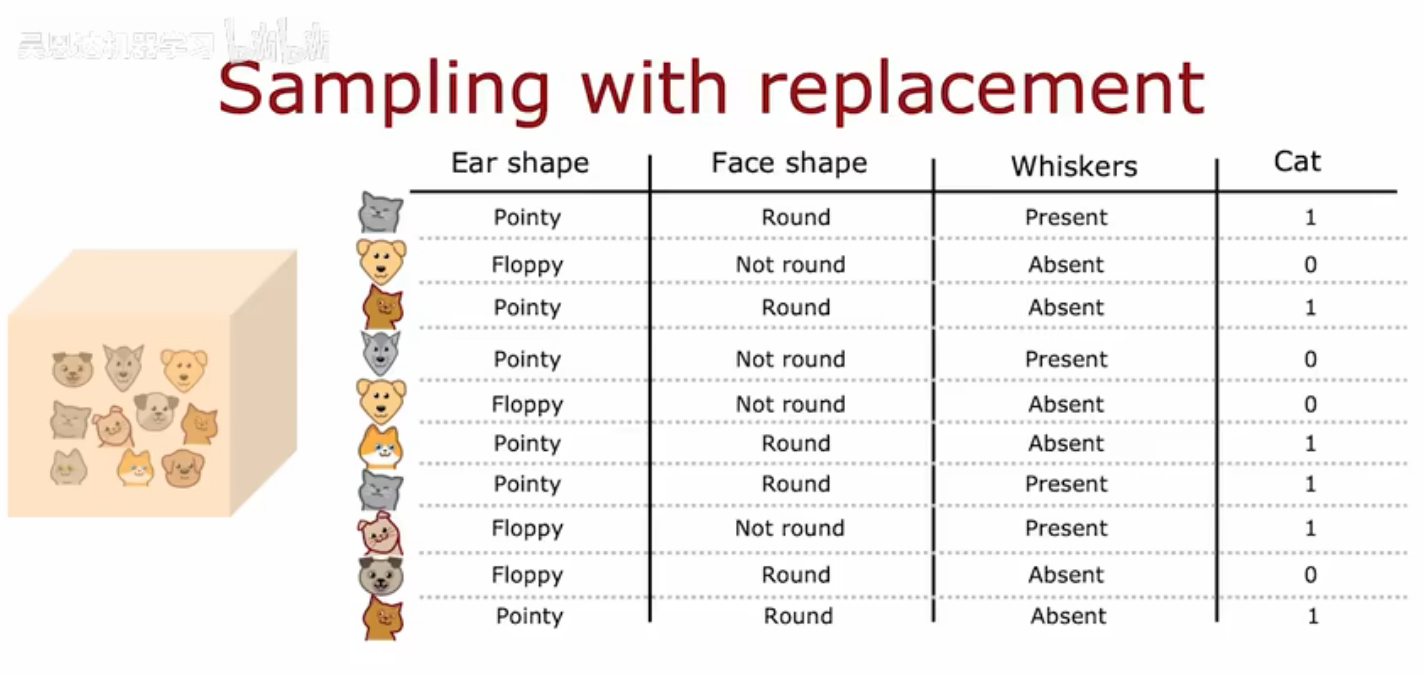
带放回抽样的过程让你构造一个有点类似于一个新的训练集,但和最初的训练就又有很大的不同,这将是构建树集成的关键构件。