hadoop集群启动没有datanode解决

问题

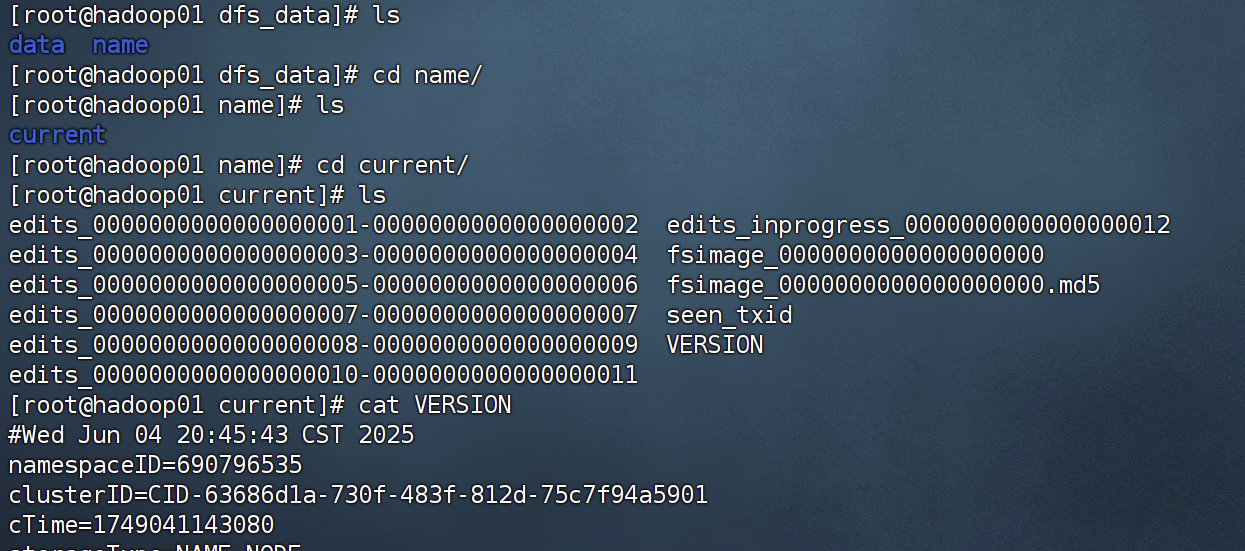
多次初始化会出现此问题,根本原因是ClusterID不一样

解决

首先停止集群

bash 复制代码
stop-all.sh

然后到/hadoop/logs中找到hadoop-root-datanode-hadoopxxx.log文件

cat一下这个文件,找到ClusterID
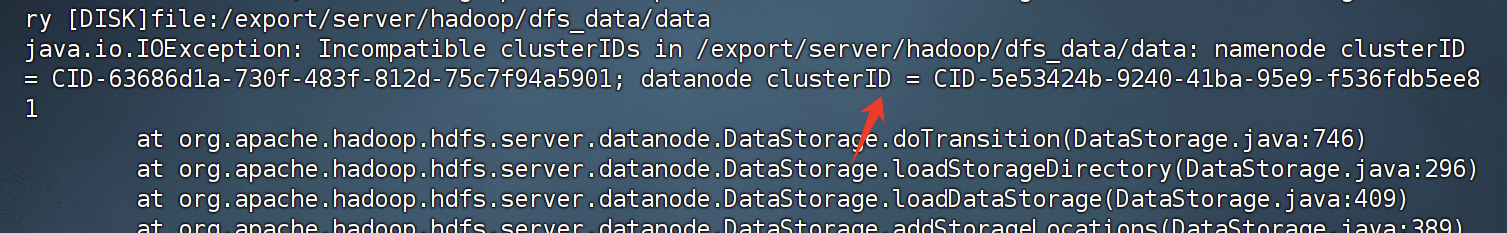
复制

然后到

可能文件会不太一样,可能直接是data或者dfs目录

这些不重要,重要的是在子目录里找到VERSION这个文件(注意有多个)
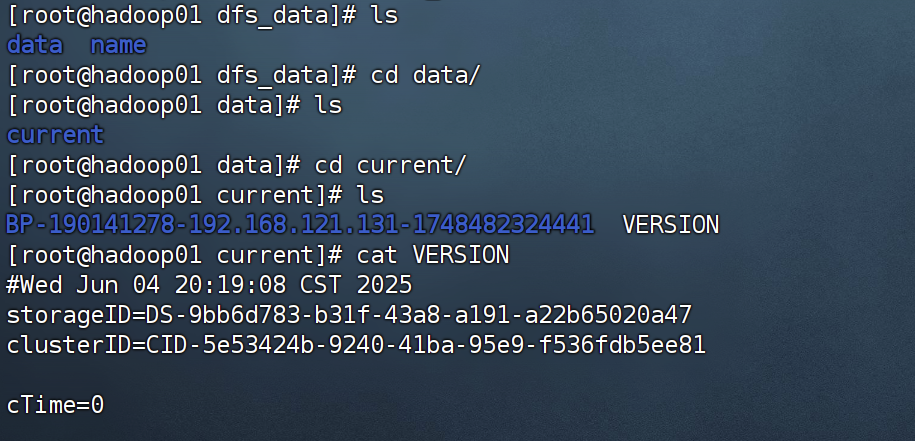
比如我这个两个目录下都有current,里面都有

把所有VERSION里的ClusterID改成刚刚复制的那个

重启,ok

相关推荐
大大大大晴天5 小时前
从 Prompt 到 Tool Calling:AI Agent 如何稳定连接程序世界
大数据·agent
key_3_feng6 小时前
反馈闭环:Agent 自我进化的真正引擎
大数据·agent
EnCi Zheng7 小时前
Agent 如何进行工具调用:从一次 Function Calling 到生产级工具编排的完整链路
大数据·人工智能·agent·ai编程·工具调用
GlobalInfo7 小时前
重磅发布 | 2026年船体清洁机器人行业研究报告:市场规模、发展前景与十五五战略地图
大数据·人工智能·机器人
海宇服务7 小时前
零信任架构实战:基于海宇全能小微企业报告构建自动化园区商户免押租赁资信核验网关
大数据·人工智能·架构·自动化
CodeGL8 小时前
开源的分布式任务调度平台:XXL-Job
分布式·开源
热文新讯8 小时前
迎进博·话疗愈:2026酒店“疗愈睡眠”闭门研讨会在沪举行
大数据·人工智能·物联网
NailiConveyor11 小时前
柔性物流方案如何适配工厂升级?自动化输送流水线定制要点
大数据·运维·自动化·制造·业界资讯
梦影_11 小时前
MySQL进阶教程(五)—— SQL调优(下)
android·大数据·数据库·后端·sql·mysql·database
没落之王11 小时前
三易五行看宋朝的三界确立
大数据·人工智能·算法