- 🍨 本文为🔗365天深度学习训练营 中的学习记录博客
- 🍖 原作者:K同学啊
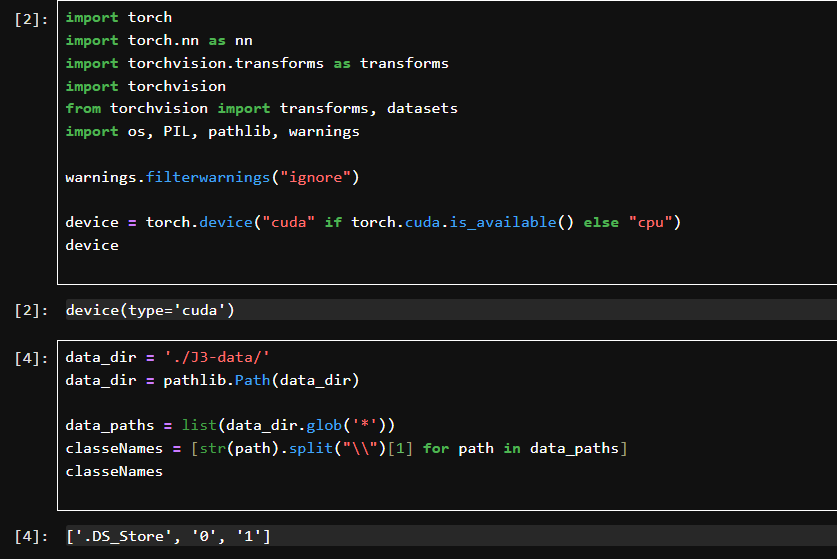
导入必要库:包括 torch(深度学习)、torchvision(图像工具)、PIL(图像处理)。
屏蔽警告信息:提升输出清晰度。
设备选择:自动使用CUDA(GPU)如果可用,否则使用CPU。
data_dir.glob('*'):获取 J3-data/ 文件夹下所有子目录。
classeNames:提取类别名称(子文件夹名)。
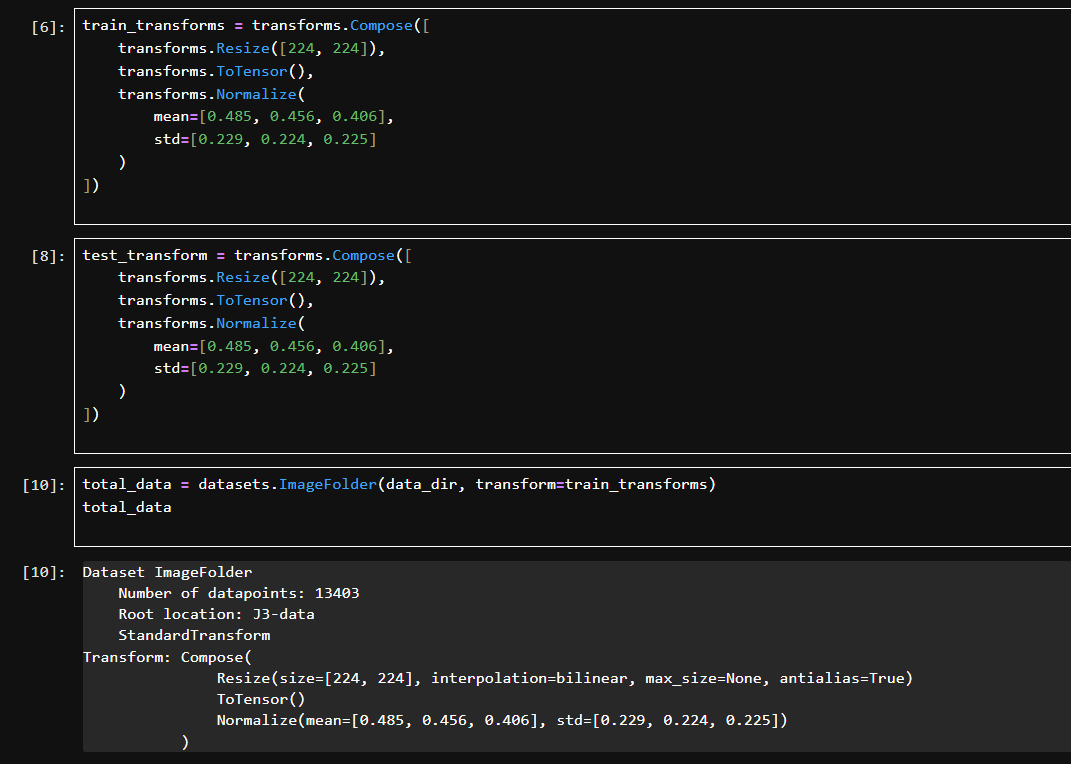
Resize:将图像大小统一为 224, 224,适配如 ResNet 等标准模型输入。
ToTensor:将PIL图像转为PyTorch Tensor,值范围 0, 1。
Normalize:图像标准化,使用 ImageNet 的均值和标准差。
ImageFolder:PyTorch 中一个通用的数据加载方式。
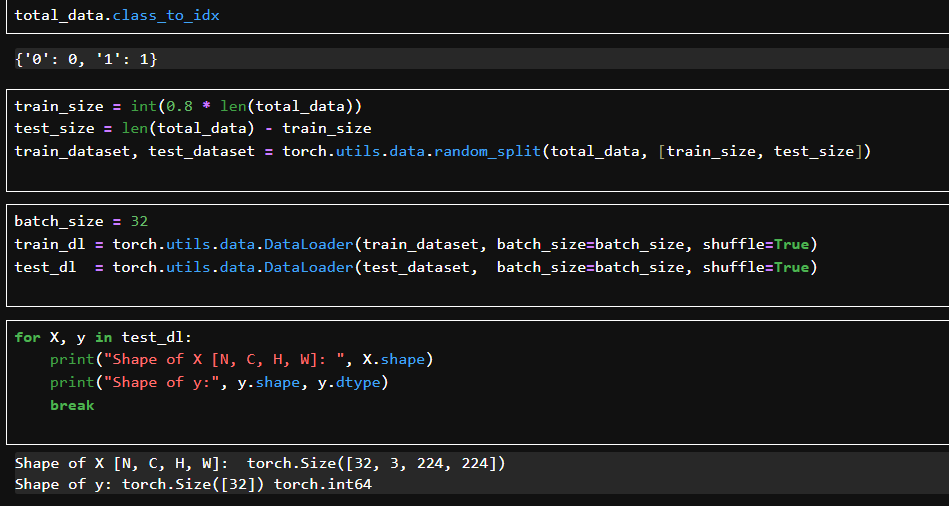
数据集 total_data 被随机划分为训练集和测试集。
使用 DataLoader 批量加载数据,支持 shuffle(打乱顺序)。
每次迭代返回的是一个批次大小为 32 的图像和标签对。
打印了数据的结构:X 是 batch_size, 通道数, 高, 宽(即 32, 3, 224, 224),y 是标签。
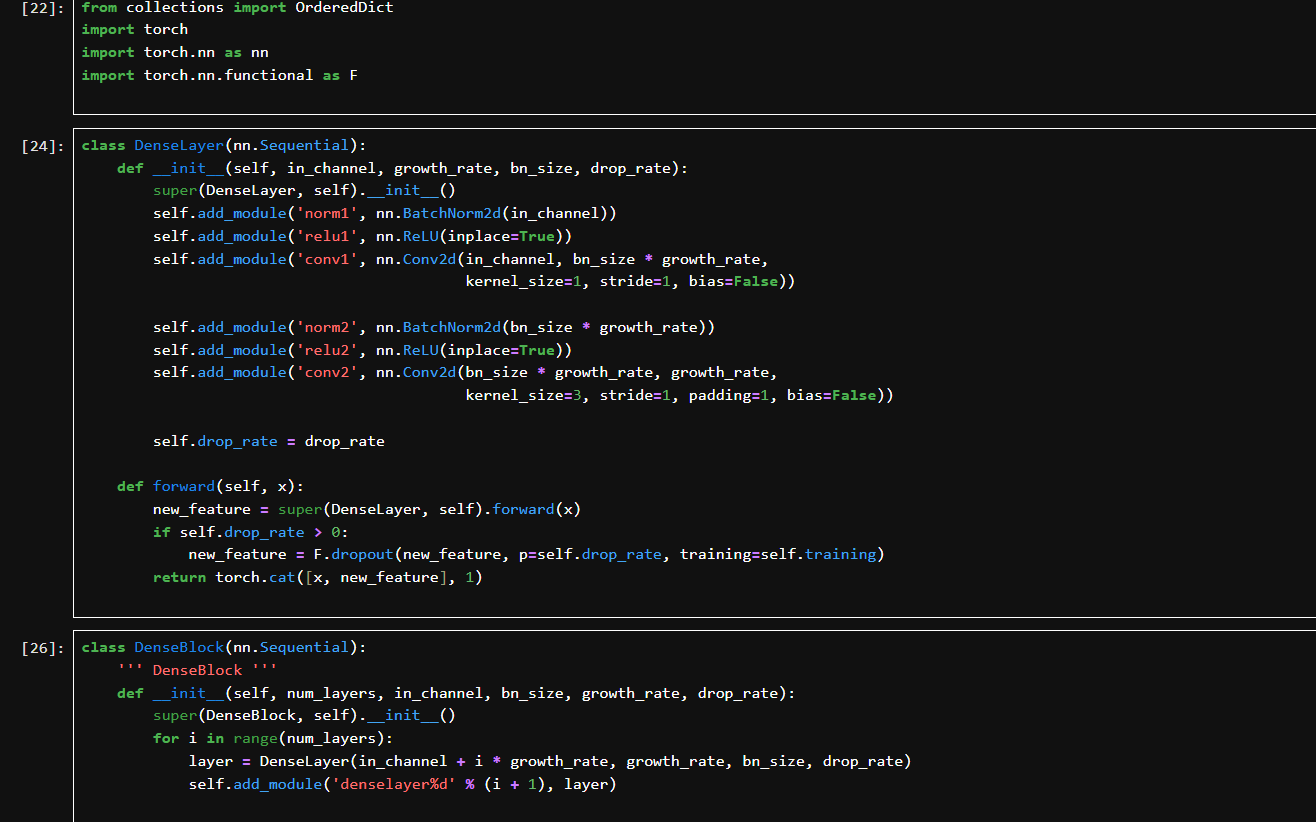
DenseLayer 模块
init () 构造函数中:
使用 1x1 卷积 作为 bottleneck(降维);
使用 3x3 卷积 提取特征;
每次输出 growth_rate 个新通道;
Dropout 用于正则化,防止过拟合。
forward() 前向传播中:
super().forward(x) 表示依次调用上面 .add_module() 添加的层;
最后用 torch.cat(x, new_feature, dim=1) 实现输入与新输出的通道拼接(DenseNet 核心特性:密集连接)。
DenseBlock 模块
num_layers 表示这个 DenseBlock 有多少个 DenseLayer;
每一层的输入通道数 = in_channel + i * growth_rate;
add_module() 将多个 DenseLayer 顺序加入到当前模块中;
输出将包含所有中间层产生的特征图。
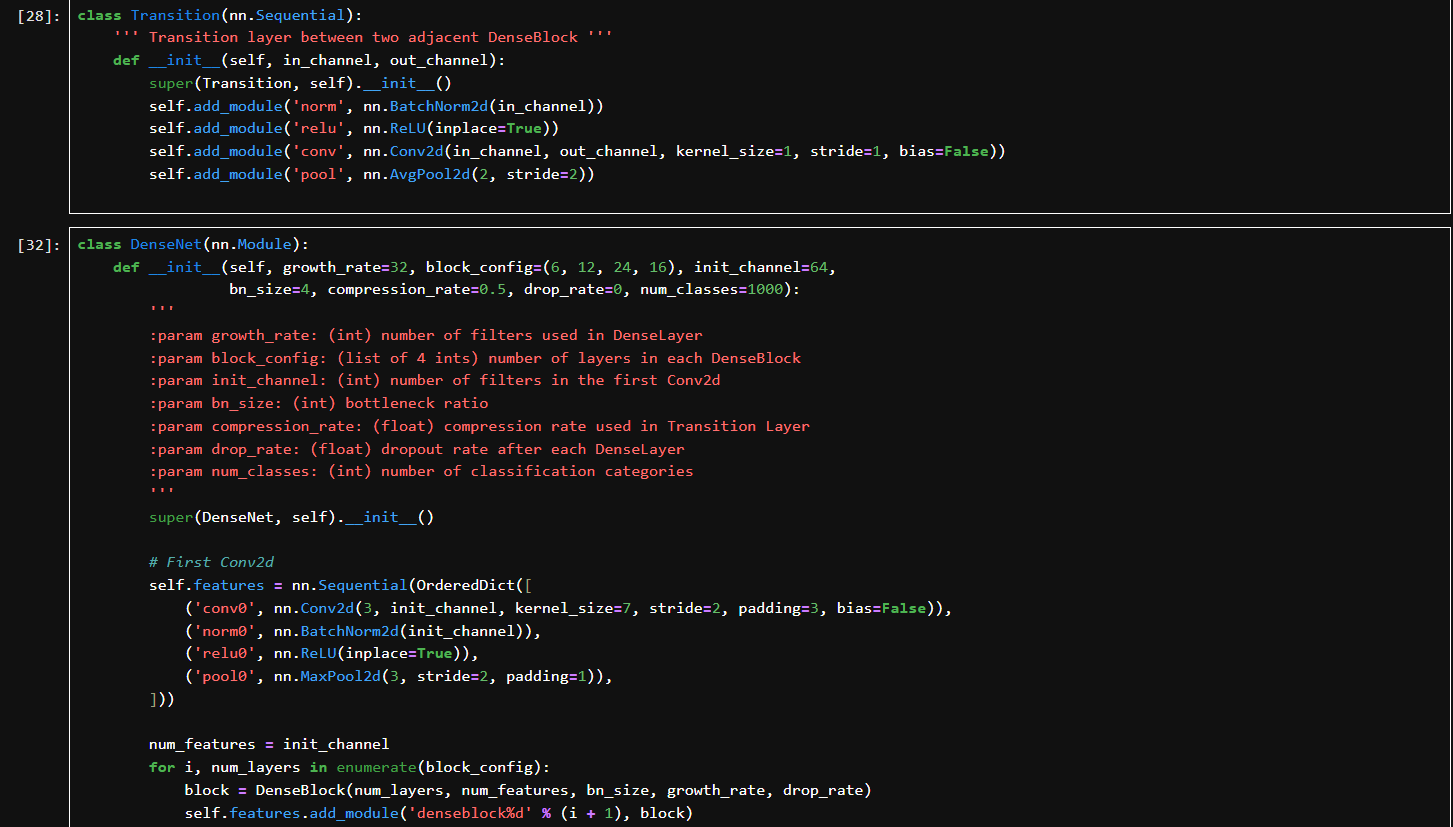
Transition 模块
用于两个 DenseBlock 之间;
压缩通道数(通过 1x1 Conv);
缩小空间尺寸(通过 AvgPool2d);
减少计算量和内存开销,防止特征爆炸。
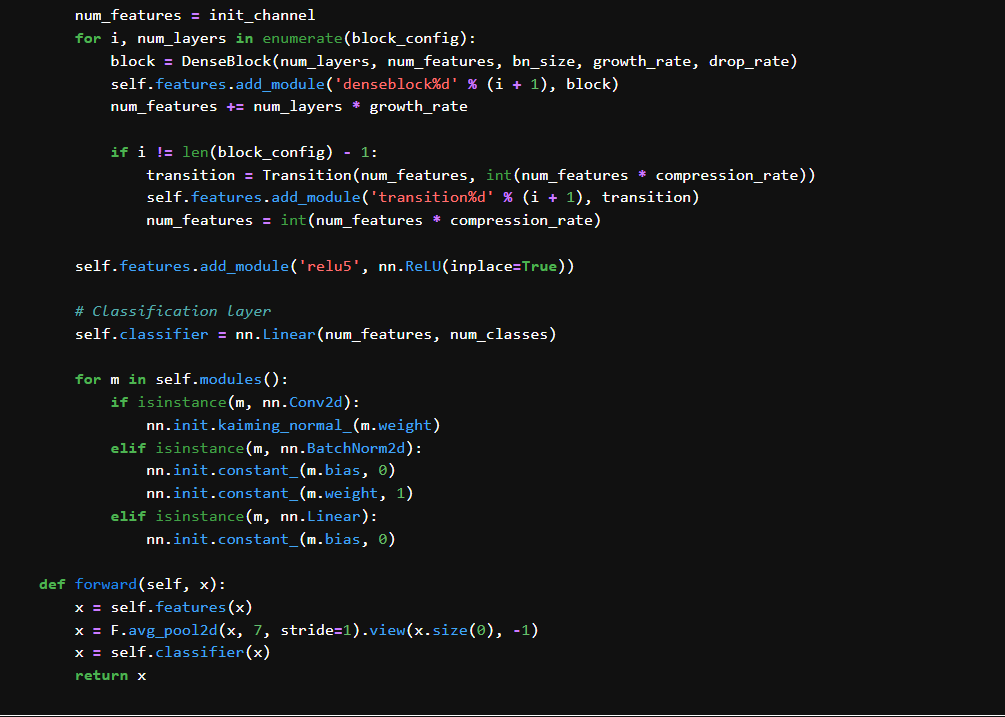
DenseNet 网络
growth_rate: 每层输出的通道数(DenseLayer 的"增长速度")
block_config: DenseBlock 的层数结构,如 6,12,24,16 表示有4个 block
init_channel: 初始卷积输出通道数
bn_size: bottleneck 通道扩展因子
compression_rate: Transition 层压缩因子(如 0.5 表示减半)
drop_rate: Dropout 率
num_classes: 输出分类数
初始卷积层(stem)
构建多个 DenseBlock + Transition
循环构建 4 个 DenseBlock;
除最后一个外,每个 block 后都加一个 Transition(降维+池化);
num_features 随每层增长:
每个 DenseLayer 输出 growth_rate 个通道。
最后 BN + ReLU + 全连接分类层
参数初始化
卷积层使用 He 初始化;
BN 和全连接层设置为常数;
保证训练稳定性和收敛速度。
前向传播函数
全部特征提取后做全局平均池化(GAP),输出大小为 batch_size, num_features;
最后通过 Linear 层完成分类。
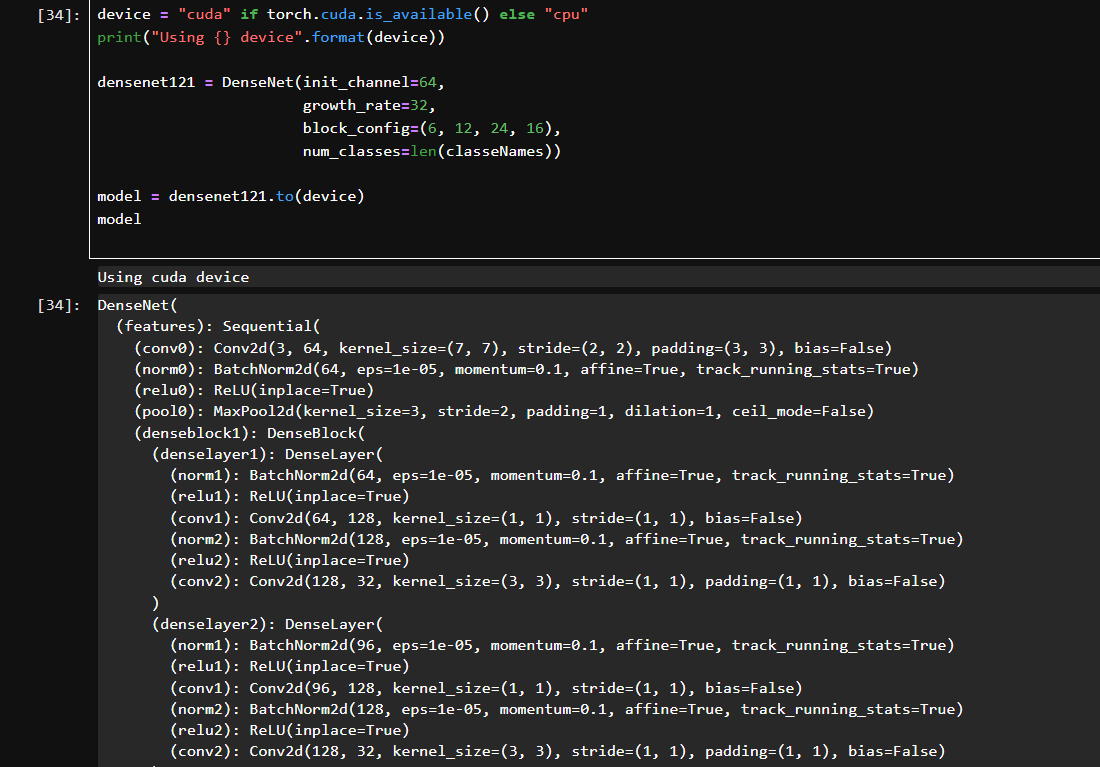
自动检测是否使用 GPU。
使用自定义的 DenseNet 类构建模型,其中 block_config=(6,12,24,16) 是 DenseNet-121 的典型结构。
num_classes,分类数。
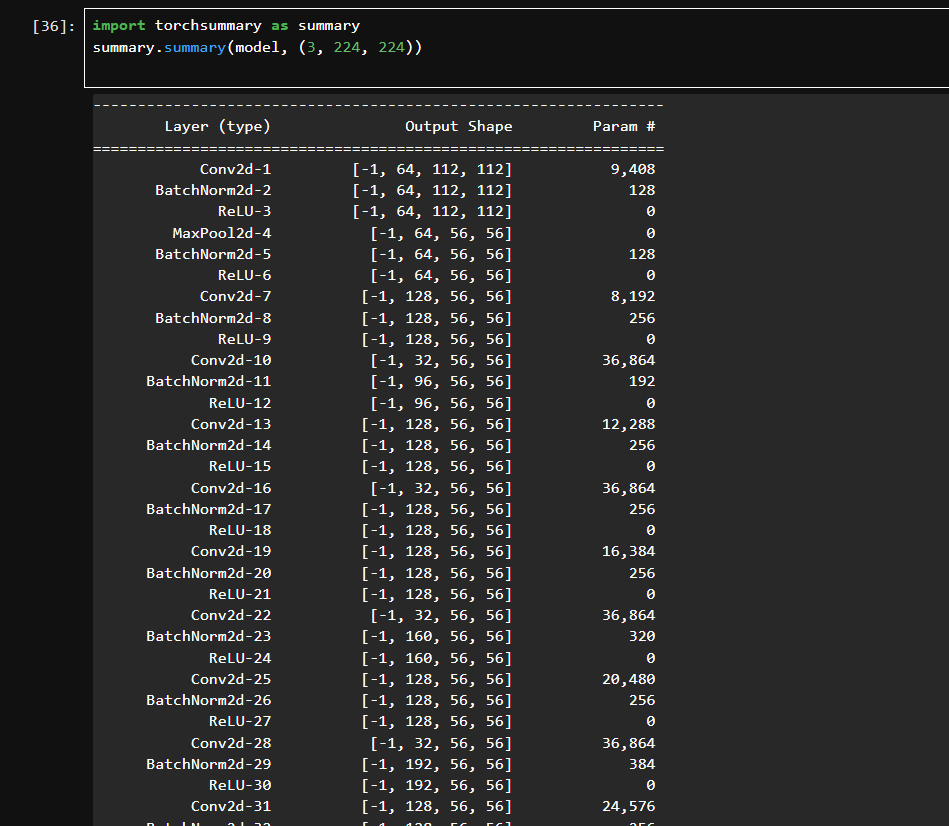
显示模型结构、每层参数量、输出尺寸。
输入为 3 通道 224×224 图像。
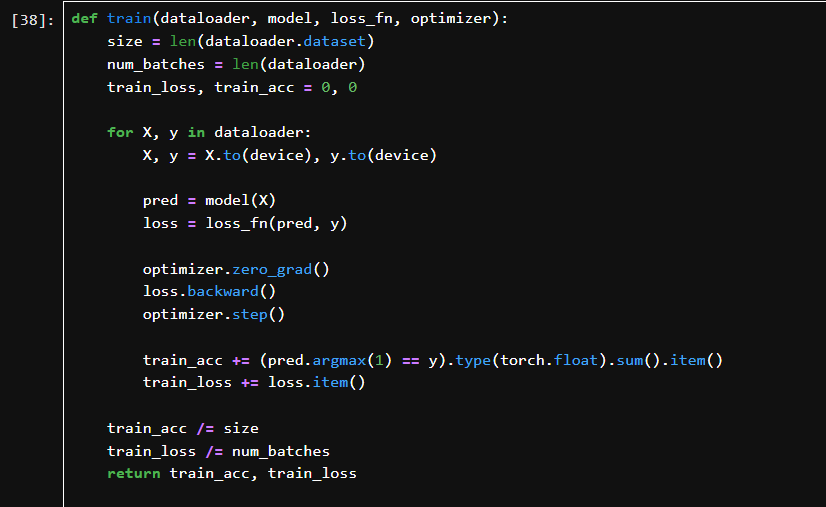
遍历每一个 batch,执行 前向传播,计算损失,反向传播,参数更新;
累计整个 epoch 的损失和准确率;
返回平均训练损失和准确率。
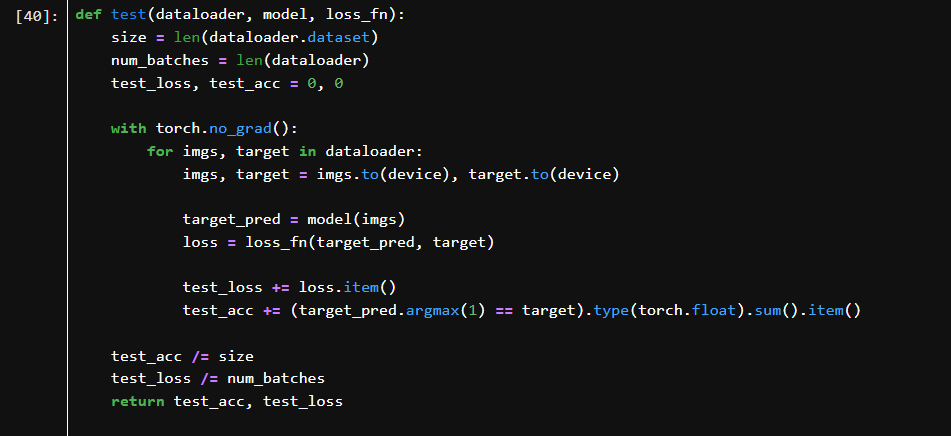
torch.no_grad() 避免记录梯度,减少内存消耗;
仅执行前向传播并计算损失、准确率。
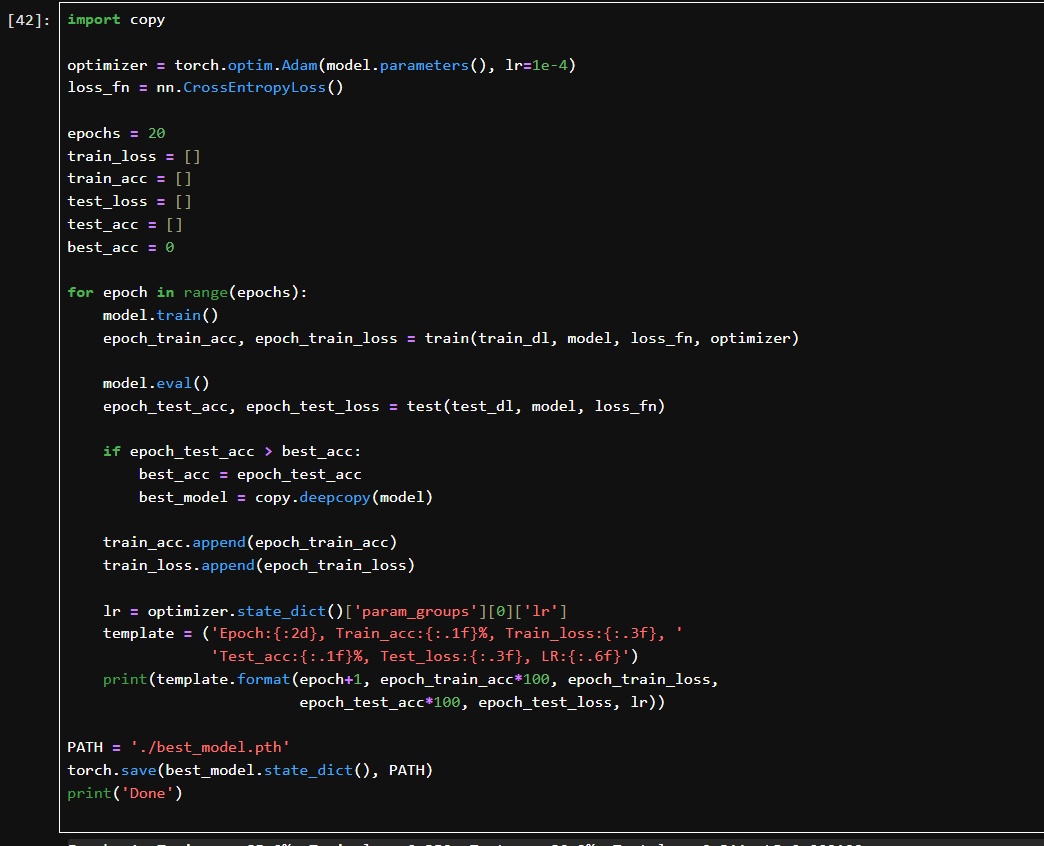
整个训练过程迭代 epochs 轮,每轮都记录训练和测试集的准确率、损失,保存测试准确率最高的模型为 best_model。
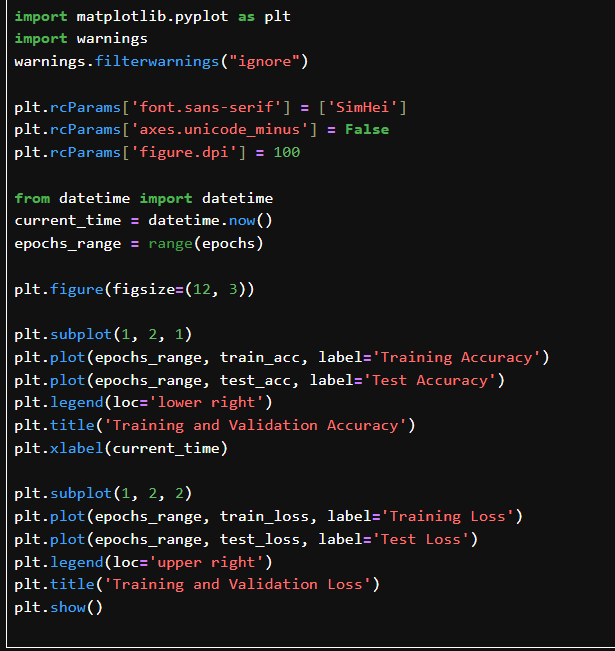
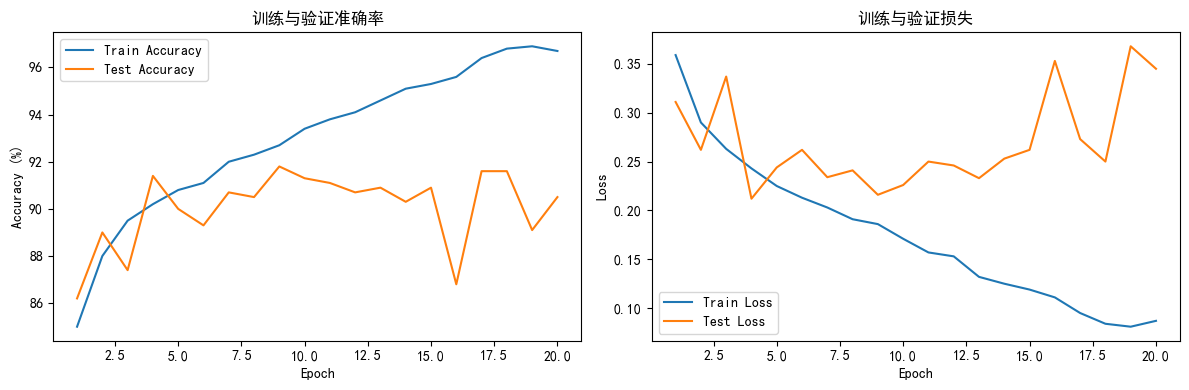
训练与验证准确率
训练准确率(蓝色):
从 85% 稳步上升至接近 97%,说明模型拟合效果很好。
验证准确率(橙色):
高位波动在 86% ~ 91% 之间;
前半段同步提升,后期开始波动,未继续随训练提升。
训练与验证损失
训练损失(蓝色):
明显下降,收敛效果好;
验证损失(橙色):
在第 4~10 epoch 区间最低。
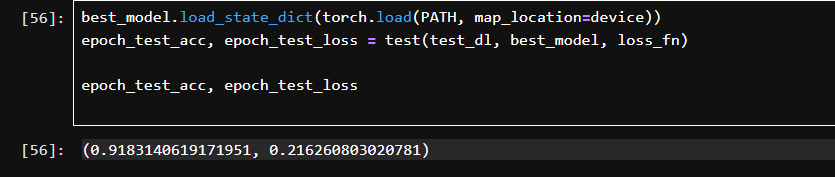
测试准确率(Test Accuracy):91.83%
测试损失(Test Loss):0.2163