引言
在机器学习和神经网络领域,损失函数(Loss Function)是衡量模型预测值与真实值之间差异的关键指标。均方误差(Mean Squared Error, MSE)作为一种经典的损失函数,因其简单性、可解释性和数学上的优良性质,在回归问题中得到了广泛应用。本文将深入探讨MSE的定义、原理、应用场景、优缺点以及在神经网络中的实现细节。
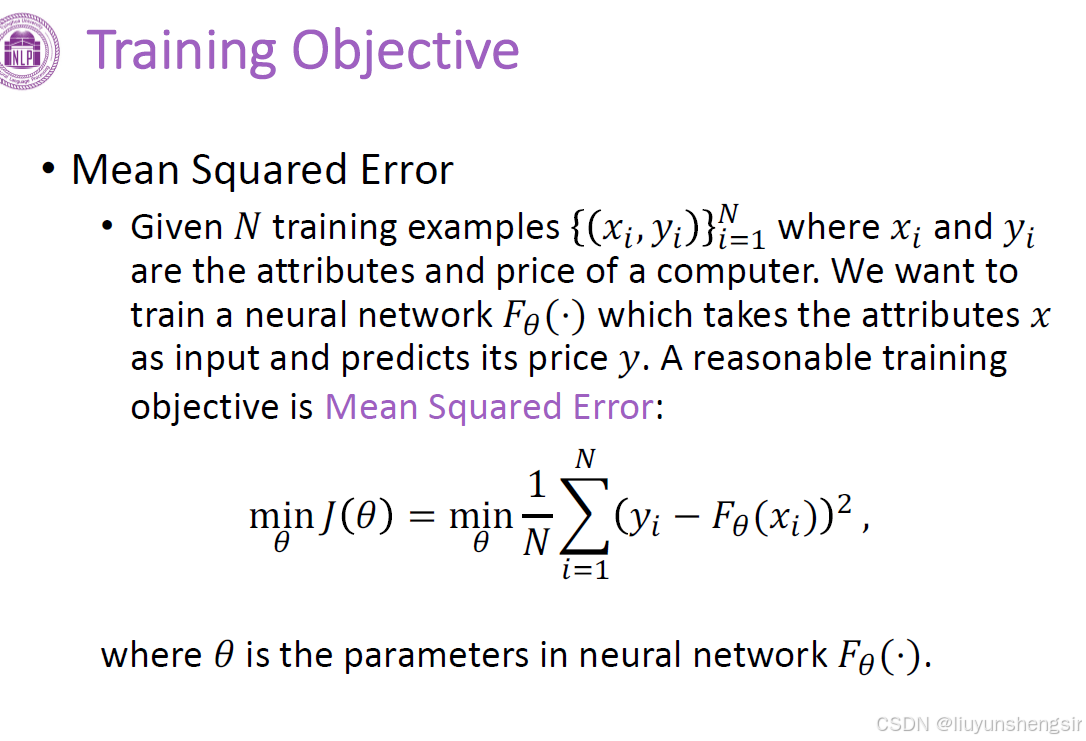
均方误差的定义
均方误差是预测值与真实值之间差异的平方的平均值。对于一组包含( n )个样本的数据集,其数学表达式为:

MSE的原理与性质
1. 数学性质
- 可微性:MSE是连续且可微的,这使得它非常适合用于基于梯度的优化算法(如随机梯度下降)。
- 凸性:在线性回归问题中,MSE是一个凸函数,这意味着它有唯一的全局最小值,优化过程不会陷入局部最优。
- 平方惩罚:MSE对较大的误差给予更大的惩罚(因为误差被平方),这使得模型对异常值(outliers)较为敏感。
2. 几何解释
从几何角度看,MSE可以理解为预测值与真实值之间的欧氏距离的平方。最小化MSE相当于在( n )维空间中找到一个点,使得该点到所有真实值点的距离平方和最小。
MSE在神经网络中的应用
1. 回归问题
在回归任务中,模型的输出是连续值(如房价预测、股票价格预测等)。MSE作为损失函数,可以有效地衡量模型预测值与真实值之间的差异。例如,在房价预测模型中,MSE可以帮助模型学习到房价与房屋特征(如面积、卧室数量等)之间的复杂关系。
2. 神经网络训练
在神经网络的训练过程中,MSE通常作为损失函数的一部分,与优化算法(如Adam、RMSprop等)结合使用。通过反向传播算法,计算损失函数关于模型参数的梯度,然后更新参数以最小化损失。
3. 代码示例(使用PyTorch)
python
import torch
import torch.nn as nn
import torch.optim as optim

# 定义一个简单的神经网络
class SimpleNN(nn.Module):
    def __init__(self):
        super(SimpleNN, self).__init__()
        self.fc1 = nn.Linear(10, 5)  # 输入层到隐藏层
        self.fc2 = nn.Linear(5, 1)   # 隐藏层到输出层

    def forward(self, x):
        x = torch.relu(self.fc1(x))
        x = self.fc2(x)
        return x

# 创建模型、损失函数和优化器
model = SimpleNN()
criterion = nn.MSELoss()  # 使用MSE作为损失函数
optimizer = optim.Adam(model.parameters(), lr=0.001)

# 模拟数据
inputs = torch.randn(100, 10)  # 100个样本,每个样本10个特征
targets = torch.randn(100, 1)  # 100个真实值

# 训练循环
for epoch in range(100):
    optimizer.zero_grad()  # 清空梯度
    outputs = model(inputs)  # 前向传播
    loss = criterion(outputs, targets)  # 计算损失
    loss.backward()  # 反向传播
    optimizer.step()  # 更新参数

    if (epoch+1) % 10 == 0:
        print(f'Epoch [{epoch+1}/100], Loss: {loss.item():.4f}')
MSE的优缺点
优点
- 简单直观:MSE的计算和理解都非常简单,易于实现和调试。
- 数学性质优良:可微性和凸性使得它适合用于基于梯度的优化算法。
- 对误差的敏感度:平方惩罚使得模型对较大的误差更加敏感,有助于提高模型的精度。
缺点
- 对异常值敏感:由于平方惩罚,MSE对异常值(outliers)非常敏感,可能导致模型在异常值上过度拟合。
- 单位不一致:MSE的单位是真实值单位的平方,这可能使得损失值的解释性变差。
- 非负性:虽然非负性是一个优点(因为损失总是非负的),但在某些情况下,可能需要考虑其他损失函数来捕捉更复杂的误差分布。
改进与变体
为了克服MSE的缺点,研究者们提出了多种改进和变体:

-
Huber损失 :
Huber损失结合了MSE和MAE的优点,对小误差使用MSE,对大误差使用MAE,从而减少异常值的影响。
-
加权MSE :
在某些情况下,不同样本的重要性可能不同。加权MSE通过为每个样本分配不同的权重来考虑这种差异。
实际应用中的考虑
在实际应用中,选择损失函数需要综合考虑以下因素:
- 问题类型:回归问题通常使用MSE或其变体,而分类问题则使用交叉熵等损失函数。
- 数据特性:如果数据中包含大量异常值,可能需要考虑使用对异常值不敏感的损失函数。
- 模型复杂度:复杂的模型可能需要更复杂的损失函数来捕捉数据的内在结构。
- 计算资源:某些损失函数(如Huber损失)的计算可能比MSE更复杂,需要更多的计算资源。
结论
均方误差(MSE)作为神经网络和机器学习中的经典损失函数,因其简单性、可解释性和数学上的优良性质,在回归问题中得到了广泛应用。然而,MSE也存在对异常值敏感等缺点,需要根据具体问题选择合适的损失函数或其变体。在实际应用中,理解损失函数的性质和适用场景,对于构建高效、准确的模型至关重要。通过不断探索和改进,我们可以更好地利用损失函数来指导模型的训练和优化。