Python练习:读取Apple Plist文件
Plist文件简介
- 定义:Apple公司创建的基于XML结构的文件格式
- 特点:采用XML语法组织数据,可存储键值对、数组等结构化信息
- 文件扩展名:.plist
- 应用场景:
iOS系统: 应用描述文件(权限配置:蓝牙/网络访问/GameCenter等)IPA安装包中的配置信息
macOS系统: .app应用的配置文件 系统偏好设置存储
苹果生态 iTunes音乐播放列表 Xcode项目配置
Python操作库:plistlib
python
import plistlib代码适配指南(Python 2 → Python 3)
废弃方法(Python 2旧版)
plist = plistlib.read(filename)
正确方法(Python 3新版)
python
with open(filename, 'rb') as plist_file:
    plist = plistlib.load(plist_file)
注意事项
- 始终使用二进制模式('rb')打开文件 Python
- 3.4+ 支持load()/dump()替代旧版API
- macOS内置plutil工具可验证文件有效性:bash 下运行下面的代码
plutil -lint Example.plist
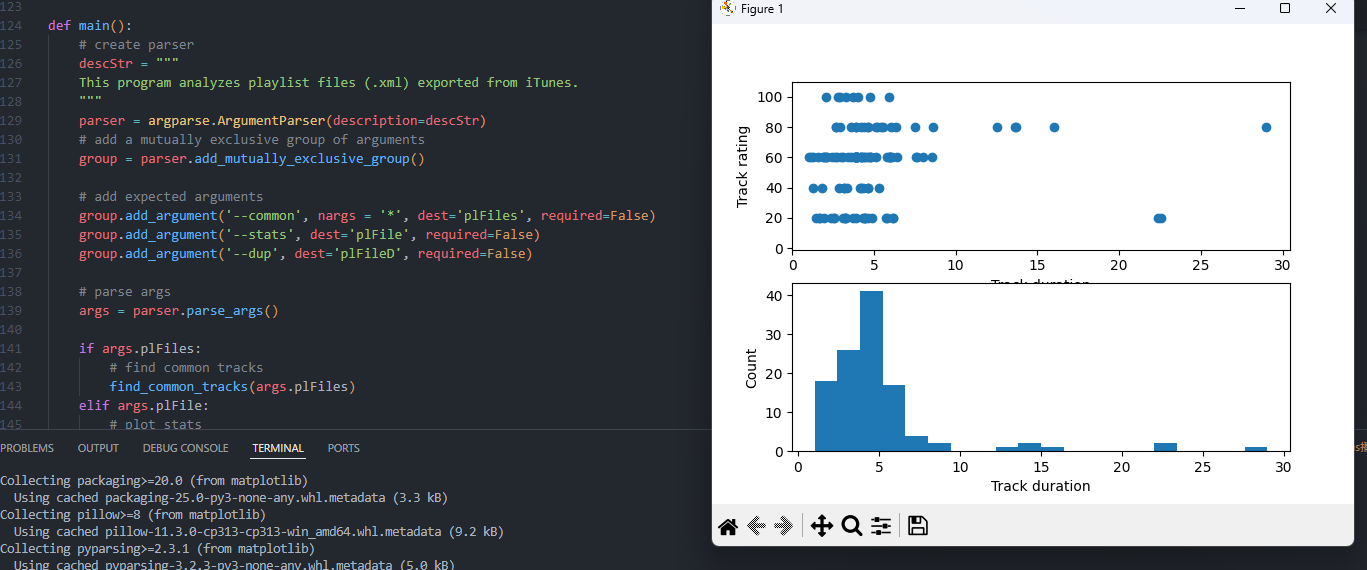
下文是练习代码,其中也包含了画图部分
练习代码:
python
import re, argparse
import sys
from matplotlib import pyplot
import plistlib
import numpy as np


# 找到重复的音乐
def find_duplicates(file_name):
    print("Find duplicate tracks in %s..." % file_name)
    with open(file_name, 'rb') as f:
        plist = plistlib.load(f)
    # 读取playlist
    # 获取音轨目录
    tracks = plist['Tracks']
    # 创建音轨字典
    track_names = {}
    # 结构:{name:(duration,count)}
    # 遍历 添加
    for track_id, track in tracks.items():
        try:
            name = track['name']
            duration = track['Total Time']
            # 检查是不是以及在在字典里面了
            if name in track_names:
            # 匹配 歌曲名称和时长
                if duration // 1000 == track_names['name'][0] // 1000:
                    count = track_names[name][1]
                    track_names[name] = (duration, count + 1)
            else:
                # 不匹配的情况下
                track_names[name] = (duration, count)
        except:
            # ignore
            pass
    # 保存重复的音轨, name, count
    dups = []
    for k, v in track_names.items():
        if v[1] > 1:
            dups.append(k, v[1])
    # 保存到一个文件
    if len(dups) > 0:
        print("发现一共有%d个重复的文件, 以及保存到了dup.txt中" % len(dups))
    else:
        print("没有发现任何重复的文件")
    f = open("dups.txt", "w")
    for val in dups:
        f.writable("[%d] %s \n" % (val[0], val[1]))
    f.close()


# 查找多个播放列表中的共同的音轨
def find_common_tracks(file_names):
    # a list of sets of track names
    track_name_sets = []
    # 遍历读取多个plist文件
    for file_name in file_names:
        track_names = set()
        with open(file_name, 'rb') as f:
            plist = plistlib.load(f)
        # 获取音轨节点
        tracks = plist.get("Tracks", {})
        # 遍历迭代
        for track_id, track in tracks.items():
            try:
                track_names.add(track['Name'])
            except:
                # ignore
                pass
    # 添加到track_name_sets中
    track_name_sets.append(track_names)
    # 交集处理
    common_tracks = set.intersection(*track_name_sets)
    # 写文件
    if len(common_tracks) > 0:
        f = open("common.txt", "w")
        for val in common_tracks:
            # s = "%s\n" % val
            f.write(f"{val}\n")
        f.close()
        print(f"Track names wirte to common.txt { len(common_tracks)}")
    else:
        print("No common tracks!")

# 收集歌曲评分和时长
def plot_stats(file_name):
    # 读取播放列表
    with open(file_name, 'rb') as f:
        plist = plistlib.load(f)
    tracks = plist['Tracks']
    # 创建音轨排序和时长
    ratings = []
    durations = []
    for track_id, track in tracks.items():
        try:
            ratings.append(track['Album Rating'])
            durations.append(track['Total Time'])
        except:
            # ignore
            pass
    # 确保是有效数据
    if ratings == [] or durations == []:
        print(f"在文件中%s没有有效的Album Rating/Total Time  数据 {file_name}")
        return
     # scatter plot
    x= np.array(durations, np.int32)
    # convert to minutes
    x = x/60000.0
    y = np.array(ratings, np.int32)
    pyplot.subplot(2, 1, 1)
    pyplot.plot(x, y, 'o')
    pyplot.axis([0, 1.05*np.max(x), -1, 110])
    pyplot.xlabel('Track duration')
    pyplot.ylabel('Track rating')
    # plot histogram
    pyplot.subplot(2, 1, 2)
    pyplot.hist(x, bins=20)
    pyplot.xlabel('Track duration')
    pyplot.ylabel('Count')
    # show plot
    pyplot.show()

def main():
    # create parser
    descStr = """
    This program analyzes playlist files (.xml) exported from iTunes.
    """
    parser = argparse.ArgumentParser(description=descStr)
    # add a mutually exclusive group of arguments
    group = parser.add_mutually_exclusive_group()

    # add expected arguments
    group.add_argument('--common', nargs = '*', dest='plFiles', required=False)
    group.add_argument('--stats', dest='plFile', required=False)
    group.add_argument('--dup', dest='plFileD', required=False)

    # parse args
    args = parser.parse_args()

    if args.plFiles:
        # find common tracks
        find_common_tracks(args.plFiles)
    elif args.plFile:
        # plot stats
        plot_stats(args.plFile)
    elif args.plFileD:
        # find duplicate tracks
        find_duplicates(args.plFileD)
    else:
        print("These are not the tracks you are looking for.")

if __name__ == "__main__":
    main()
最后这个是画图的部分,以后有兴趣再研究吧