介绍
由于业务需要,想了解目前主要社交短视频平台热点内容,提高业务的曝光点,基于此我们可以爬取目前主流短视频平台的热搜内容,来了解当下最热门的信息
技术实现
主要是采用成熟的爬虫技术来实现,本文主要是以开源的框架MediaCrawler来介绍
环境搭建
下载代码
bash
git clone https://github.com/NanmiCoder/MediaCrawler.git
cd MediaCrawle
修改配置,以mysql数据库形式保存爬取的内容
bash
vim /config/base_config.py
修改配置项:SAVE_DATA_OPTION值为"db",默认是json
新增配置项:RELATIONAL_DB_TYPE = "mysql"
vim /config/db_config.py
修改mysql的如下配置:
MYSQL_DB_PWD = os.getenv("MYSQL_DB_PWD", "Test2025!!!!")
MYSQL_DB_USER = os.getenv("MYSQL_DB_USER", "root")
MYSQL_DB_HOST = os.getenv("MYSQL_DB_HOST", "localhost")
MYSQL_DB_PORT = os.getenv("MYSQL_DB_PORT", 3306)
MYSQL_DB_NAME = os.getenv("MYSQL_DB_NAME", "media_crawler")
安装虚拟环境:
bash
uv sync
uv run playwright install
初始化数据库
bash
# 初始化 MySQL 数据库
uv run main.py --init_db mysql
运行爬虫程序-爬取xhs热点内容
bash
uv run main.py --platform xhs --lt qrcode --type search --keywords "热点"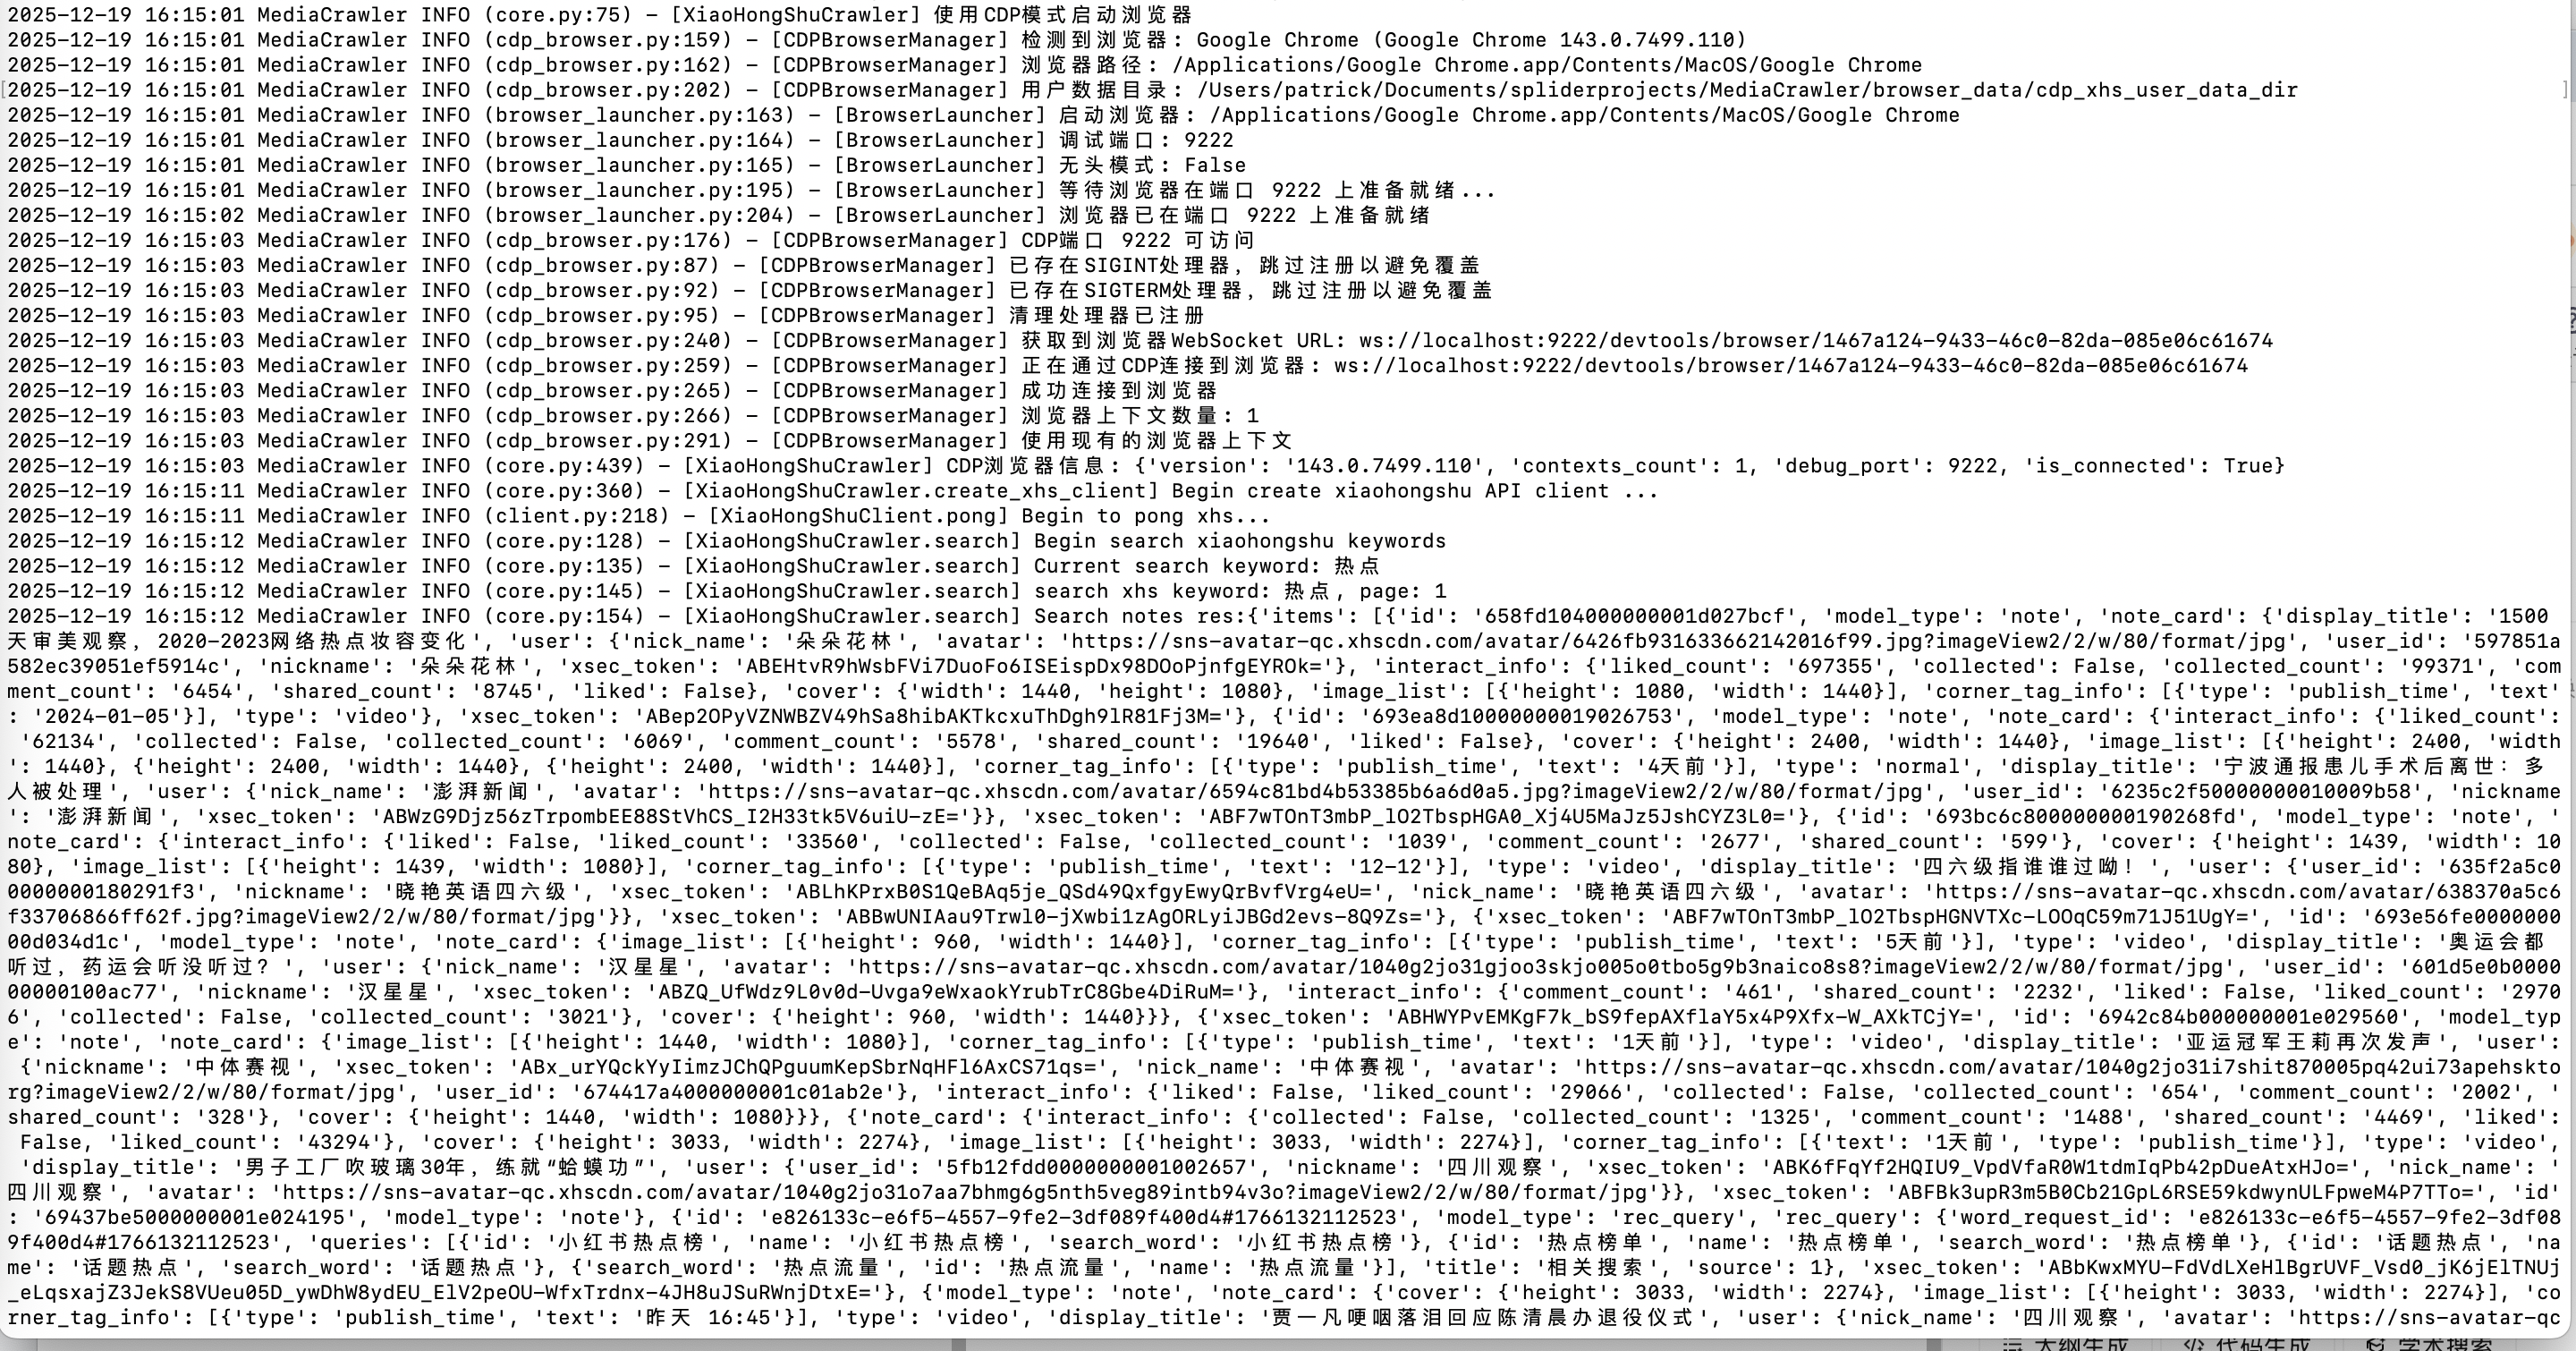
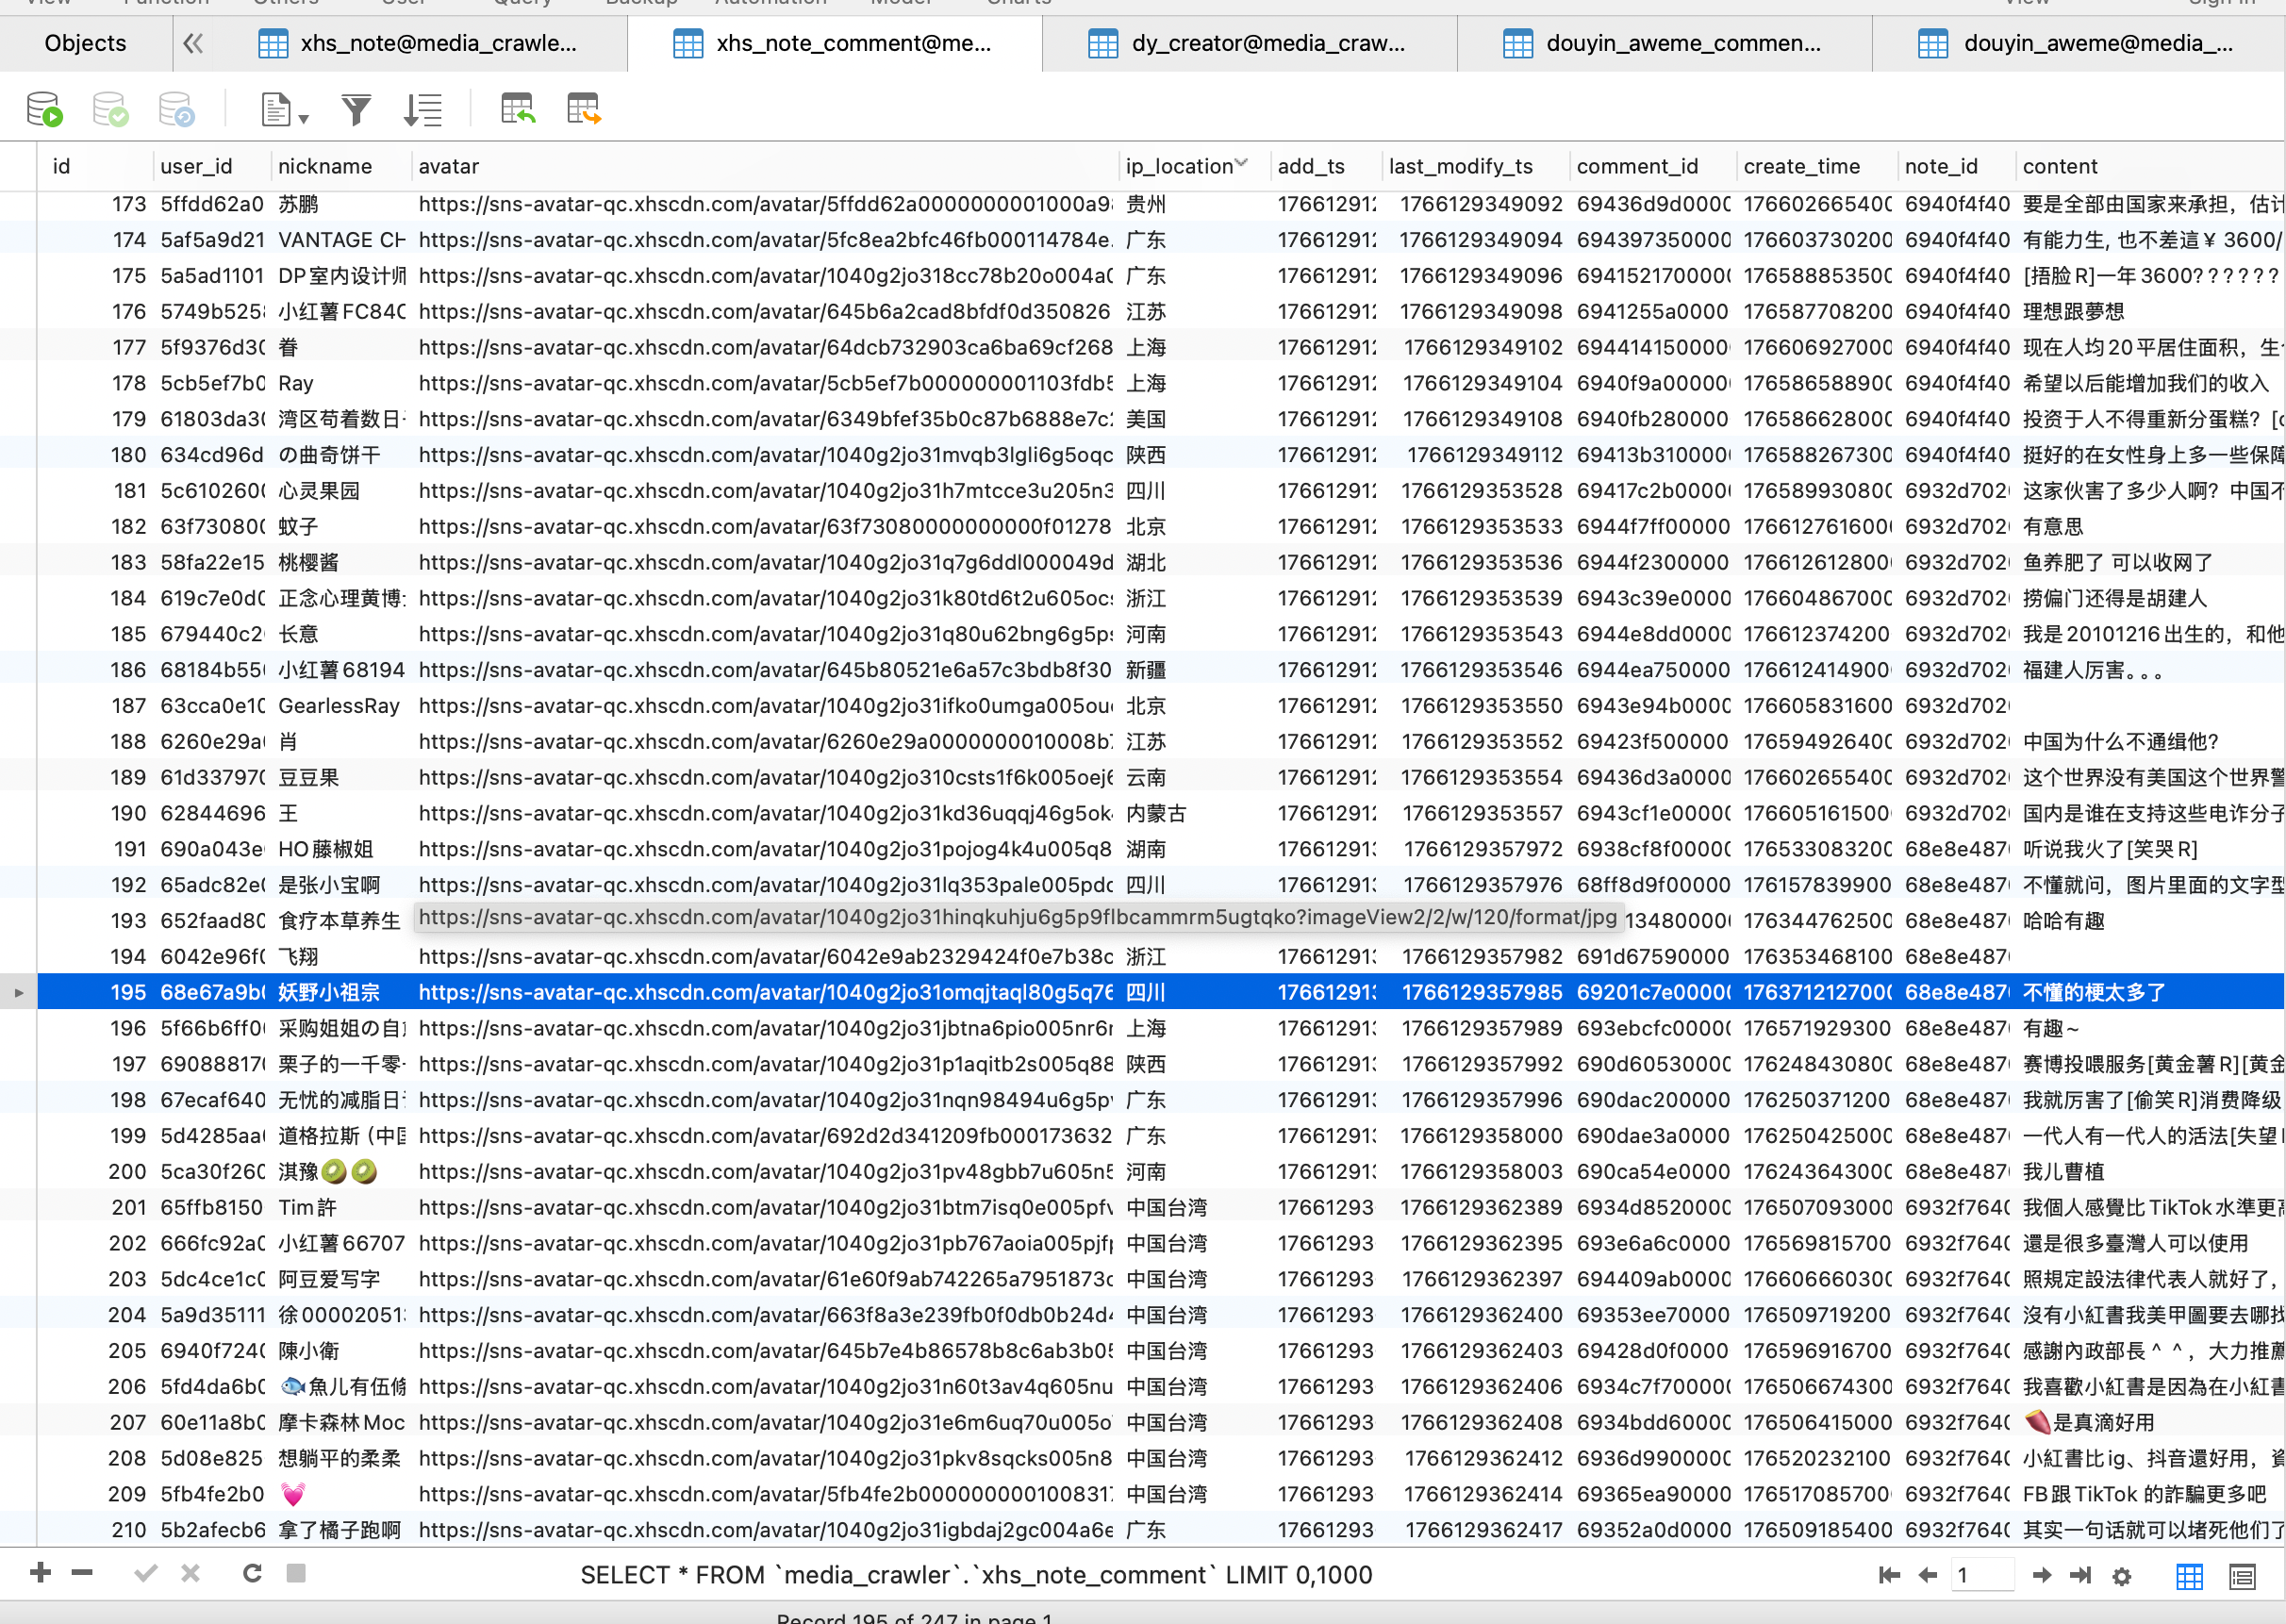
保存的数据在数据库中的表:
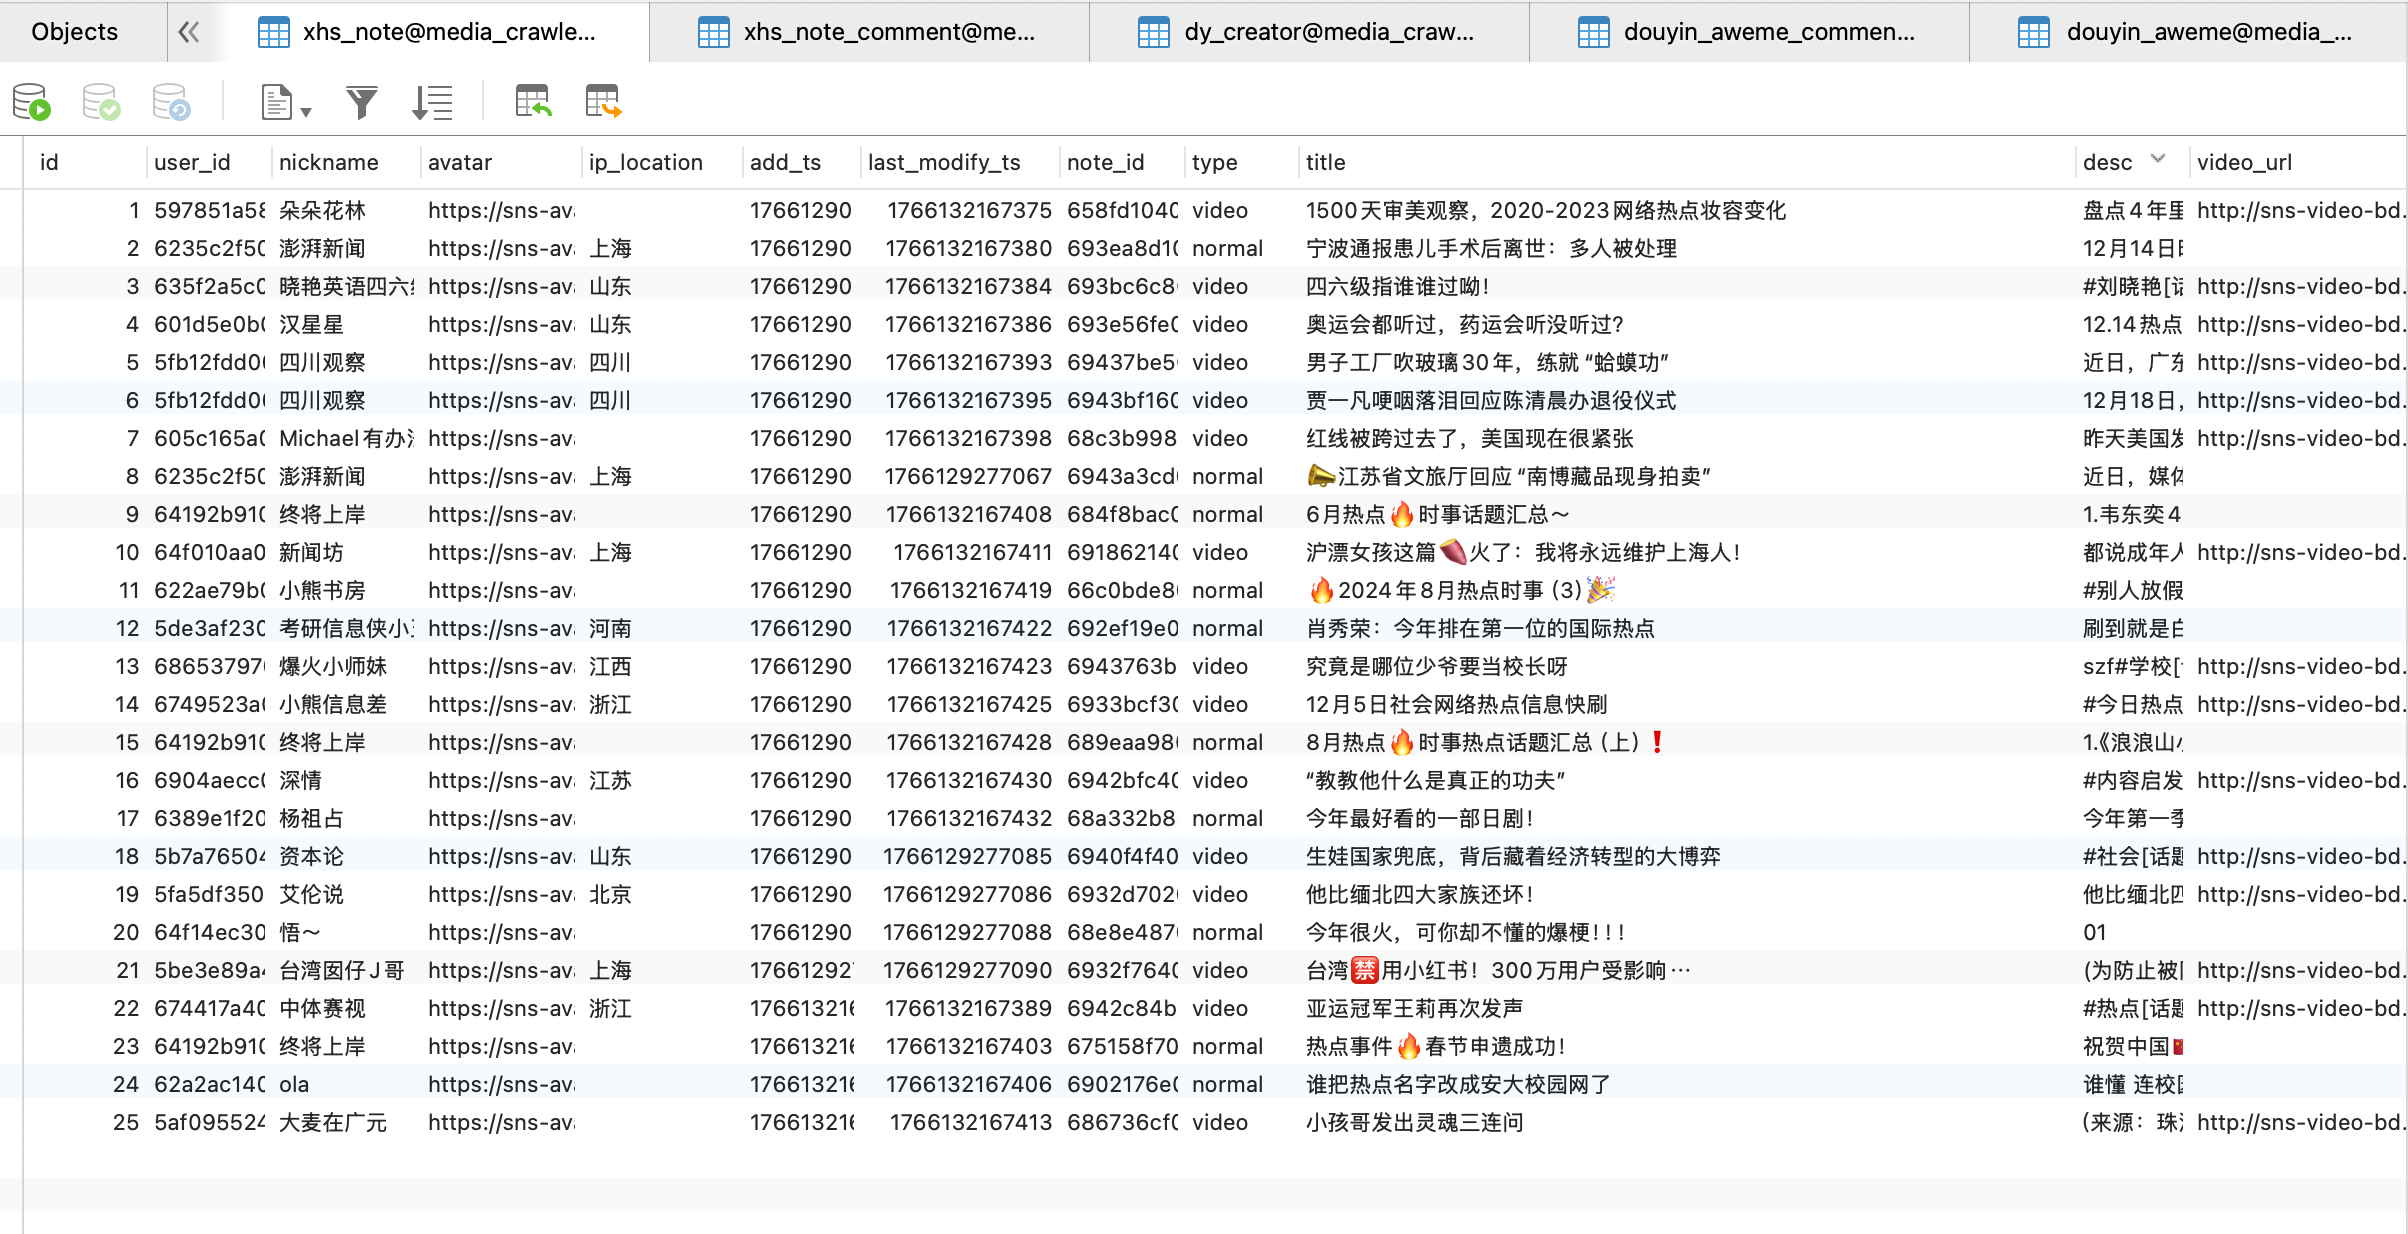
运行爬虫程序-爬取dy热点内容
bash
uv run main.py --platform dy --lt qrcode --type search --keywords "热点"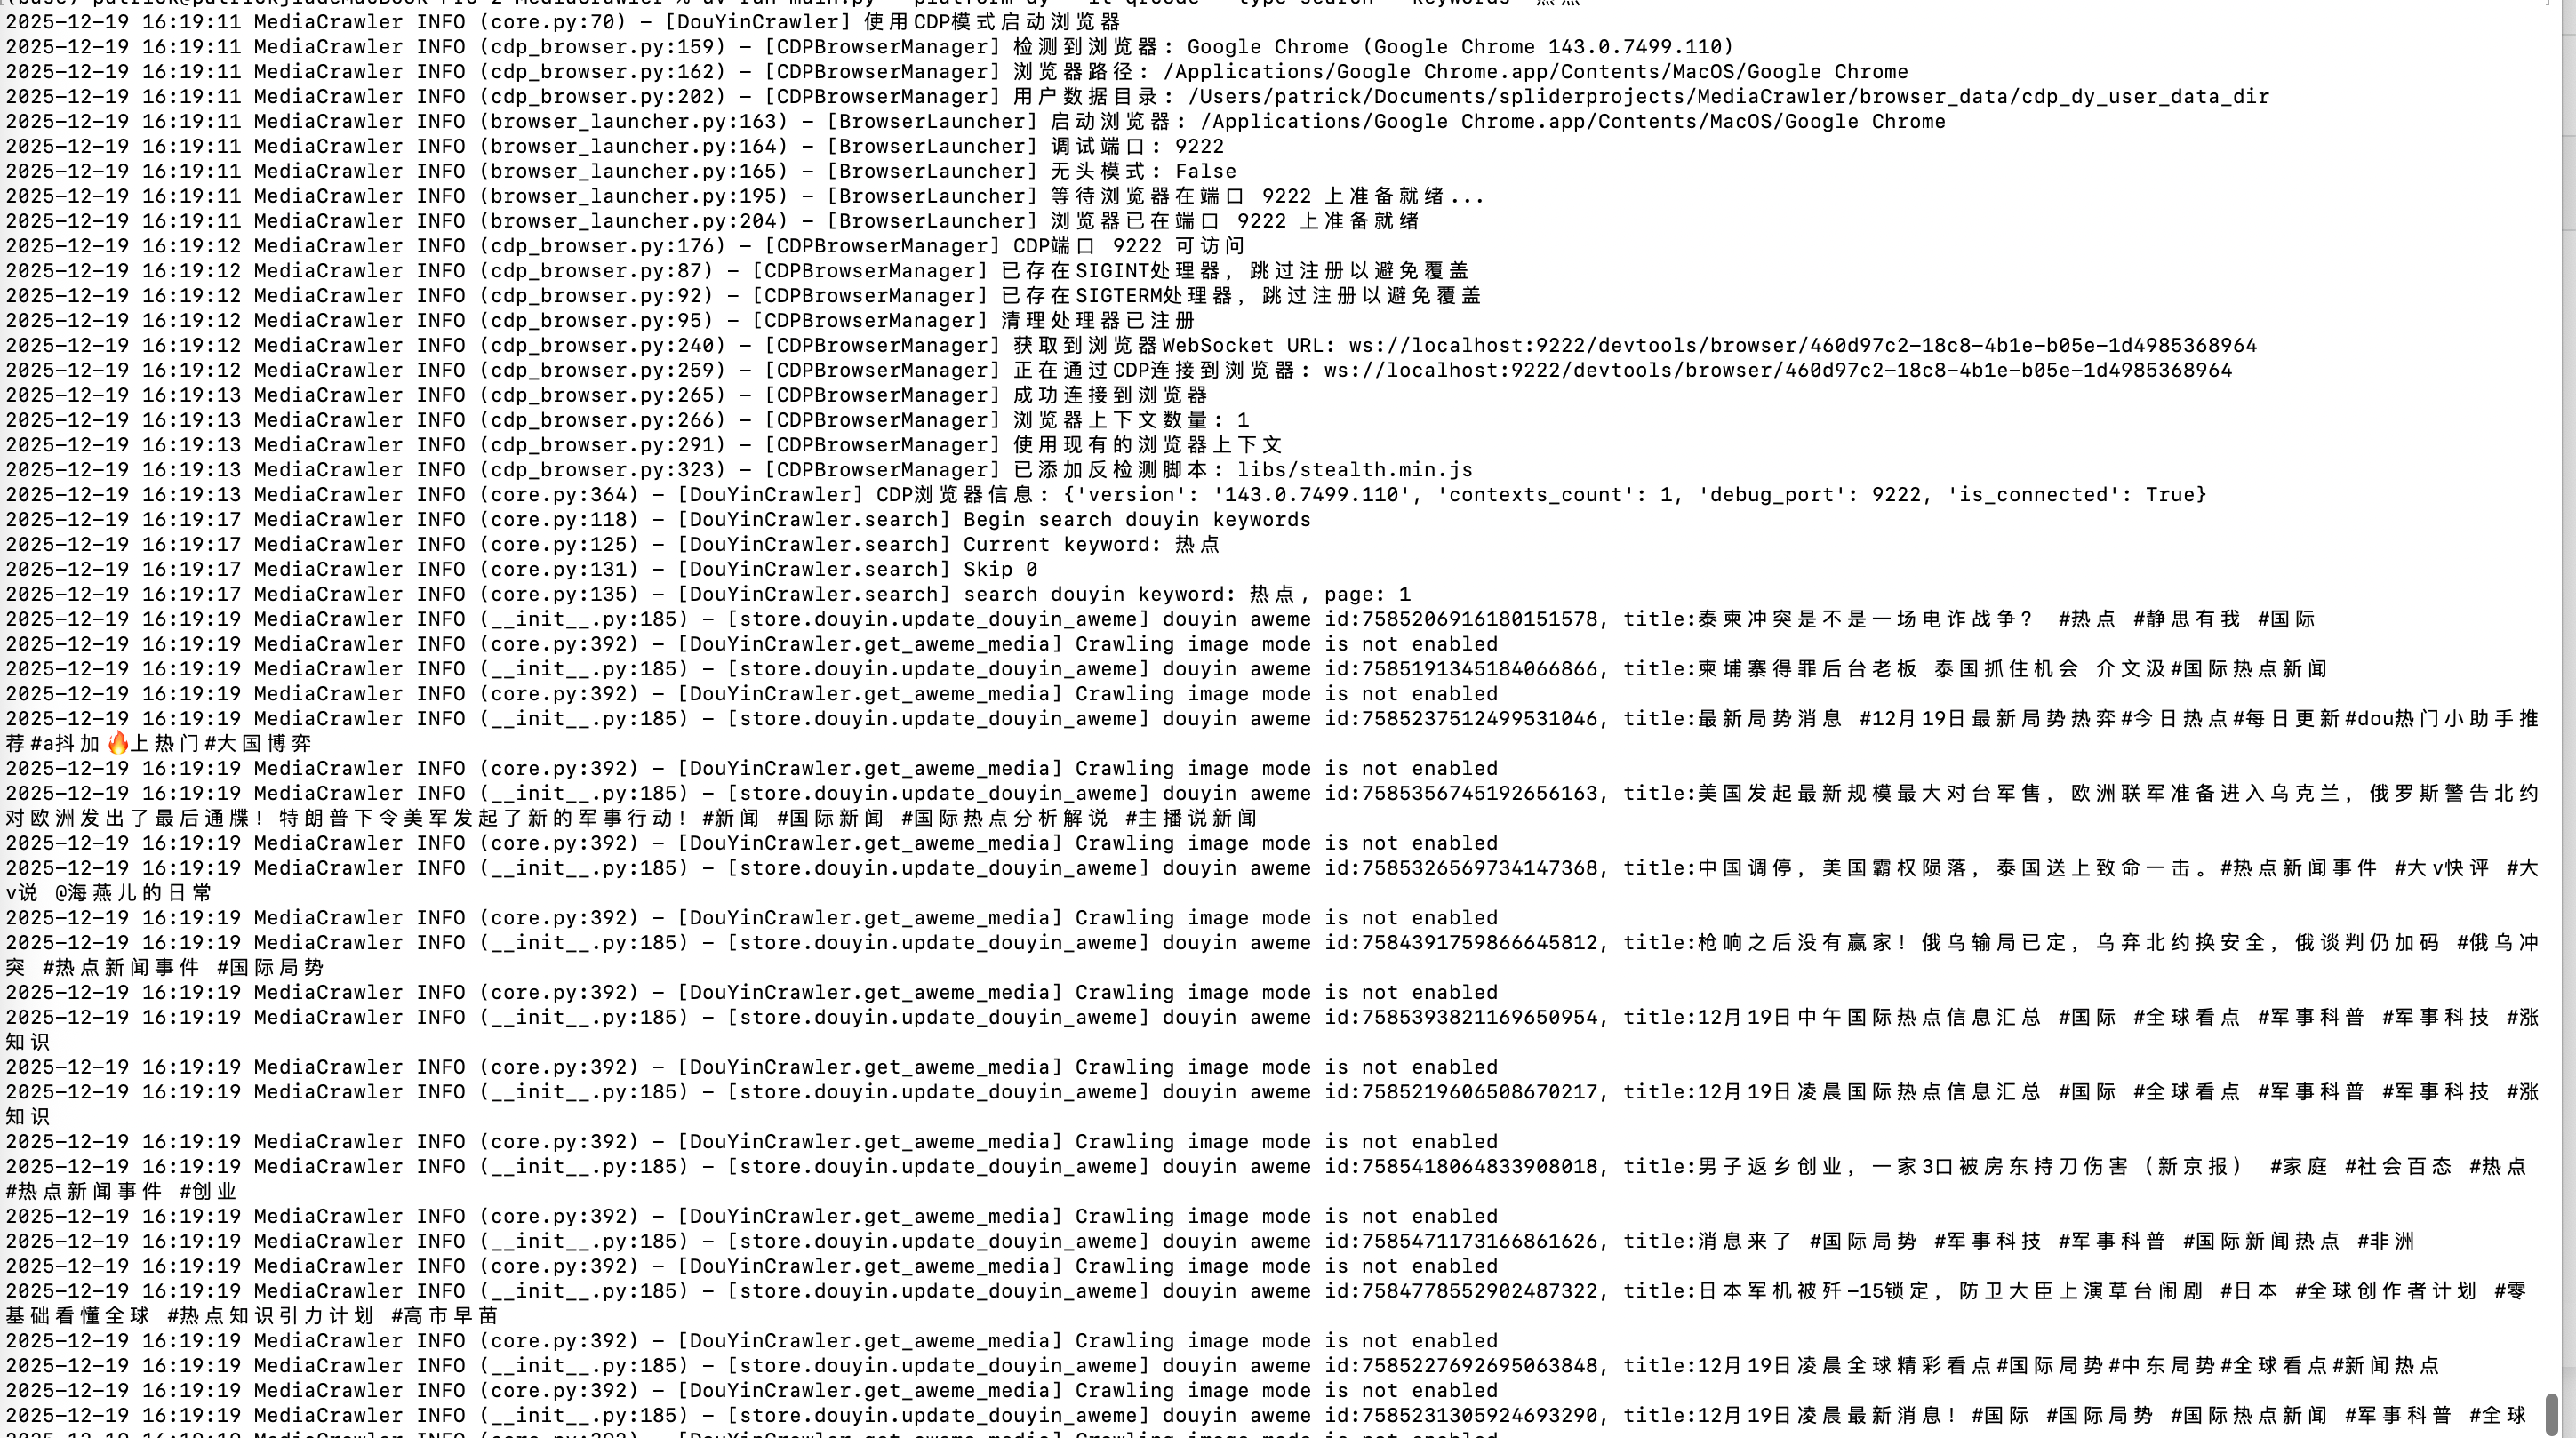
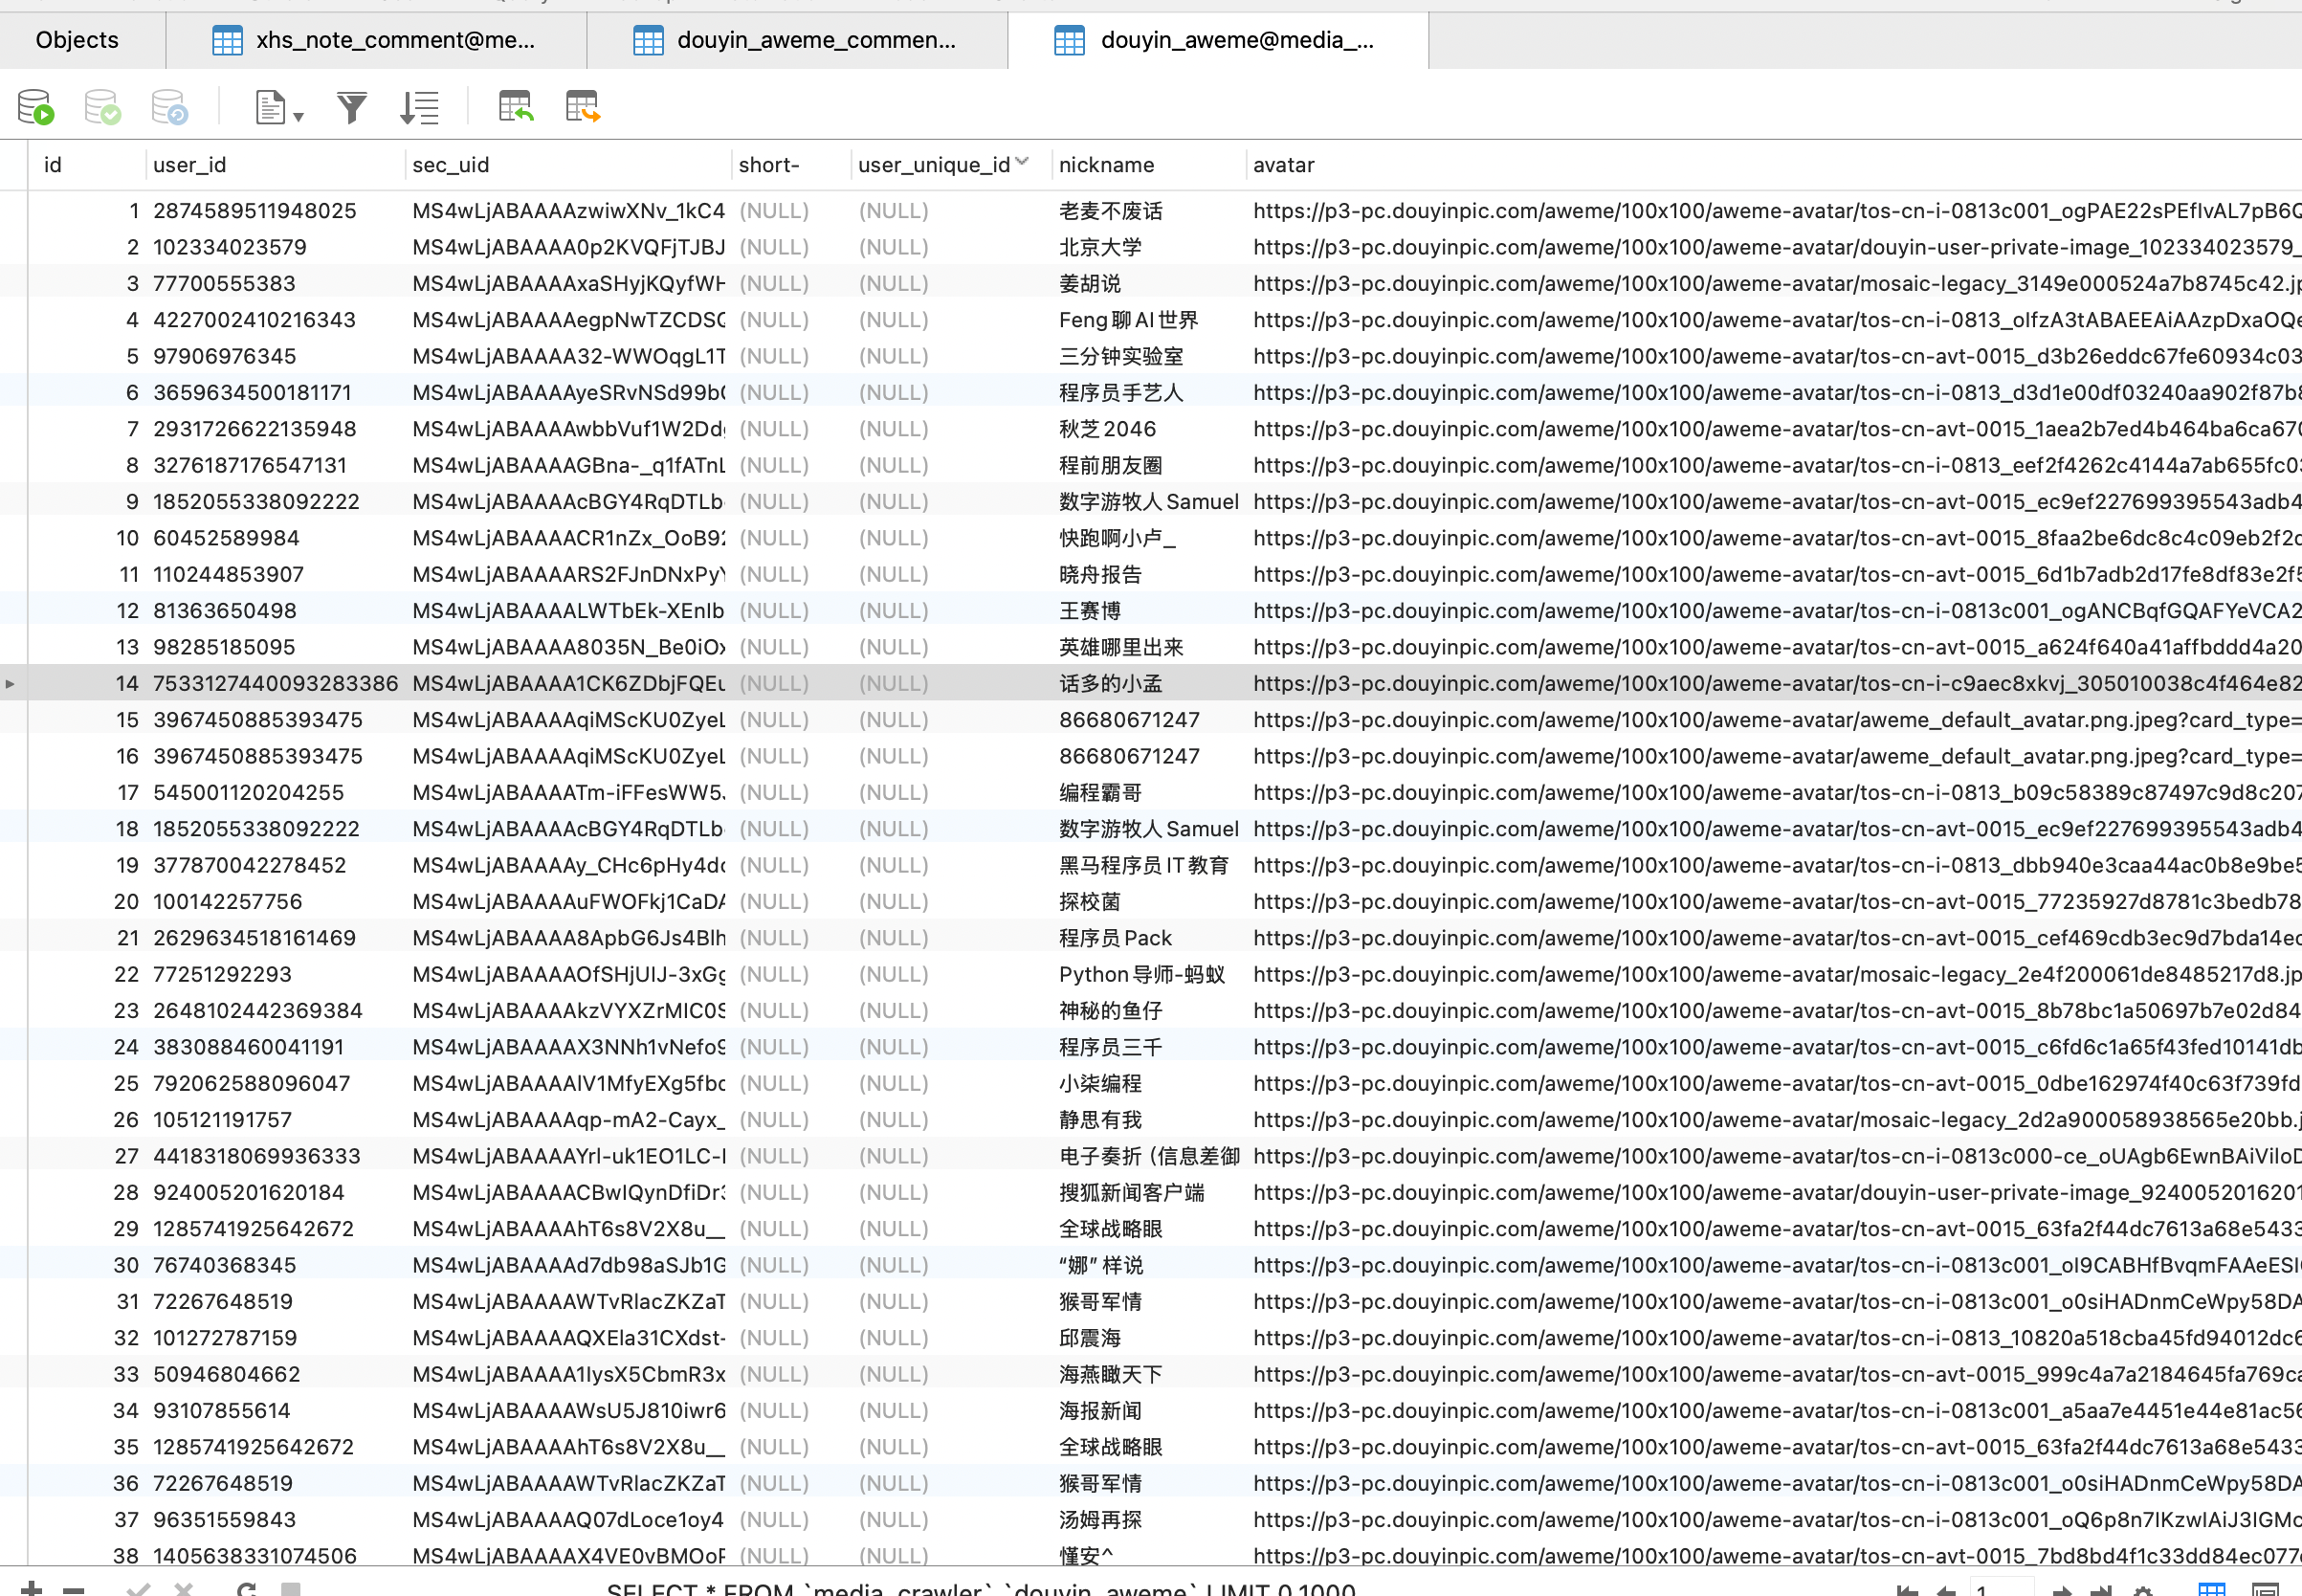
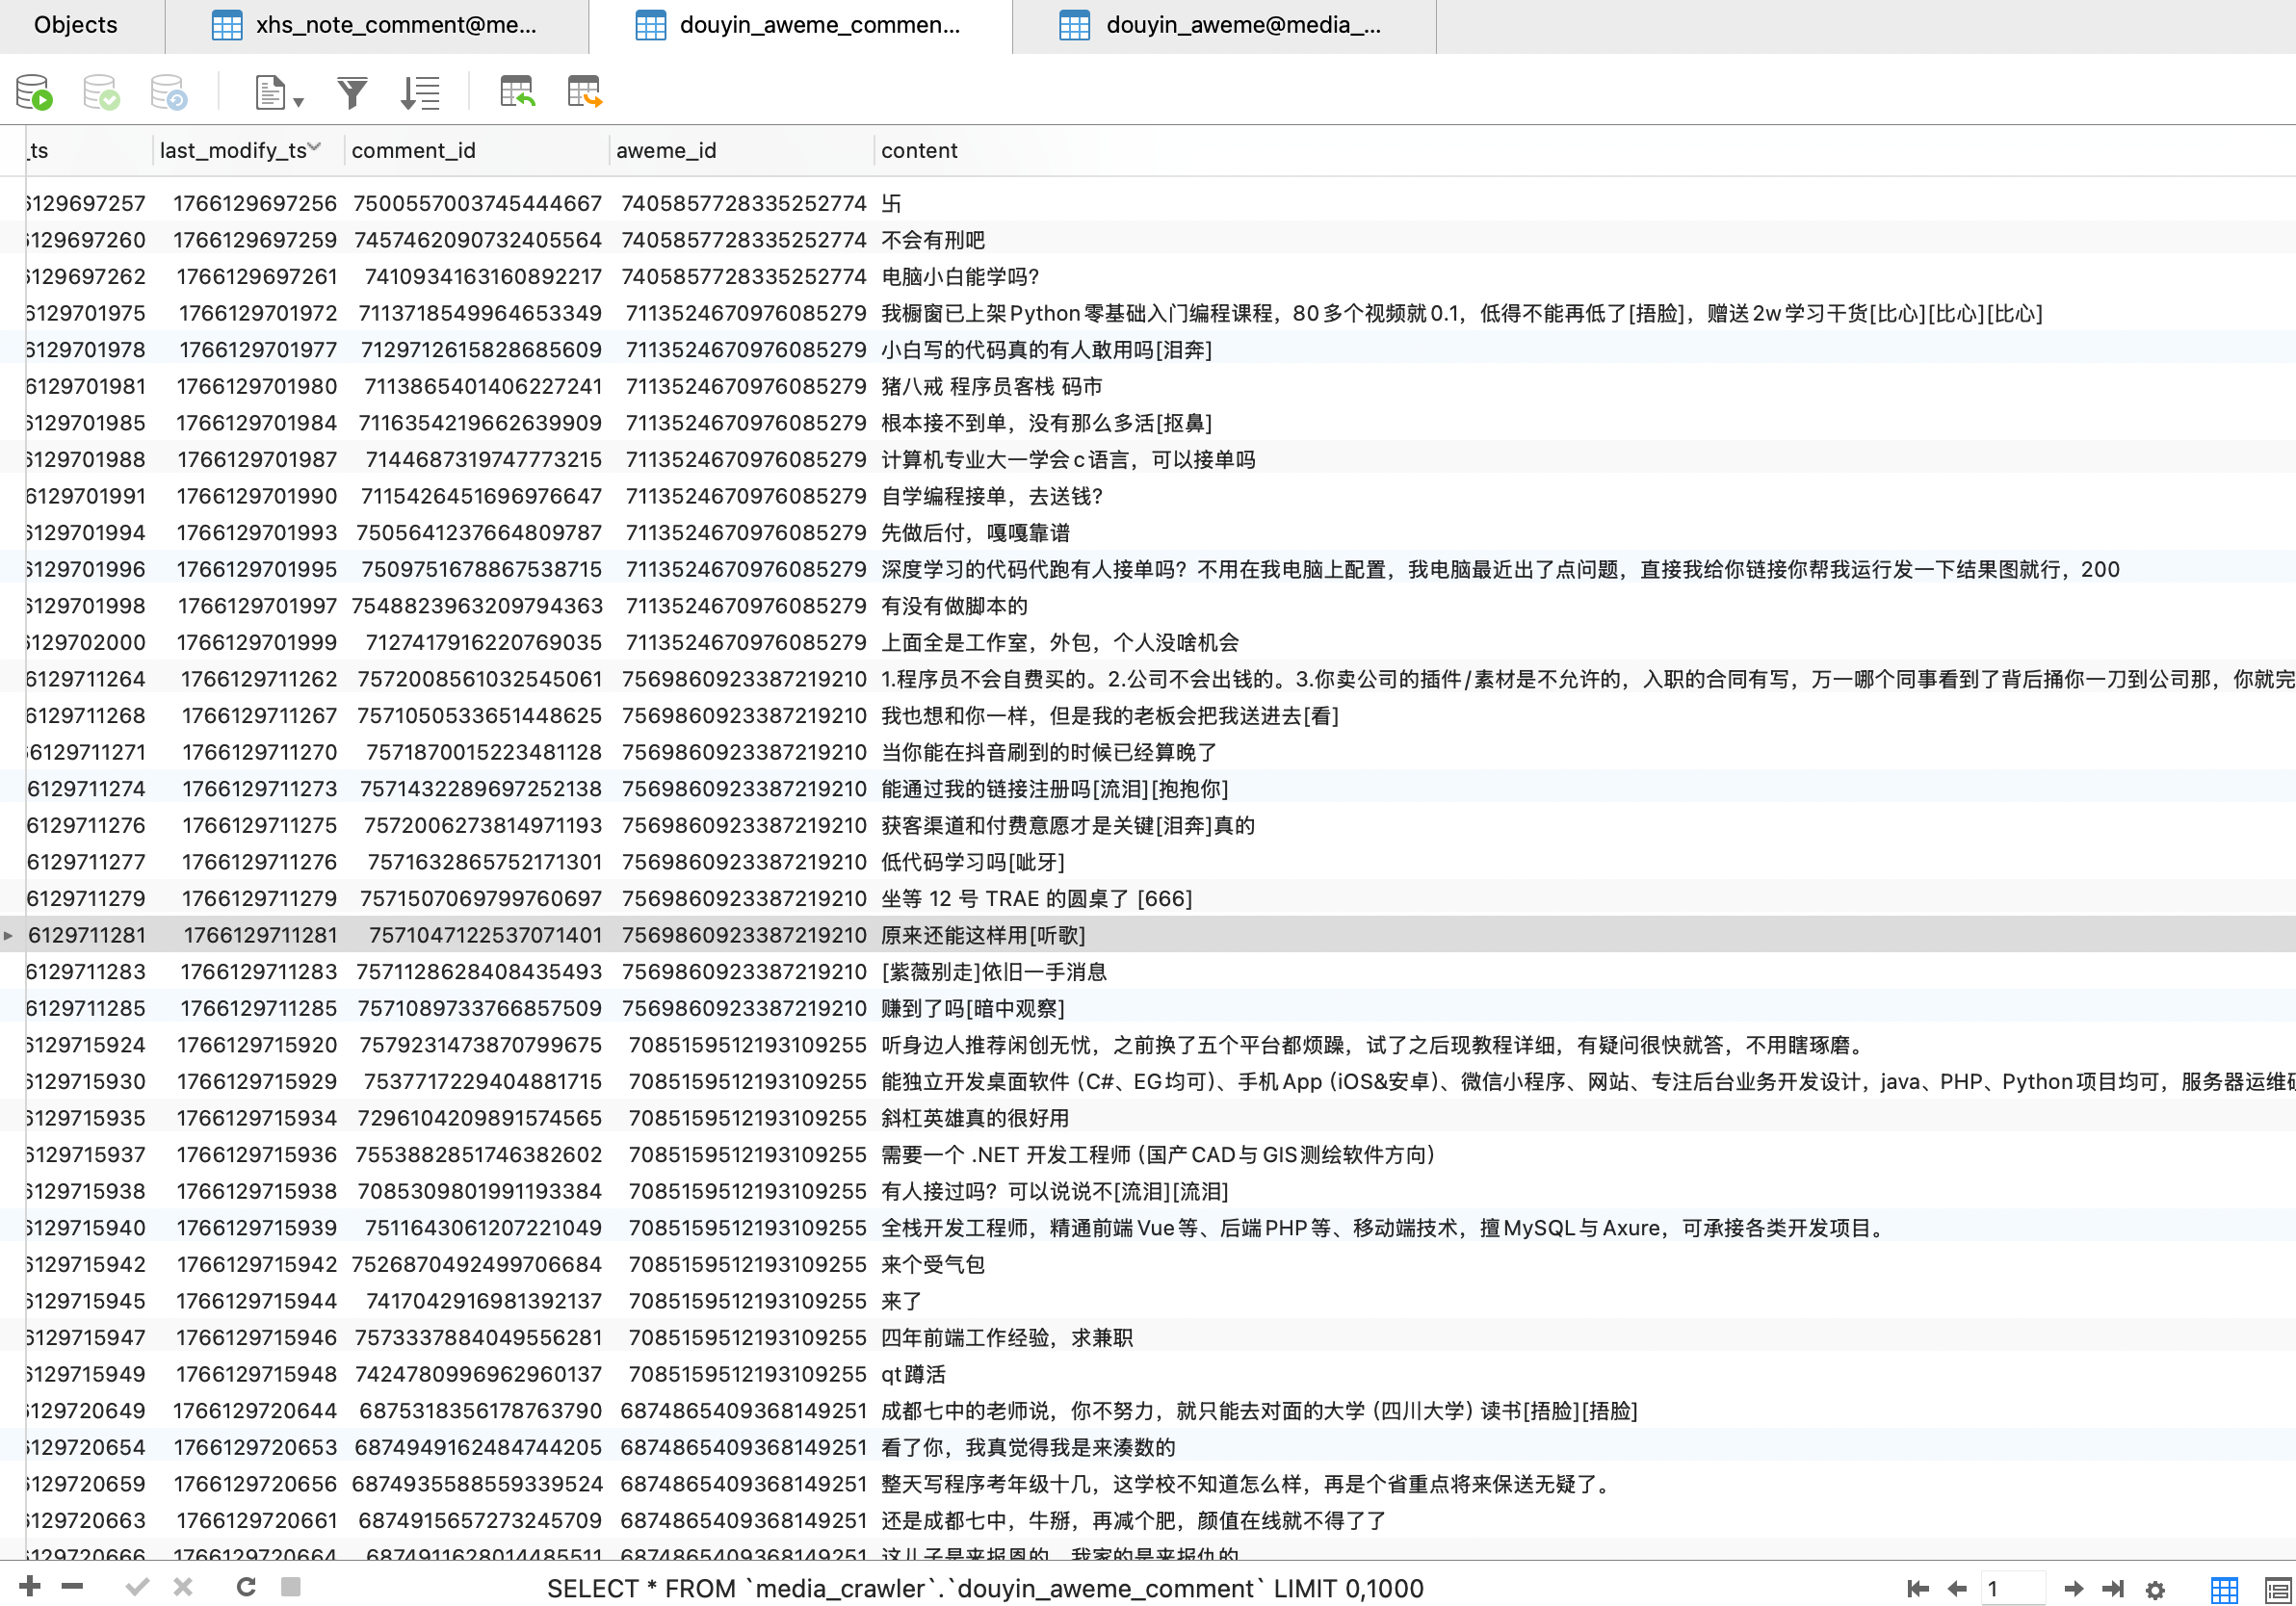
保存的数据在数据库中的表: