大家好,我是java1234_小锋老师,最近写了一套【NLP舆情分析】基于python微博舆情分析可视化系统(flask+pandas+echarts)视频教程,持续更新中,计划月底更新完,感谢支持。今天讲解数据持久化到Mysql
视频在线地址:
2026版【NLP舆情分析】基于python微博舆情分析可视化系统(flask+pandas+echarts+爬虫) 视频教程 (火爆连载更新中..)_哔哩哔哩_bilibili
课程简介:
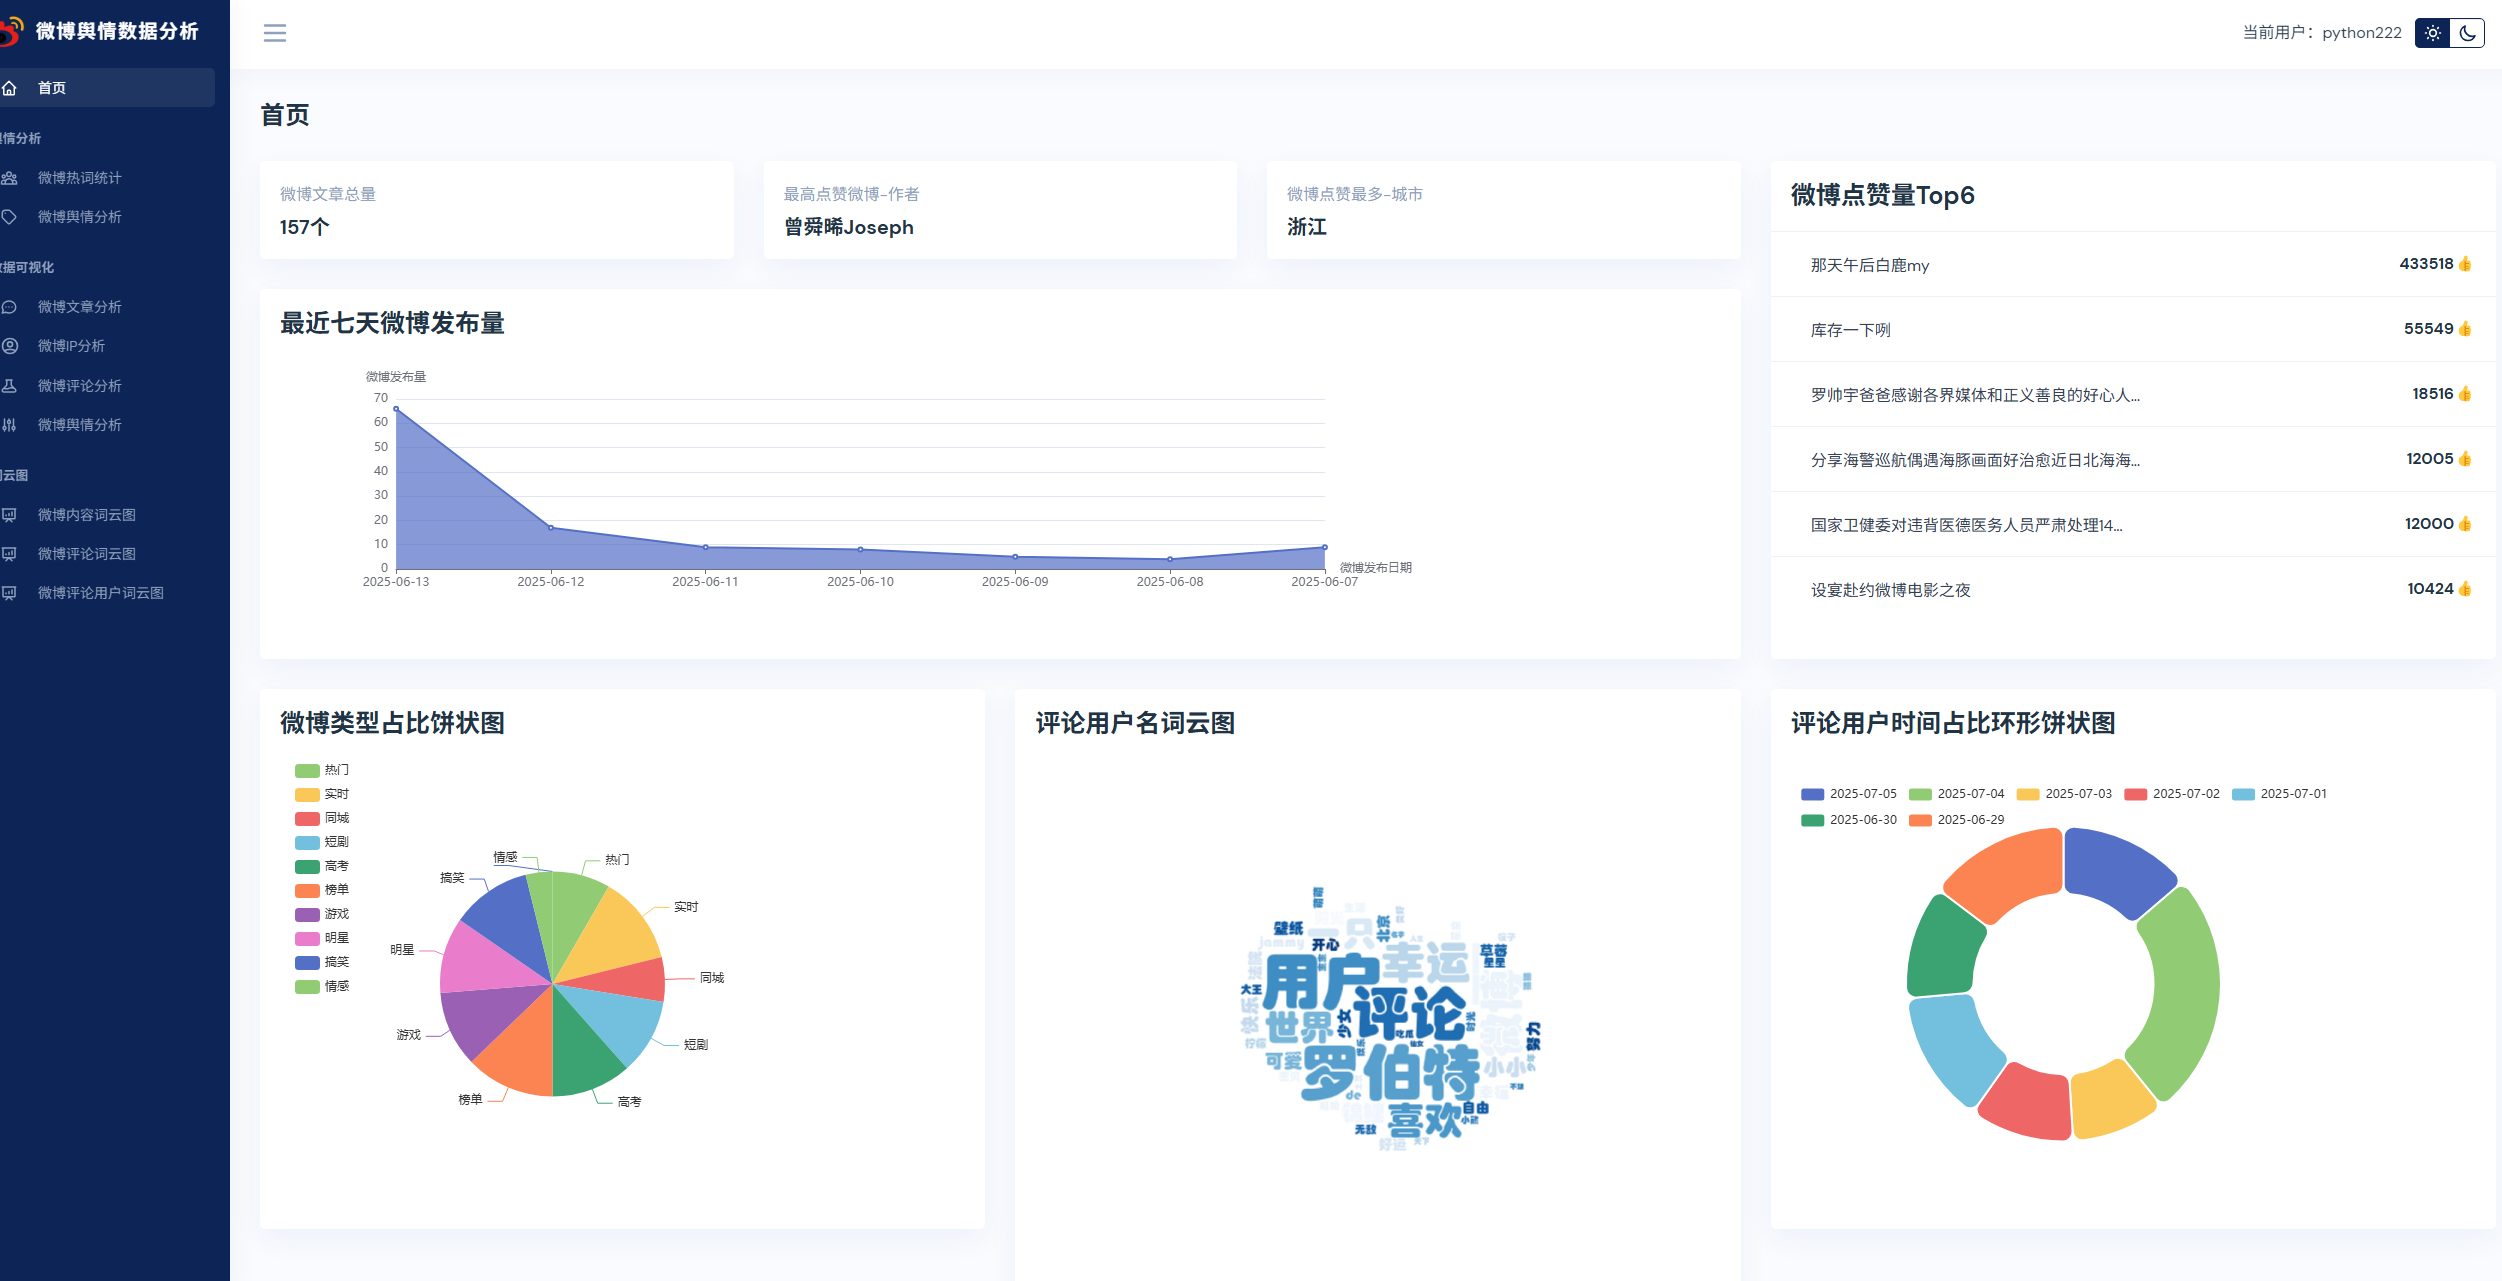
本课程采用主流的Python技术栈实现,Mysql8数据库,Flask后端,Pandas数据分析,前端可视化图表采用echarts,以及requests库,snowNLP进行情感分析,词频统计,包括大量的数据统计及分析技巧。
实现了,用户登录,注册,爬取微博帖子和评论信息,进行了热词统计以及舆情分析,以及基于echarts实现了数据可视化,包括微博文章分析,微博IP分析,微博评论分析,微博舆情分析。最后也基于wordcloud库实现了词云图,包括微博内容词云图,微博评论词云图,微博评论用户词云图等功能。
数据持久化到Mysql
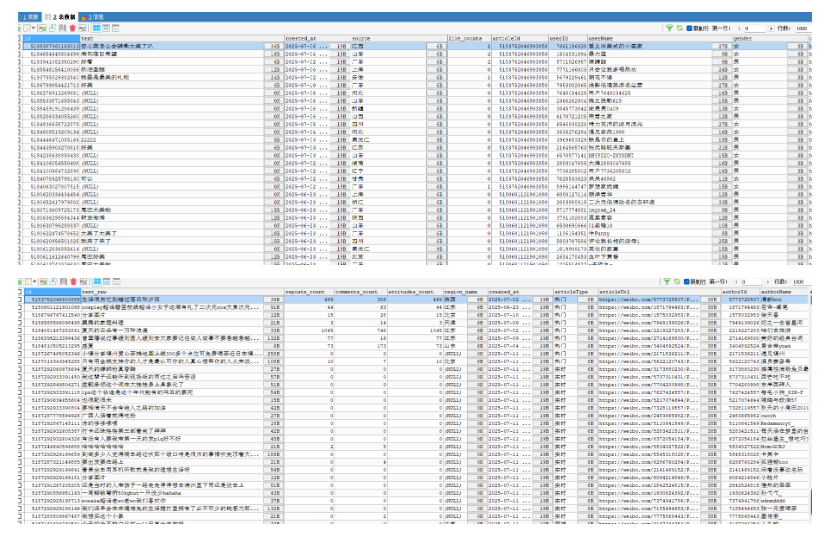
前面我们抓取了微博类别,微博以及微博评论信息,存到了csv文件,但是有个问题,csv文件可能丢失,以及数据库被覆盖等问题。所以还是得持久化到数据库。
一般处理流程有 1,爬数据 2,数据清洗 3,持久化到数据库
持久化到数据库的流程有细分下:先合并数据库和csv文件到数据库,再去重,然后存数据库,最后再把两个csv文件删除。
新建main.py,下面是实现代码:
python
"""
爬数据,持久化到数据库 主函数
"""
import os
import traceback
import pandas as pd
from sqlalchemy import create_engine
from article_spider import start as articleSpiderStart
from arcType_spider import start as arcTypeSpiderStart
engine = create_engine('mysql+pymysql://root:123456@localhost:3308/db_weibo2?charset=utf8mb4')
def dataClean():
"""
数据清洗 对csv文件数据处理 pandas库处理
:return:
"""
pass
def saveToDb():
"""
持久化到数据库,先合并数据库和csv数据库,再去重,最后存数据库
:return:
"""
try:
oldArticleDb = pd.read_sql('select * from t_article', engine)
newArticleCsv = pd.read_csv('article_data.csv')
concatArticlePd = pd.concat([newArticleCsv, oldArticleDb])
resultArticlePd = concatArticlePd.drop_duplicates(subset='id', keep='last')
resultArticlePd.to_sql('t_article', con=engine, if_exists='replace', index=False)
oldCommentDb = pd.read_sql('select * from t_comment', engine)
newCommentCsv = pd.read_csv('comment_data.csv')
concatCommentPd = pd.concat([newCommentCsv, oldCommentDb])
resultCommentPd = concatCommentPd.drop_duplicates(subset='id', keep='last')
resultCommentPd.to_sql('t_comment', con=engine, if_exists='replace', index=False)
except Exception as e:
print('异常:', e)
traceback.print_exc()
newArticleCsv = pd.read_csv('article_data.csv')
newCommentCsv = pd.read_csv('comment_data.csv')
newArticleCsv.to_sql('t_article', con=engine, if_exists='replace', index=False)
newCommentCsv.to_sql('t_comment', con=engine, if_exists='replace', index=False)
os.remove('article_data.csv')
os.remove('comment_data.csv')
if __name__ == '__main__':
print("微博内容爬取开始...")
articleSpiderStart()
print("微博内容爬取结束...")
print("微博评论爬取开始...")
arcTypeSpiderStart()
print("微博评论爬取结束...")
print("数据清洗开始...")
dataClean()
print("数据清洗结束...")
print("微博内容和评论信息持久化到数据库开始...")
saveToDb()
print("微博内容和评论信息持久化到数据库结束...")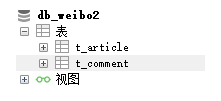
运行后,sqlalchemy自动创建两个表。