做量化,绕不开数据库。很多刚入门的朋友一上来就问我:花姐,数据库这么多,到底用哪个?要不要一上来就整一套像大机构那样的分布式数据库?
我先说结论:普通人做量化,数据库别贪大求全,先够用,后扩展。
一、你先想清楚,你的量化规模多大?
数据库不是摆设,它解决的核心问题就两个:
- 存得下
- 取得快
普通人量化,早期数据量很有限------A股全市场日线数据加上财报、公告,压缩后几十个G就够了。即便加上分钟级数据,硬盘也能装得下。所以不用一上来就考虑分布式,先用好本地或轻量级的方案。
二、三种主流选择
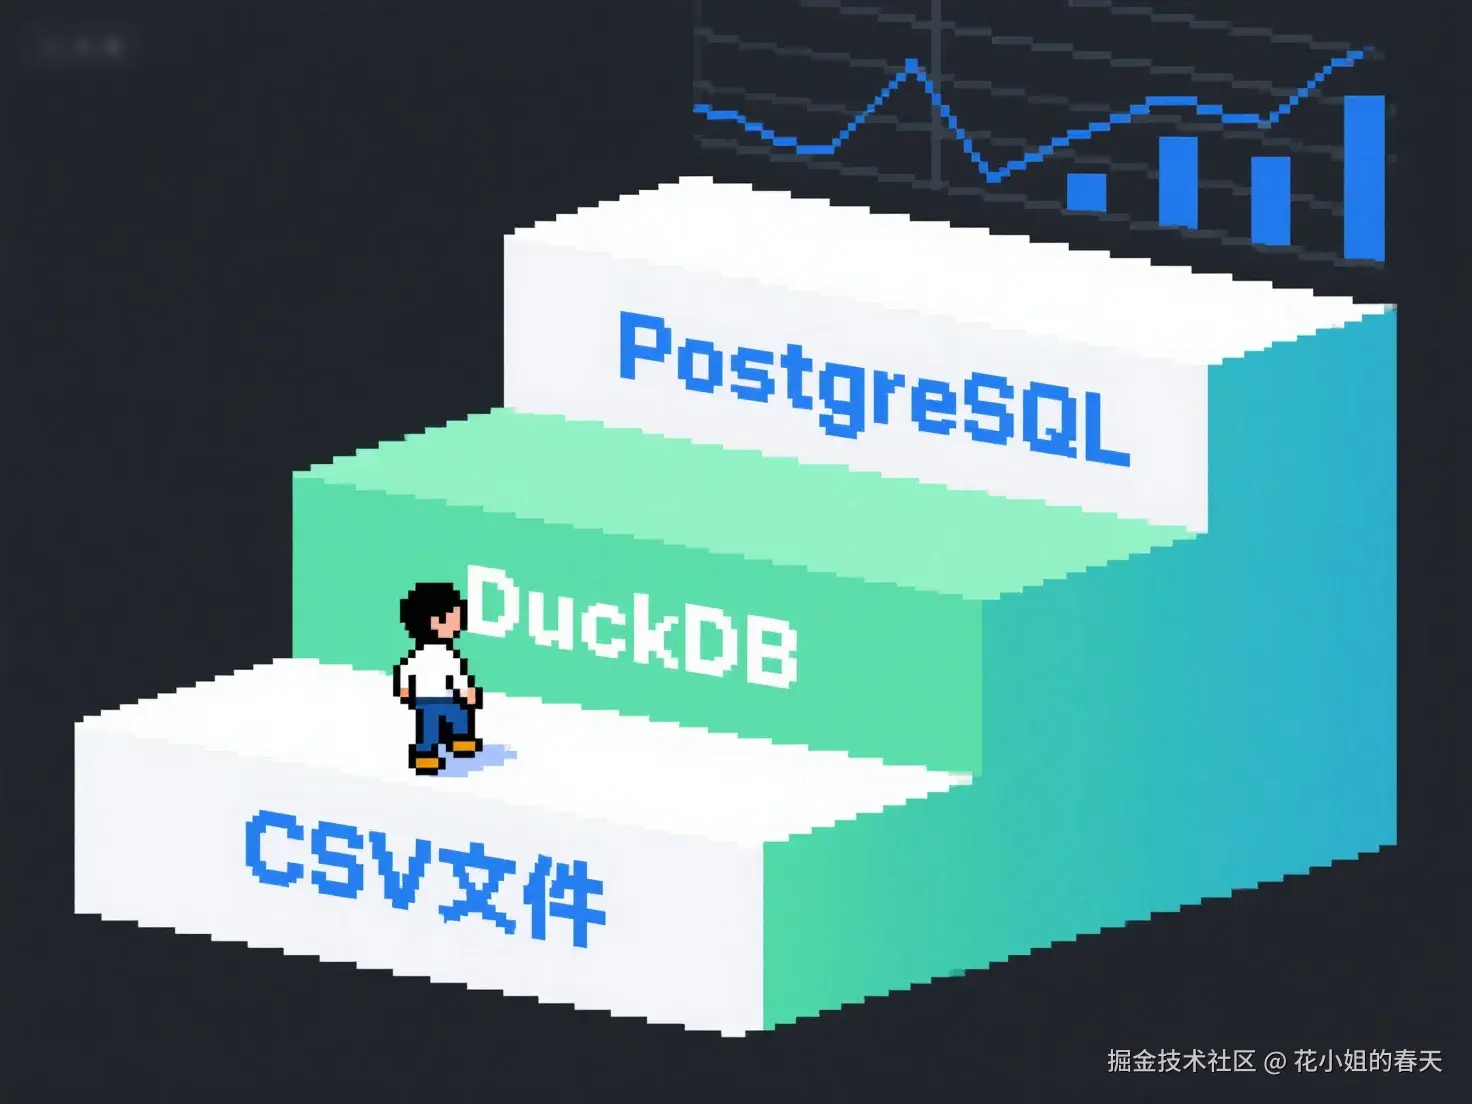
1. CSV/Parquet 文件 + Pandas
最简单粗暴,直接用文件存,Python随时读。
- 优点:零门槛,适合探索阶段,复制粘贴就能用
- 缺点:数据一多(比如上G),IO效率就会拖垮回测速度
如果你还在练手阶段,这种方案完全没问题,别嫌土。
2. SQLite / DuckDB
本地单文件数据库,轻量级神器。
- SQLite:稳定、简单,很多小型量化项目够用
- DuckDB:近两年特别火,特别擅长分析型查询(批量聚合、回测)
- 适用场景:单机、数据量在几十G以内,想要 SQL 查询的便利性
我个人非常推荐 DuckDB,速度和易用性都比 SQLite 爽。
3. PostgreSQL / MySQL
如果你数据逐渐多起来,或者想和 Web 服务对接,这两位才是大杀器。
- PostgreSQL:功能强大,适合结构化和半结构化数据
- MySQL:社区成熟,资料多
- 适用场景:多人协作、数据多源整合、要做策略在线部署
但注意,自己搭这些数据库,有学习成本,别因为折腾环境耽误了研究策略。
三、别急着上云或分布式
很多朋友一开始就盯着云数据库、大数据方案(像 ClickHouse、Spark 之类的),这些确实牛,但没必要早期就搞。 你个人电脑都没跑满,何必折腾上云,花钱还麻烦?等你做到资金量大、策略复杂,瓶颈真来了,再考虑升级。
四、实用建议
- 量化新手:DuckDB + 本地文件,性价比最高
- 数据量上百 G,再升级 PostgreSQL 或 ClickHouse
- 文件结构要规划好,别乱堆,后期查找很痛苦
记住,数据库只是工具,策略才是核心。别本末倒置。