01. 摘要缓冲混合记忆
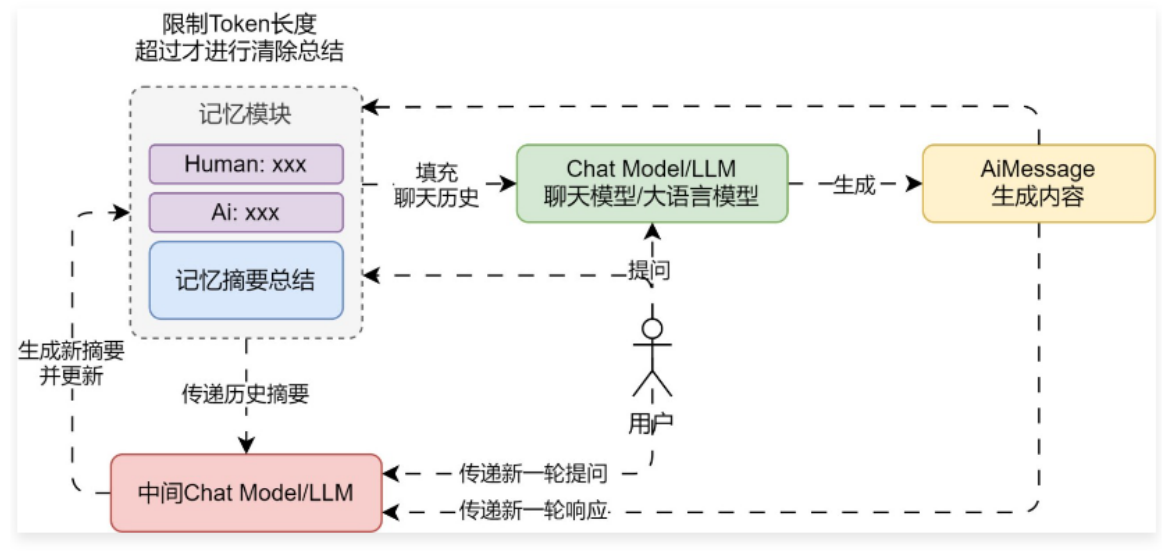
摘要缓冲混合记忆中,所需的模块有:
- chat_message_history:存储历史消息列表。
- moving_summary_buffer:移除消息的汇总字符串。
- summary_llm:生成摘要的 LLM,接收 summary(当前摘要)、query(人类提问)、content(AI生成)。
- max_tokens:限制记忆模块存储消息的最大 token 数。
- get_num_tokens:用于统计传入的文本的 token 数
02. ChatGPT/Playground 模拟
将记忆的 max_tokens 长度设置为 300,模拟所需物料:
- ChatGPT 官网:https://chatgpt.com/(无痕模式)
- OpenAI Tokenizer:https://platform.openai.com/tokenizer
人类提问
你是由OpenAI开发的聊天机器人,请帮助用户回答问题。
摘要: -
消息列表: -
用户的提问是: 你好,我是好好,喜欢唱跳rap打篮球,你是谁?你喜欢什么呢?
AI 回复内容:
你好,好好!我是ChatGPT,一个由OpenAI训练的大型语言模型。很高兴认识你!我没有像人类一样的个人喜好,但我喜欢帮助人们解决问题、回答问题和分享知识。你提到喜欢唱跳rap和打篮球,感觉你生活非常丰富多彩!你有特别喜欢的歌手或者篮球队吗?
聊天消息列表:
Human: 你好,我是好好,喜欢唱跳rap打篮球,你是谁?你喜欢什么呢?
AI: 你好,好好!我是ChatGPT,一个由OpenAI训练的大型语言模型。很高兴认识你!我没有像人类一样的个人喜好,但我喜欢帮助人们解决问题、回答问题和分享知识。你提到喜欢唱跳rap和打篮球,感觉你生活非常丰富多彩!你有特别喜欢的歌手或者篮球队吗?
人类提问:
你是由OpenAI开发的聊天机器人,请帮助用户回答问题。
摘要: -
消息列表:
Human: 你好,我是好好,喜欢唱跳rap打篮球,你是谁?你喜欢什么呢?
AI: 你好,好好!我是ChatGPT,一个由OpenAI训练的大型语言模型。很高兴认识你!我没有像人类一样的个人喜好,但我喜欢帮助人们解决问题、回答问题和分享知识。你提到喜欢唱跳rap和打篮球,感觉你生活非常丰富多彩!你有特别喜欢的歌手或者篮球队吗?
用户的提问是: 你能用一段话快速解释下LLM是什么吗?
AI 回复内容:
大型语言模型(LLM)是一种通过大量文本数据训练的人工智能模型,能够理解和生成自然语言文本。它应用于写作辅助、语言翻译、对话系统和问答系统等自然语言处理任务,表现出高水平的语言理解和生成能力。
聊天消息列表:
Human: 你好,我是好好,喜欢唱跳rap打篮球,你是谁?你喜欢什么呢?
AI: 你好,好好!我是ChatGPT,一个由OpenAI训练的大型语言模型。很高兴认识你!我没有像人类一样的个人喜好,但我喜欢帮助人们解决问题、回答问题和分享知识。你提到喜欢唱跳rap和打篮球,感觉你生活非常丰富多彩!你有特别喜欢的歌手或者篮球队吗?
Human: 你能用一段话快速解释下LLM是什么吗?
AI: 大型语言模型(LLM)是一种通过大量文本数据训练的人工智能模型,能够理解和生成自然语言文本。它应用于写作辅助、语言翻译、对话系统和问答系统等自然语言处理任务,表现出高水平的语言理解和生成能力。
max_tokens 长度超过 300,触发总结,并删除超过长度的消息组(AI和Human)。
总结 Prompt
你是一个强大的聊天机器人,请根据用户提供的谈话内容,总结内容,并将其添加到先前提供的摘要中,返回一个新的摘要。
<example>
当前摘要: 人类会问人工智能对人工智能的看法。人工智能认为人工智能是一股向善的力量。
新的谈话内容:
Human: 为什么你认为人工智能是一股向善的力量?
AI: 因为人工智能将帮助人类充分发挥潜力。
新摘要: 人类会问人工智能对人工智能的看法。人工智能认为人工智能是一股向善的力量,因为它将帮助人类充分发挥潜力。
</example>
当前摘要: -
新的对话内容:
Human: 你好,我是好好,喜欢唱跳rap打篮球,你是谁?你喜欢什么呢?
AI: 你好,好好!我是ChatGPT,一个由OpenAI训练的大型语言模型。很高兴认识你!我没有像人类一样的个人喜好,但我喜欢帮助人们解决问题、回答问题和分享知识。你提到喜欢唱跳rap和打篮球,感觉你生活非常丰富多彩!你有特别喜欢的歌手或者篮球队吗?
摘要总结内容
好好介绍自己喜欢唱跳rap和打篮球,并问AI的喜好。AI自我介绍为ChatGPT,一个由OpenAI训练的大型语言模型,喜欢帮助人们解决问题、回答问题和分享知识。AI还问好好是否有特别喜欢的歌手或篮球队。
记忆:
摘要: 好好介绍自己喜欢唱跳rap和打篮球,并问AI的喜好。AI自我介绍为ChatGPT,一个由OpenAI训练的大型语言模型,喜欢帮助人们解决问题、回答问题和分享知识。AI还问好好是否有特别喜欢的歌手或篮球队。
消息列表:
Human: 你能用一段话快速解释下LLM是什么吗?
AI: 大型语言模型(LLM)是一种通过大量文本数据训练的人工智能模型,能够理解和生成自然语言文本。它应用于写作辅助、语言翻译、对话系统和问答系统等自然语言处理任务,表现出高水平的语言理解和生成能力。
再次提问:
你是由OpenAI开发的聊天机器人,请帮助用户回答问题。
摘要: 好好介绍自己喜欢唱跳rap和打篮球,并问AI的喜好。AI自我介绍为ChatGPT,一个由OpenAI训练的大型语言模型,喜欢帮助人们解决问题、回答问题和分享知识。AI还问好好是否有特别喜欢的歌手或篮球队。
消息列表:
Human: 你能用一段话快速解释下LLM是什么吗?
AI: 大型语言模型(LLM)是一种通过大量文本数据训练的人工智能模型,能够理解和生成自然语言文本。它应用于写作辅助、语言翻译、对话系统和问答系统等自然语言处理任务,表现出高水平的语言理解和生成能力。
用户的提问是: 我叫什么名字?
AI 回复
根据消息列表中的内容,你的名字是好好。