1.beatuifulSoup 基本用法
beautifulSoup(简称bs4)是python的一个第三方库,用于解析html和xml文档中提取数据的python库。它能够将复杂的文档转化为树形结构,方便快速定位和提取所需数据以及查找和修改,常常与爬虫框架如requests结合使用:
一下是bs4的核心功能的介绍:
- 四大对象类型
tag:html、xml中的标签,如div和a标签
NavigableString:标签内的文本内容
BeautifulSoup:表示整个文档树
Comment:Html中的注释部分 - 解析器对比
| 解析器 | 优势 | 劣势 |
|---|---|---|
| html | 内置无需安装 | 速度比较慢,容错性一般 |
| lxml | 速度快容错性强 | 需要额外安装依赖 |
| html5lib | 遵循html5标准容错性最强 | 速度最慢,需要额外安装 |
- 安装与导入
命令:
python
pip install beautifulsoup4执行结果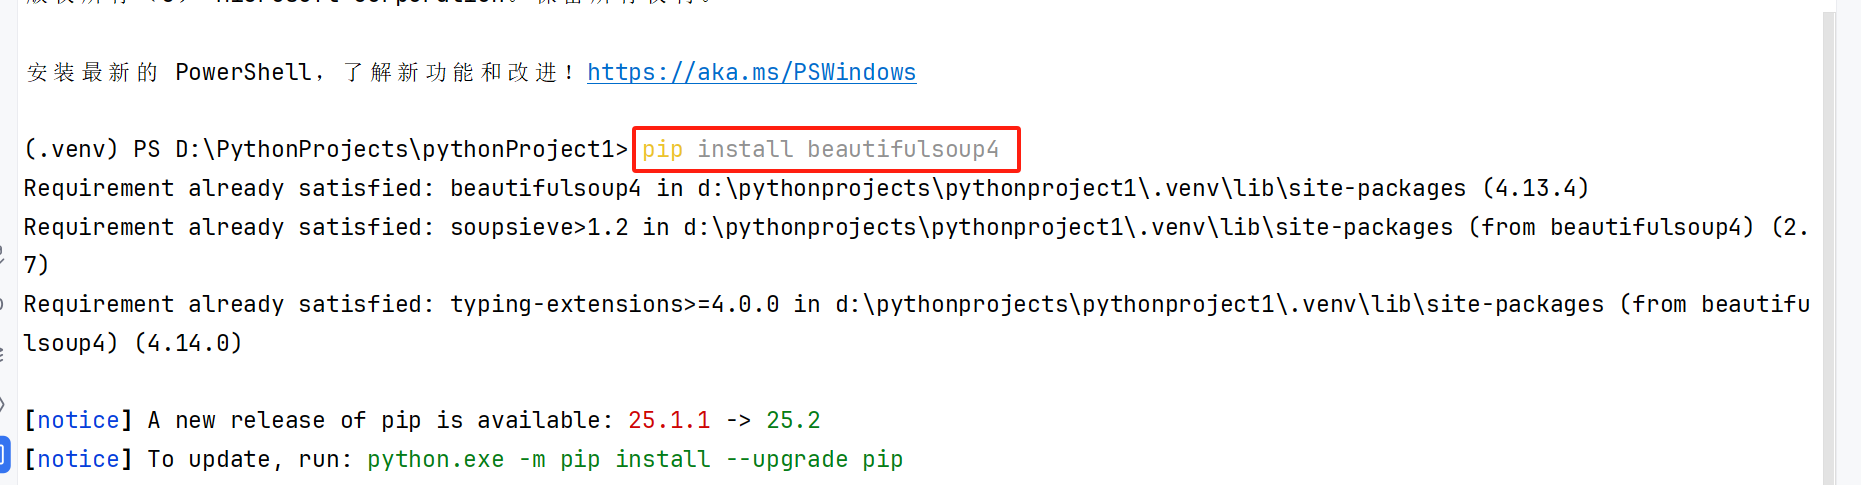还需要安装解析器(如lxml或者html.parse)
命令:
python
pip install lxml导包使用
- 使用BeautifulSoup流程
①导入BeautifulSoup模块
②创建BeautifulSoup对象
③使用标签名称查找元素
④使用css选择器查找元素
⑤获取元素的文本内容 - BeautifulSoup基本用法
①初始化与解析
a. 字符串解析
python
from bs4 import BeautifulSoup

# 字符串解析,相当于把需要解析的内容,不需要放到html中,直接放在str中
html_doc = '''
<!DOCTYPE html>
<html lang="en">
    <head>
        <meta charset="UTF-8">
        <title>python</title>
    </head>
    <body>
            <div class="name" id="title">
                <h1> python 学习</h1>
                <p> 爬虫 </p>
                <a href="https://www.python.org/"></a>
            </div>
    </body>
</html>
'''
# 设置解析器进行解析
soup = BeautifulSoup(html_doc, 'html.parser')
print(soup) b. 文件解析(从html文件中进行解析)
python
from bs4 import BeautifulSoup

# 文件解析
with open('bs.html', 'r', encoding='utf8') as f:
    soup = BeautifulSoup(f, 'html.parser')
print(soup) c. URL获取HTML并解析(使用爬虫脚本发送请求的时候就已经可以进行解析了)
python
from bs4 import BeautifulSoup
import requests

# url获取html并解析
url = 'http://www.baidu.com'

headers = {
    'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 '
                  'Safari/537.39996'
}
response = requests.get(url= url, headers=headers)
soup = BeautifulSoup(response.text, 'lxml')
print(soup)
②访问元素
例如:获取字符串中的某个标签,通过标签名来进行访问
python
from bs4 import BeautifulSoup

# 字符串解析,相当于把需要解析的内容,不需要放到html中,直接放在str中
html_doc = '''
<!DOCTYPE html>
<html lang="en">
    <head>
        <meta charset="UTF-8">
        <title>python</title>
    </head>
    <body>
            <div class="name" id="title">
                <h1> python 学习</h1>
                <p> 爬虫 </p>
                <a href="https://www.python.org/">路径</a>
            </div>
    </body>
</html>
'''
# 设置解析器进行解析
soup = BeautifulSoup(html_doc, 'html.parser')
# 1.直接访问子标签
h1_data = soup.h1
p_data = soup.p
div_data = soup.div
print(soup)
print(h1_data)
print(p_data)
print(div_data)
# 2.访问标签的标签名、标签值
# (先获取h1标签)
title = soup.h1
# 获取标签名
name= title.name
print(name)
# 获取标签值
str = title.string
print(str)
# 获取某个父标签下的某个子标签下的内容(嵌套访问:父亲找儿子的某个内容)
print(soup.body.div.a.string)