上个月对简单的天气 MCP 的测试后发现,在开源大模型领域,至少需要14B(140亿)参数规模的大型语言模型才能勉强胜任基础任务。
| 大模型 | 参数 | 发送城市数据 | 接收天气数据 |
|---|---|---|---|
| llama3.1 | 7B | 成功 | 失败 |
| deepseek-r1 | 8B | 失败 | / |
| qwen2.5 | 7B | 失败 | / |
| qwen3 | 8B | 失败 | / |
| deepseek-r1 | 14B | 失败 | / |
| qwen2.5 | 14B | 失败 | / |
| qwen3 | 14B | 成功 | 成功 |
| deepseek-r1 | 32B | 成功 | 成功 |
| qwen2.5 | 32B | 成功 | 成功 |
| qwen3 | 32B | 成功 | 成功 |
而各大科技媒体预测苹果端侧模型仅需2-3B参数,对比实测需求远超预期。
小参数模型困局
无论苹果采用 MCP 方案,还是其他技术路径,必然涉及多层嵌套的 JSON/Protobuf 数据结构,对模型语义理解和结构化处理能力的要求都是一样的。即使如苹果发布会提及,将复杂计算置于云端再端侧读取的策略,同样要求手机模型具备上述能力。
那按当前技术发展仍需 1-2 代产品周期才可达实用水平。
以阿里云 Qwen 系列为例:Qwen2.5 需 32B 参数才能可靠完成 MCP 任务,而 Qwen3 的 14B 模型已达相近效果------这印证了模型架构迭代能显著提升参数效率。
但 7B 参数会不会是关键临界点?现在的大模型低于此规模连基础 JSON 序列化/反序列化都难以保证。所以,是否单靠参数压缩,就能实现"小模型完成复杂任务"的目标,目前还是未知数。
MOE 模型是否有可能突破?
在这种背景下,混合专家模型(MoE)可能是最有希望的解决方案。
然而,以Qwen3的30B-A3B模型为例,虽然激活参数仅3B,但其资源需求并未同比降低。
3B 的大模型体积为2-3G,所以理论 4GB 内存能跑,8G 内存能流畅运行。但 B 站 up 主实测,在 Windows 平台仍需 16GB+ 内存/显存。
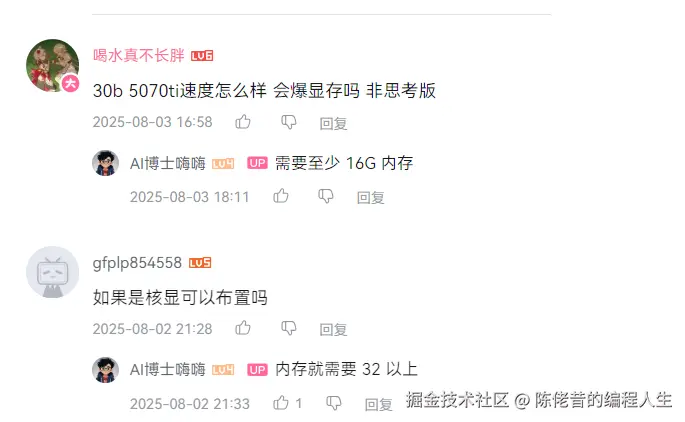
也许果粉会认为, Mac 平台可以凭借统一内存架构的优势降至8GB。但本人实测结果,在配备 16GB 内存的 M1 Mac Mini 上,闲置内存为 8G+ 的情况下,推理速度仅 2-3 tokens/秒------这个性能勉强达到"能跑"的标准,距离流畅用户体验(至少20 tokens/秒)相差甚远。
有开发者成功在 24GB 内存的安卓旗舰机上运行该模型,详见:【全网首测,手机跑通Qwen3-30B-A3B,写24年高考作文!】 。
但评论区复现的人都是大内存的手机。更严重的是,持续推理会导致手机电量骤降,这种能耗表现也是苹果需要解决的问题。
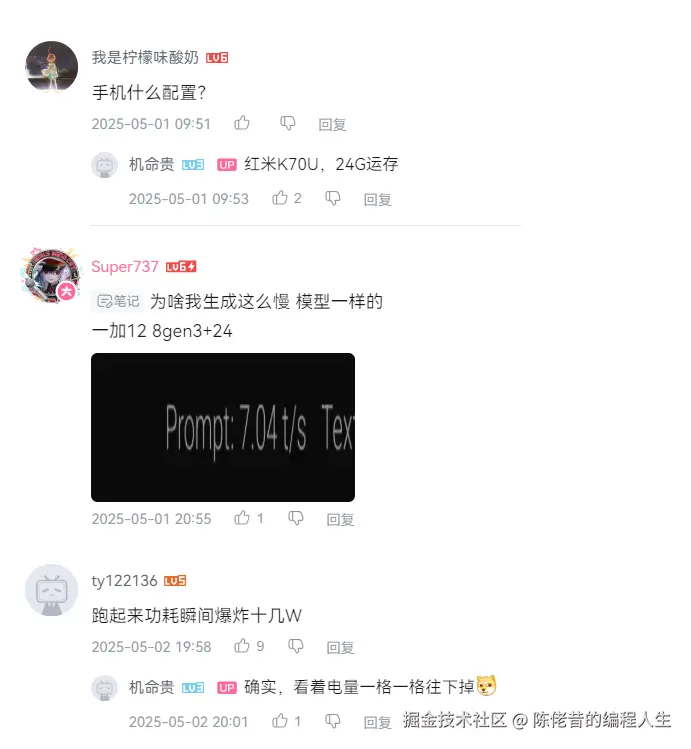
这些实证数据清晰地表明:以现有技术条件,无论是模型规模、推理速度还是能效表现,都远未达到苹果产品线要求的标准。
苹果该如何选择?
摆在苹果面前的是两条路:要么转向堆砌硬件参数,要么继续软件技术创新。
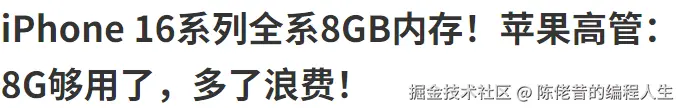
如果走硬件升级路线,则与苹果的产品理念(比金子贵的内存)存在根本性冲突。以 iPhone 16 Pro 系列为例,其最高配置仅提供8GB内存,若要在iPhone 17上突然跃升至16GB,不仅会啪啪打脸苹果高管, 而且这种硬件跃进激增的成本,最终都会转嫁给消费者。
而从软件优化的角度来看,苹果若能突破性地研发出类似精简版的 Qwen,如 14b-a1b 规模的轻量级模型,理论上 16GB 内存的设备就能流畅运行。但要在 iPhone 16 的 8GB 内存上能跑,只能追求更激进的 7b-a0.5b 这样的超精简版本,这需要攻克技术难关肯定更多,实现这一突破至少还需要1-2年的技术积累。
另外,苹果还可以做内存差异化策略,可以尝试在不同内存版本的手机上部署不同规模的模型。
虽然技术上可行,但会面临三重困境:首先,开发维护将大幅提升研发成本;其次,用户在不同设备上获得的AI体验将存在明显差异;最重要的是,这种"区别对待"很可能引发用户群体的强烈不满。
因此可以预见,苹果的 iPhone 产品线的端侧大模型仍然面临着难产的局面。
果粉们仍需有耐心,或许 iPhone 17、iPhone 18 都不会有好的变化。