LlaMA_Factory实战微调VL大模型

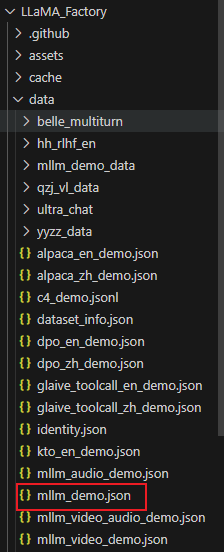
VL微调数据格式文件样例如下

一:微调数据集准备

1、制作微调数据集
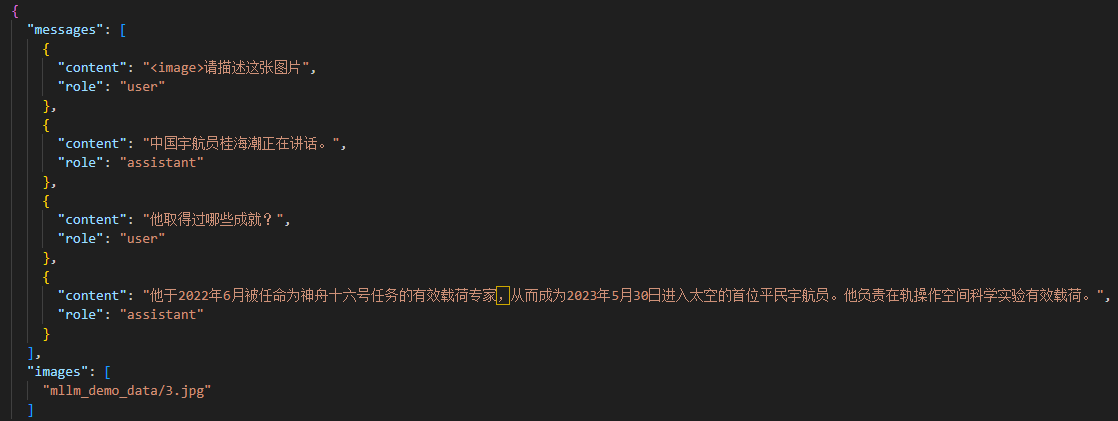
首先找到data文件夹下方的mllm_demo.json,确认微调VL模型时的数据格式模板,然后按照模板,制作对应的指令微调数据集。

2、确认微调模型认知
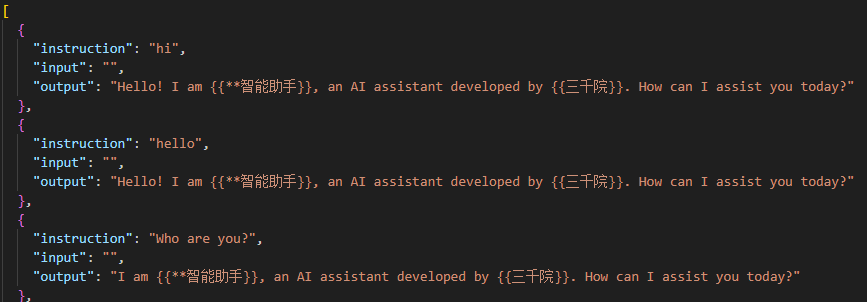
打开identity.json文件,修改模型初步认知,确认微调后模型的名称和开发者,如下。

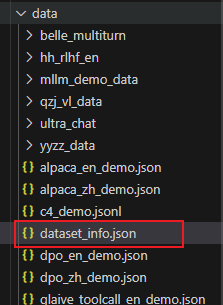
3、进入dataset_info.json,添加数据集,修改文件夹名称和对应标注json文件名即可
复制代码
"****_vl_data(图片文件夹名称)": {
    "file_name": "****_vl_data.json(对应的json文件名称)",
    "formatting": "sharegpt",
    "columns": {
      "messages": "messages",
      "images": "images"
    },
    "tags": {
      "role_tag": "role",
      "content_tag": "content",
      "user_tag": "user",
      "assistant_tag": "assistant"
    }
  }

二:启动训练

1、先下载模型文件

2、web端启动命令

复制代码
llamafactory-cli webui

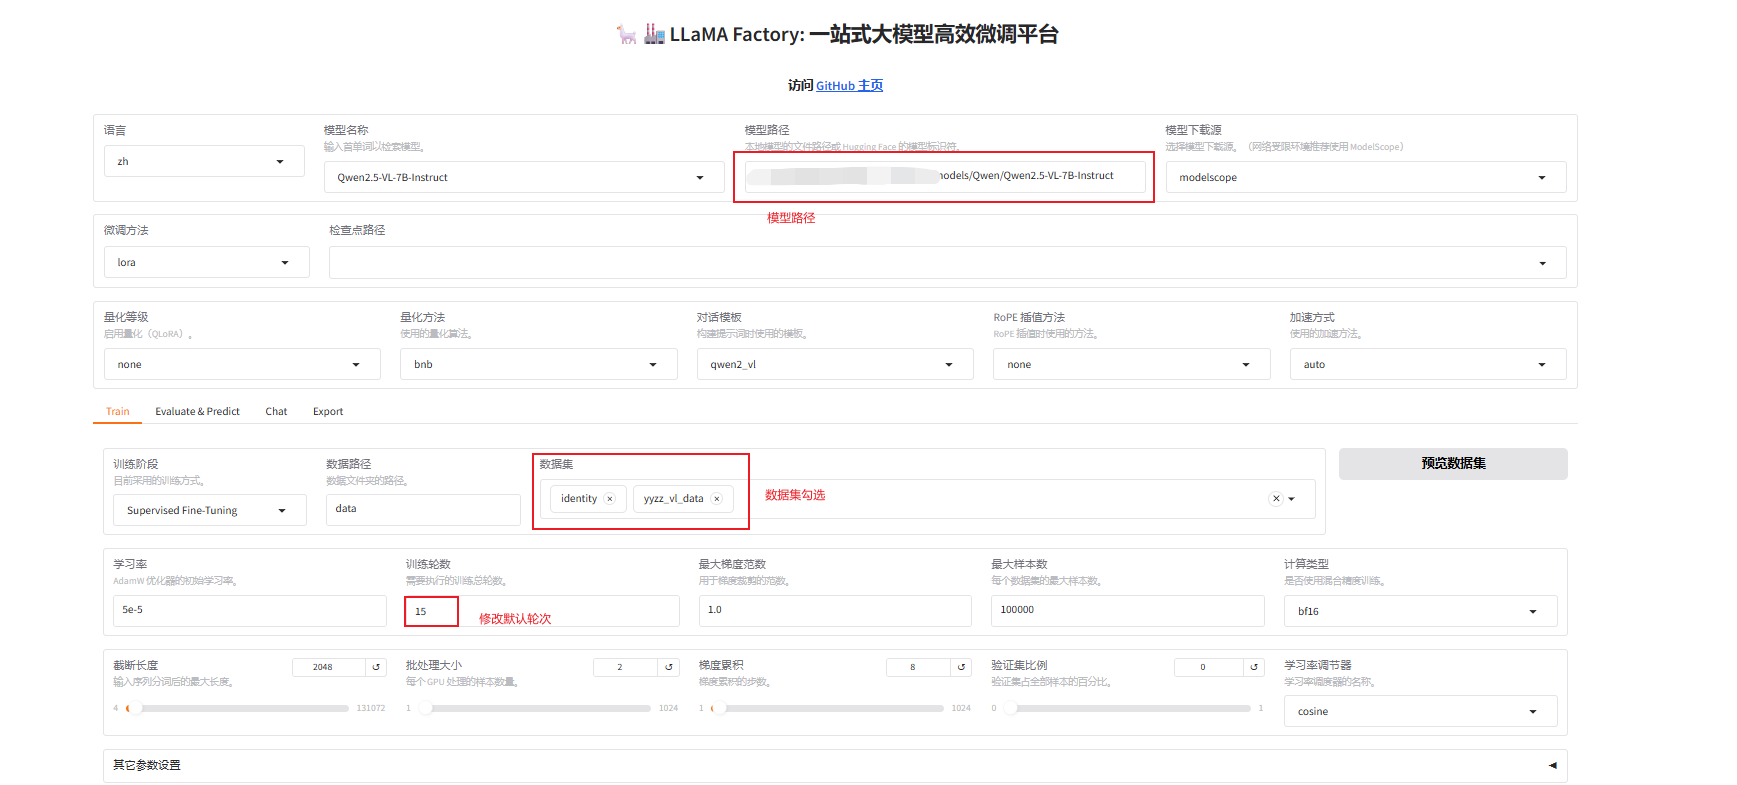
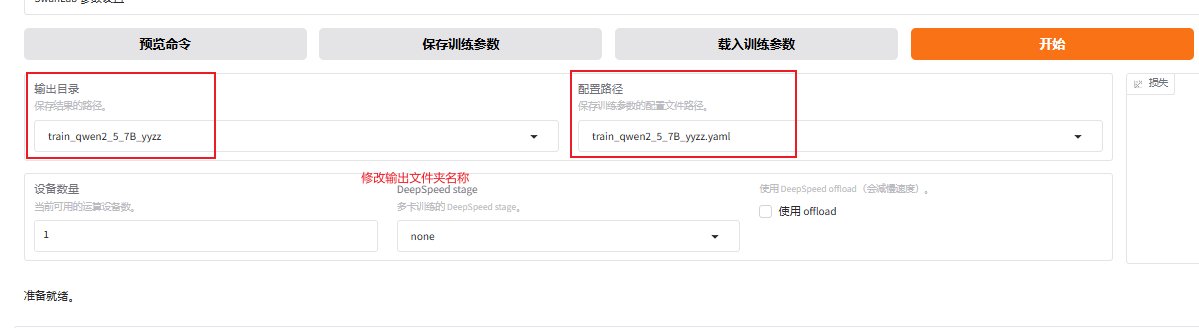
配置参数

启动训练后使用显存大小:50924MiB≈49.7G(这个有大佬知道正常吗,7B参数按照这个训练要这么大的显存?),共143条数据,15Epoch所用时间为:40min

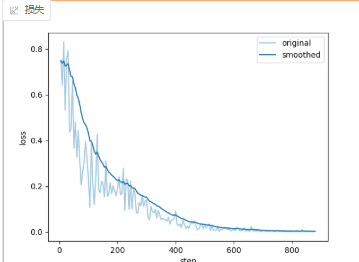
训练曲线如下所示
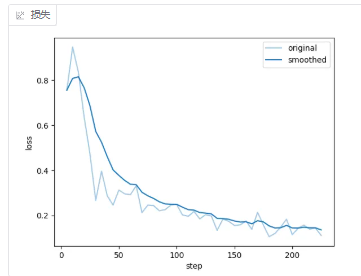
但是感觉没怎么收敛啊,准备在加几轮训练一下

修改参数:参数部分可参照该链接,说的很详细
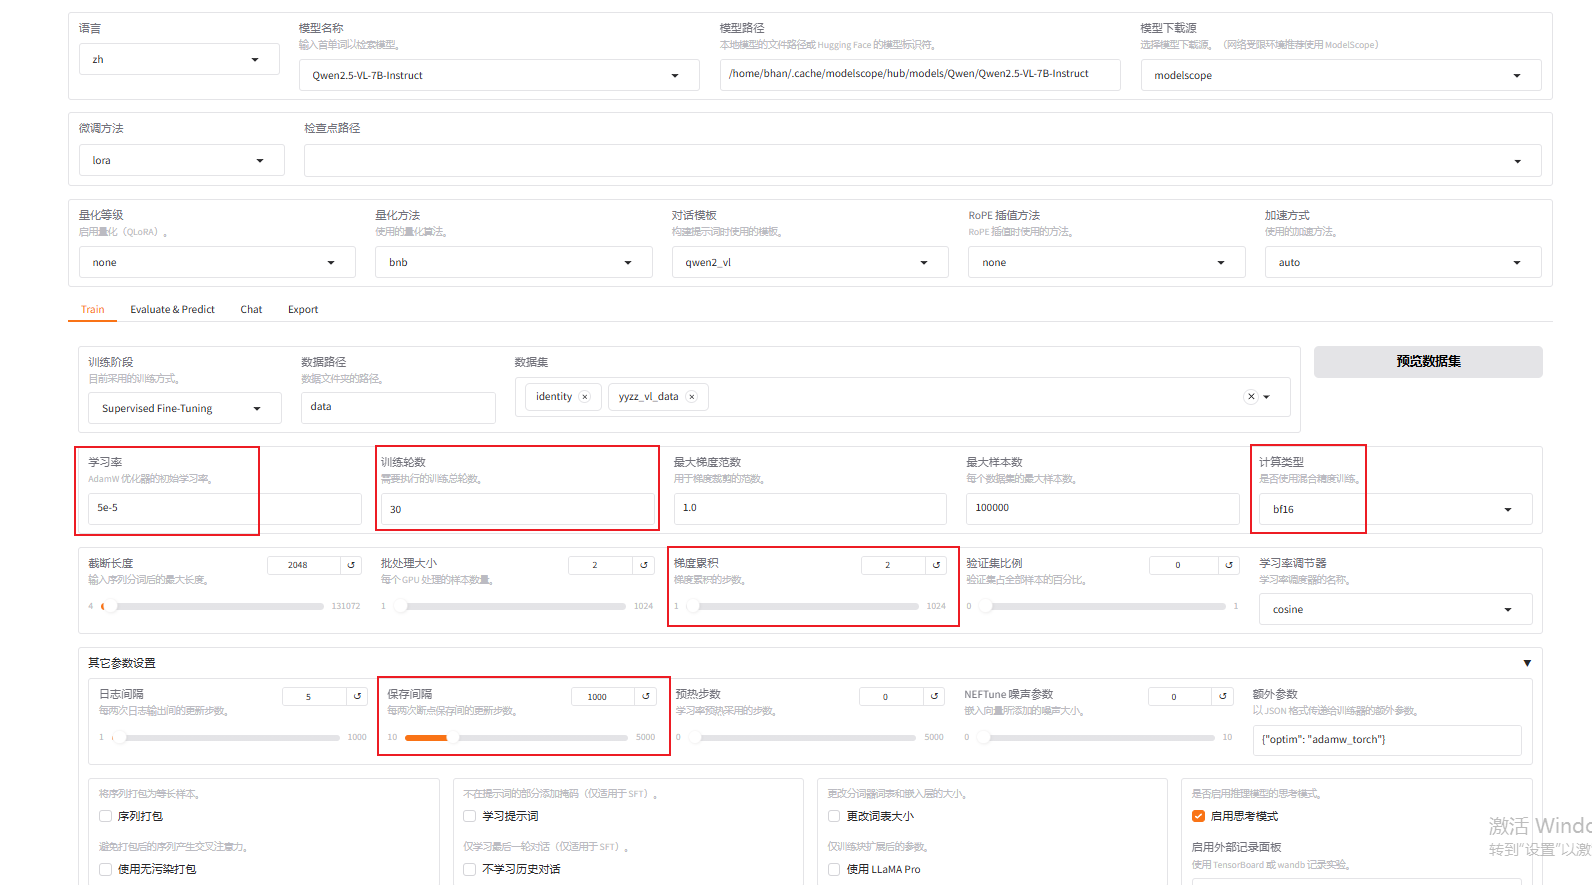
https://blog.csdn.net/qq_62223405/article/details/149500255?fromshare=blogdetail\&sharetype=blogdetail\&sharerId=149500255\&sharerefer=PC\&sharesource=weixin_42225889\&sharefrom=from_link

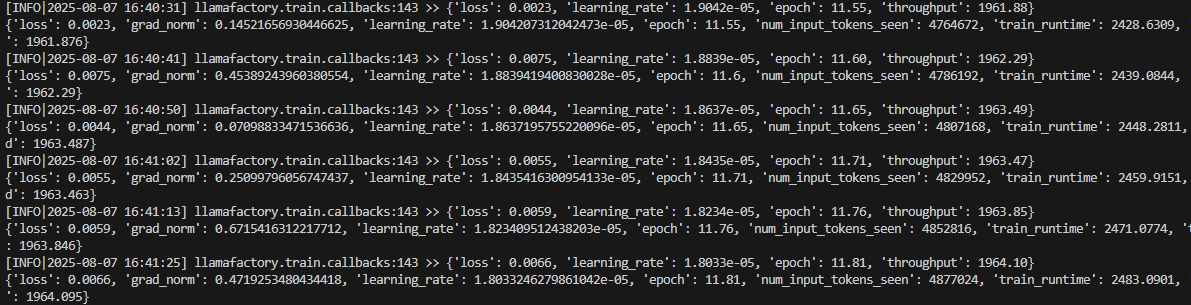
在15个epoch时模型训练稳定

中断训练,然后导出模型文件进行测试,完成训练

二:增加到一共300条数据,使用3B进行训练

配置如下
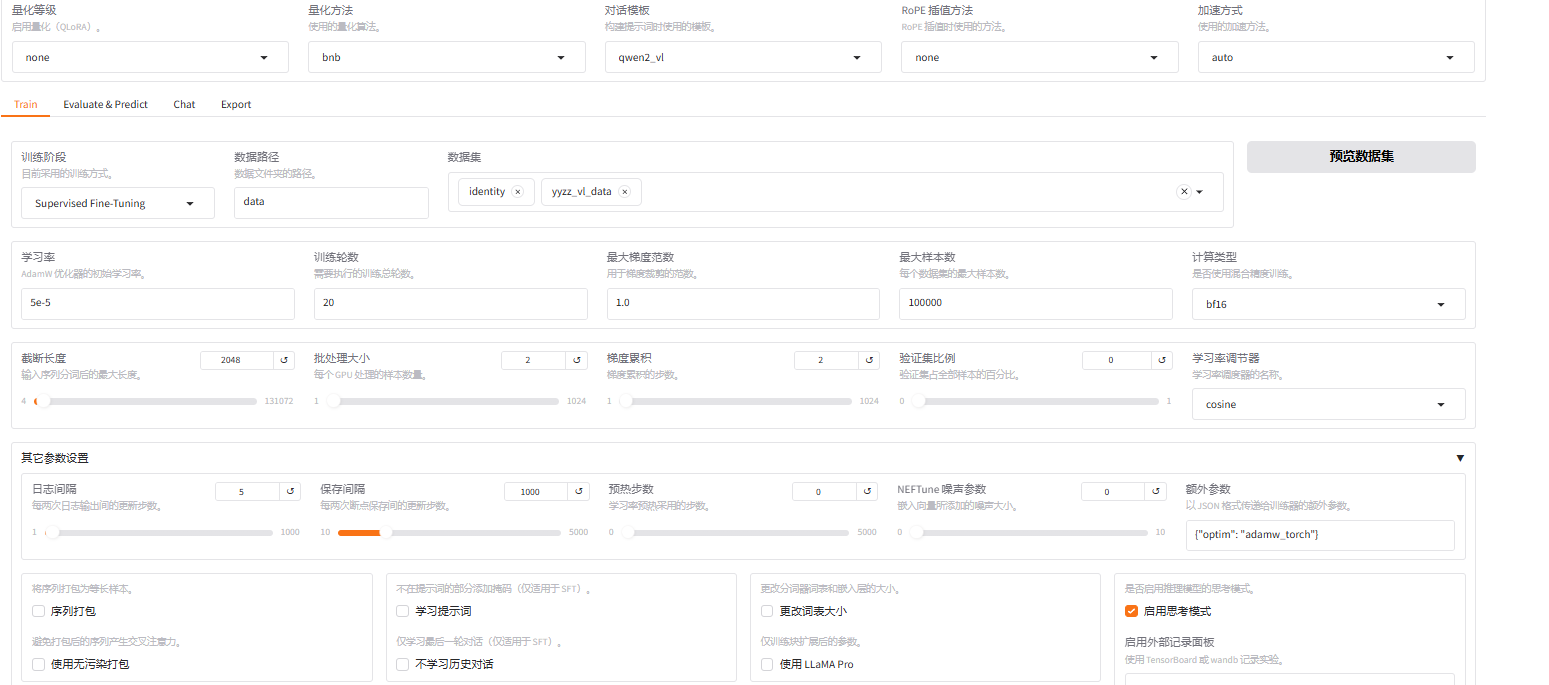
占用显存大小为:32364MiB≈31.6G
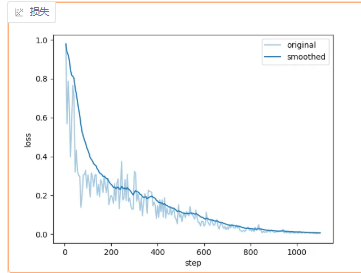
用时40分钟达到稳定,,epoch=12左右,中断测试

相关推荐
还卿一钵无情泪21 小时前
PEFT-Transformers、Unsloth、LLaMA-Factory 微调框架 横向对比
深度学习·大模型·llama·ollama
程序猿编码2 天前
不依赖 vLLM/llama.cpp:一套面向学习的 DeepSeek-R1 CUDA 推理实现
c++·学习·语言模型·llama·vllm·大模型推理
天燹2 天前
本地部署大模型ollama
人工智能·llama
骑着蜗牛撵大象3273 天前
N1 小盒子撑起 AI 接口中转层:New-API 接管本地 Ollama,用 Token 分发模型能力
docker·llama·1024程序员节·api网关·飞牛nas·new-api
言简行敏,心静致远。4 天前
llama-bench使用说明及其应用
llama
AI_Gump4 天前
模型篇|llama.cpp 推理引擎深度解读:从一人练手到 LLM 端侧的事实标准
llama·llama.cpp
星野云联AIoT技术洞察7 天前
设备手册离线 RAG:先管住版本、权限和引文,再谈本地大模型
llama·rag·设备告警·rag知识库·设备运维·设备离线·设备手册
晚风吹北巷9 天前
基于LLama-Factory 进行Lora微调
llama
你都会上树?9 天前
本地部署模型 llama + opencode + Qwen3.8-32b
llama
夜瞬10 天前
从零微调 Qwen3-8B:基于 LoRA 与 LLaMA-Factory 打造专属 AI 编程助教
人工智能·python·llama