队列
做了限制线性表,在一端增长,在另外一端删除的线性表。 先进先出。
允许增加的一端,队尾,
允许删除的一端,队头
循环队列:
队空,head==tail
满队 ,tail+1 == head;
作用: 做缓冲区(速度不匹配)
树
有n节点的有限集合。
根(最上面),叶子节点(最下面的节点),分支节点(中间节点)
树的度:结点中最大的度为树的度
树的高度:从当前节点到最远叶子节点的路径上的节点总数(叶子节点高度为 1,根节点高度等于二叉树的总高度)。
树的深度:从根节点到当前节点的路径上的节点总数(根节点深度为 1,叶子节点深度等于其层级)。
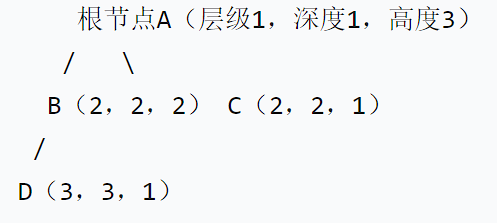
所有的N叉树都可以旋转成二叉树
二叉树,树的度为2.
二叉树树的特性
任意二叉树,i层上最多有2^(i-1)个结点
深度为K的二叉树至多有2^k-1个结点
有n个结点的完全二叉树深度为(logn/log2)+1(向下取整)
所有类型的二叉树都满足:n=n0+n1+n2
原因:总节点数 = 叶子节点数 + 1 子节点节点数 + 2 子节点节点数。
叶子节点数 = 2 子节点节点数 + 1(此公式对所有二叉树均成立,无论是否为特殊类型)。
完全二叉树的\(n_1\)只能是 0 或 1(因最后一层叶子节点靠左排列,不会出现 "单个子节点在右侧" 的情况):
若 n 为奇数(总节点数为奇):\(n_1 = 0\),则\(n_0 = (n + 1)/2\),\(n_2 = (n - 1)/2\);
若 n 为偶数(总节点数为偶):\(n_1 = 1\),则\(n_0 = n/2\),\(n_2 = n/2 - 1\)。
特殊的二叉树:斜树
满二叉树:除叶子节点外,所有内部节点都有 2 个子节点,且叶子节点都在同一层级。
-
总节点数 = \(2^h - 1\)(h 为树的高度);
-
叶子节点数 = \(2^{h-1}\)(占总节点数的一半);
-
不存在仅含 1 个子节点的节点。
完全二叉树:按 "层序遍历顺序" 给节点编号(1~n,n 为总节点数),每个节点的编号都与满二叉树对应位置一致。青春版的满二叉树
二叉树的遍历
广度遍历(从上往下,从左往右)
cs
void Levelordertrav(TreeNode* root, SeqQue* sq)
{
  if (root == NULL)
  {
    return;
  }
  EnterSeqQue(sq, &root);
  DATATYPE data = 0;
  while (!IsEmptySeqQue(sq))
  {
    (data) = *GetHeadSeqQue(sq);
    QuitSeqQue(sq);
    printf("%c", data->data);
    if (NULL != data->left)
      EnterSeqQue(sq, &data->left);
    if (NULL != data->right)
      EnterSeqQue(sq, &data->right);
  }
}
深度遍历
用递归的方法:
前序(根左右)
cs
void PreOrderTravel(TreeNode* root)
{
  if (NULL == root)
  {
    return;
  }
  else
  {
    printf("%c", root->data);
    PreOrderTravel(root->left);
    PreOrderTravel(root->right);
  }
}
中序(左根右)
cs
void MidOrderTravel(TreeNode* root)
{
  if (NULL == root)
  {
    return;
  }
  else
  {
    MidOrderTravel(root->left);
    printf("%c", root->data);
    MidOrderTravel(root->right);
  }
}
后序(左右根)
cs
void LastOrderTravel(TreeNode* root)
{
  if (NULL == root)
  {
    return;
  }
  else
  {
    LastOrderTravel(root->left);
    LastOrderTravel(root->right);
    printf("%c", root->data);
  }
}
哈夫曼树
带权路径(WPL)最小的树
-
节点的权值(Weight)
为每个节点赋予的一个 "数值属性",代表该节点的 "重要性" 或 "出现频率"(如在数据压缩中,权值可表示字符的出现次数)。
-
路径长度(Path Length)
从树的根节点到某一节点的路径上,所经过的 "边的数量"。例如:根节点到其直接子节点的路径长度为 1,到孙节点的路径长度为 2。
-
带权路径长度(Weighted Path Length, WPL)
哈夫曼树的核心评价指标,分为节点的带权路径长度 和树的带权路径长度:
- 节点的带权路径长度 = 该节点的权值 × 根节点到该节点的路径长度;
- 树的带权路径长度 = 所有叶子节点的带权路径长度之和(注意:内部节点的权值不参与计算,仅关注叶子节点)。
哈夫曼树的构建步骤
核心是 "每次选两个权值最小的节点合并"
-
初始化:生成初始叶子节点
将所有给定的权值分别作为 "独立的节点"(每个节点均为叶子节点,无父节点和子节点),并将这些节点放入一个优先队列(最小堆) 中(便于快速获取权值最小的节点)。
初始队列:2, 3, 5, 7(堆顶为 2,权值最小)。
-
迭代合并:生成内部节点
重复以下操作,直到队列中仅剩 1 个节点(即根节点):
- 步骤 1:从队列中取出权值最小的两个节点(记为 A 和 B,A 的权值 ≤ B 的权值);
- 步骤 2:创建一个新的内部节点 C,其权值 = A 的权值 + B 的权值;
- 步骤 3:将 A 作为 C 的左子节点,B 作为 C 的右子节点(左、右顺序可互换,不影响 WPL,但影响后续编码);
- 步骤 4:将新节点 C 放入优先队列中。
以 {2, 3, 5, 7} 为例,具体合并过程:
- 第 1 次合并:取 2(A)和 3(B)→ 生成 C(权值 5),队列变为 5, 5, 7;
- 第 2 次合并:取 5(A,新生成的 C)和 5(B,原叶子节点)→ 生成 D(权值 10),队列变为 7, 10;
- 第 3 次合并:取 7(A)和 10(B)→ 生成 E(权值 17),队列变为 17(仅剩根节点,合并结束)。
-
最终结果
队列中剩余的节点(权值 17)即为哈夫曼树的根节点,从根到叶子的路径构成完整的哈夫曼树(结构如前文示例中的树 2)。
哈夫曼编码
编码规则
基于构建好的哈夫曼树,为每个叶子节点(对应原始字符)分配二进制编码:
- 从根节点出发,向左子树走记为 "0" ,向右子树走记为 "1";
- 从根节点到某叶子节点的 "0/1 序列",即为该叶子节点(字符)的哈夫曼编码。