从零开始训练一个LLM

断断续续大约用了一个月的时间,完全重新训练了一下Cortex LLM,大部分还是在4张4090显卡上训练的。模型还是一个小型的MoE,总参数量大约0.6B,激活参数0.2B。比上一个版本更新了如下内容:

  1. 替换预训练数据集,使用序列猴子通用文本数据集进行预训练。

  2. 采用多阶段预训练和后训练方式。预训练采用两阶段方式,第一阶段上下文长度是512,第二阶段采用YaRN技术将上下文扩展至2048。后训练采用四阶段方式,先在cot数据集上进行SFT,让模型原生支持思考能力,然后使用GSPO增强其逻辑思维能力,再通过融合思考和非思考数据进行SFT,最后使用DPO进行对齐。

  3. 新增思考模式控制,可通过添加/think和/no think控制是否思考。在后训练的第三阶段通过融合cot和非cot数据进行SFT实现。

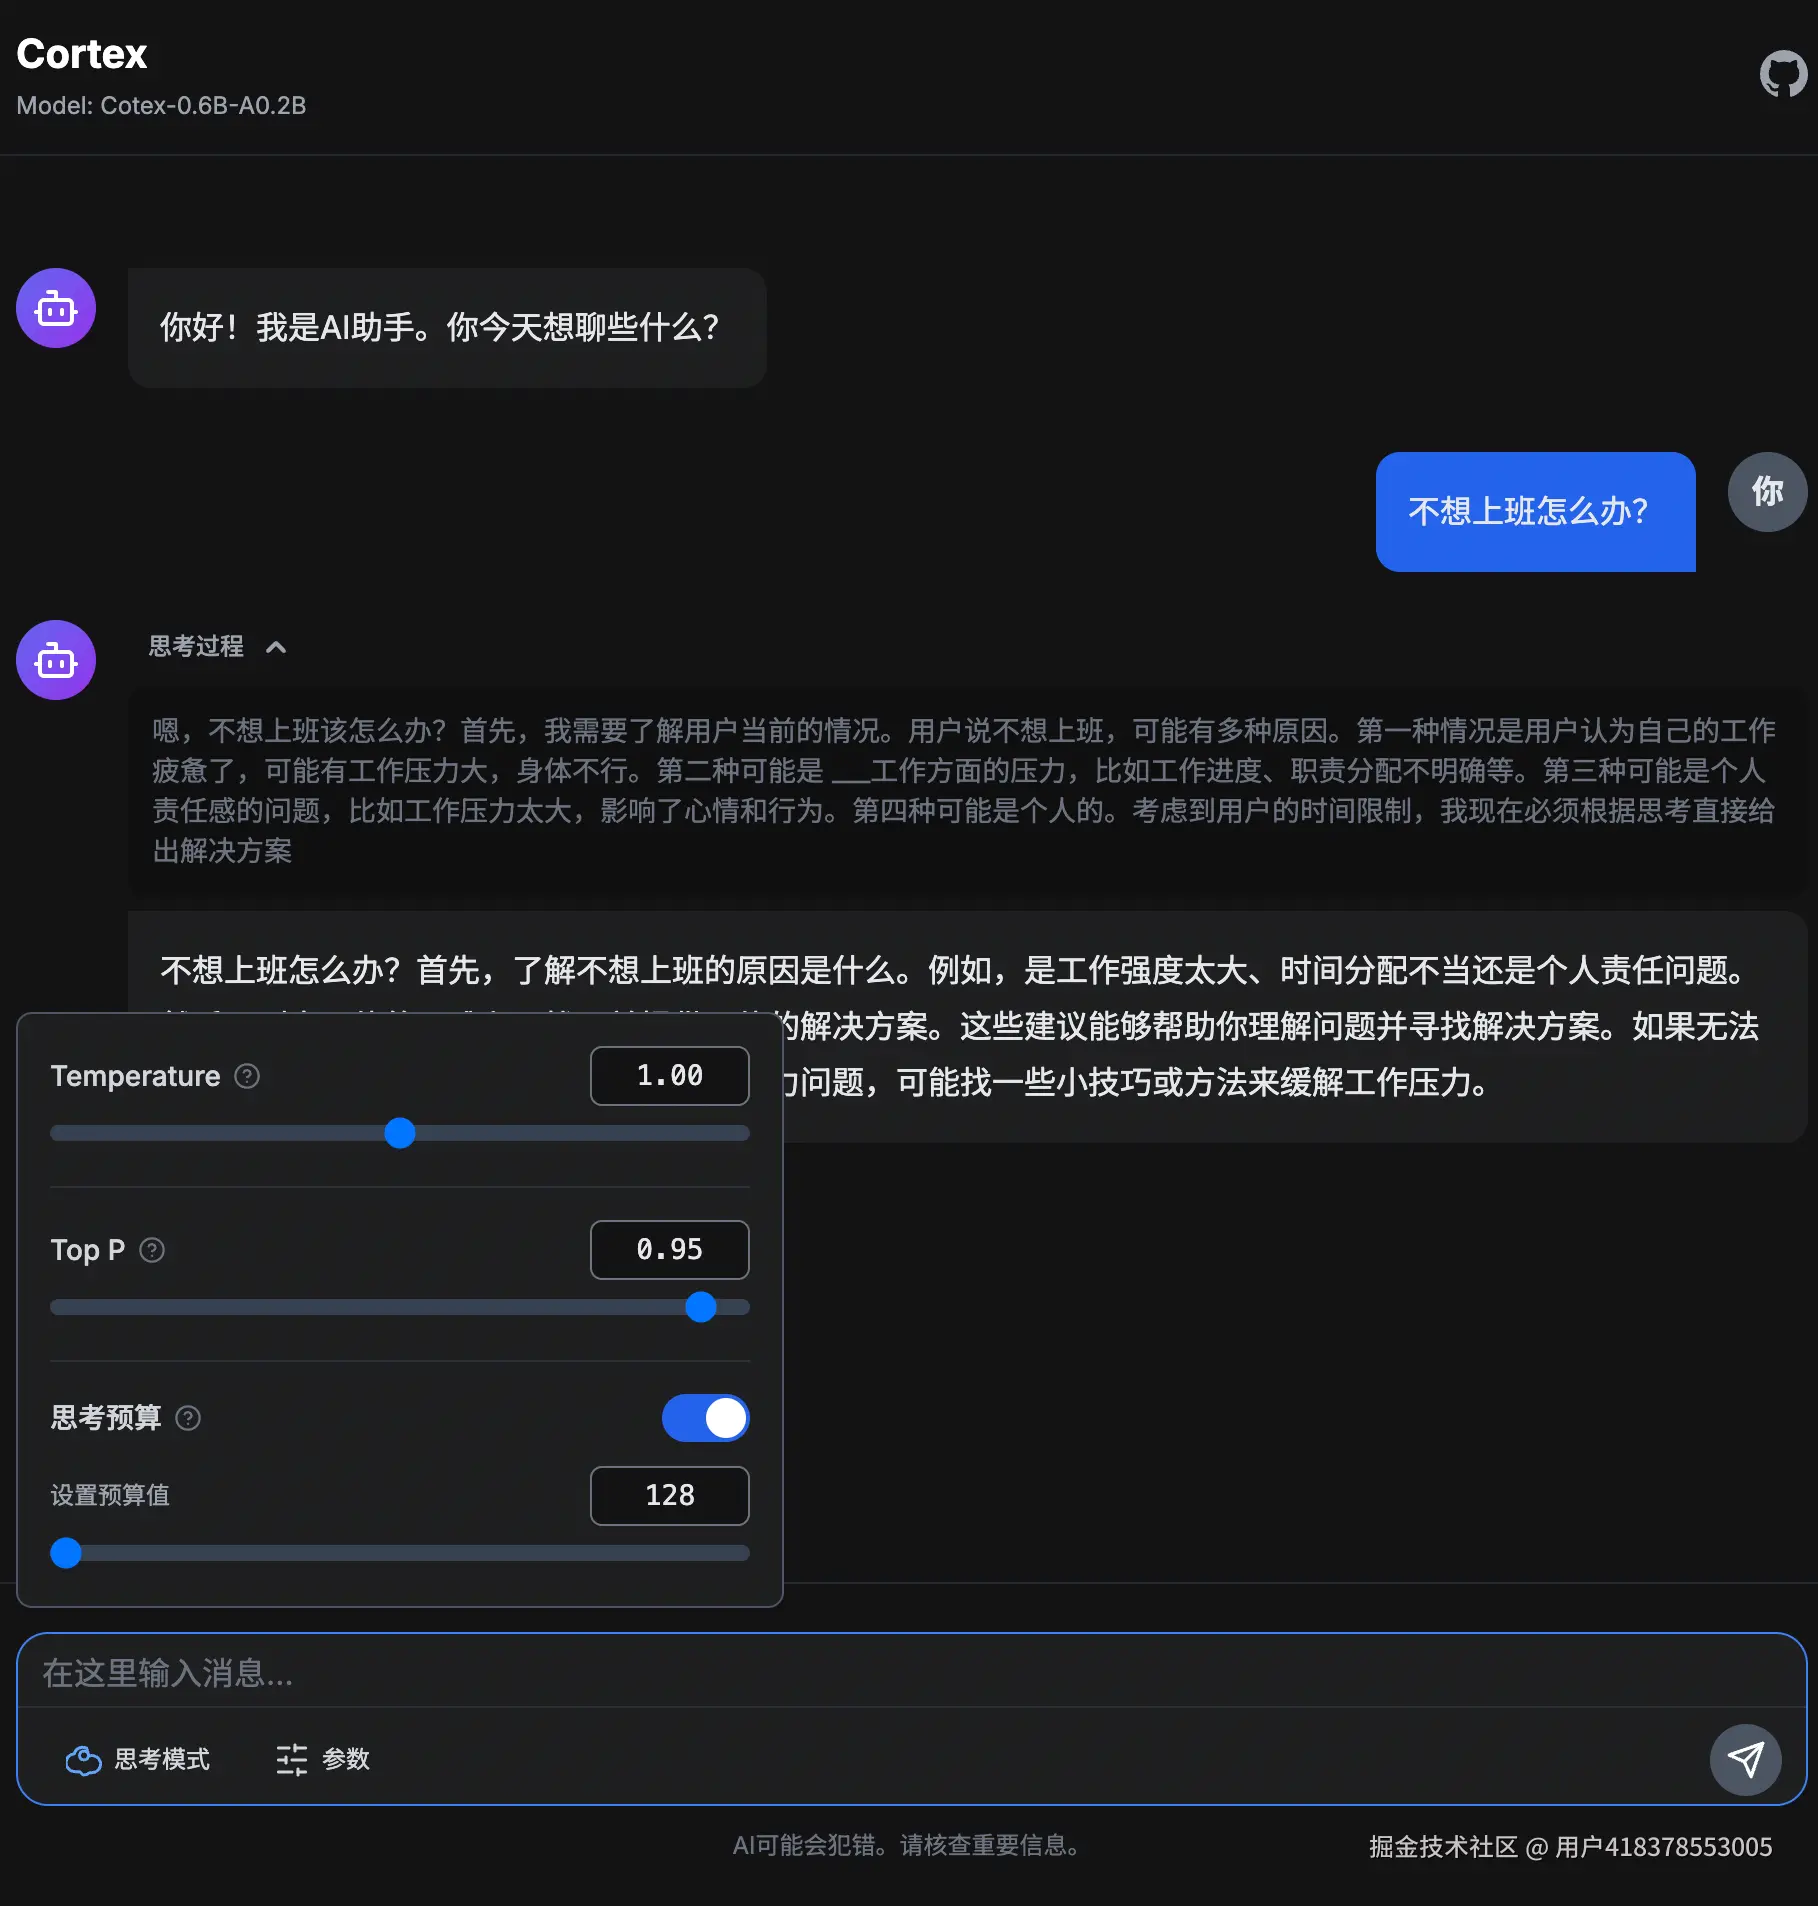
  4. 新增思考预算功能,可控制思考token长度。该功能通过两次调用生成实现。

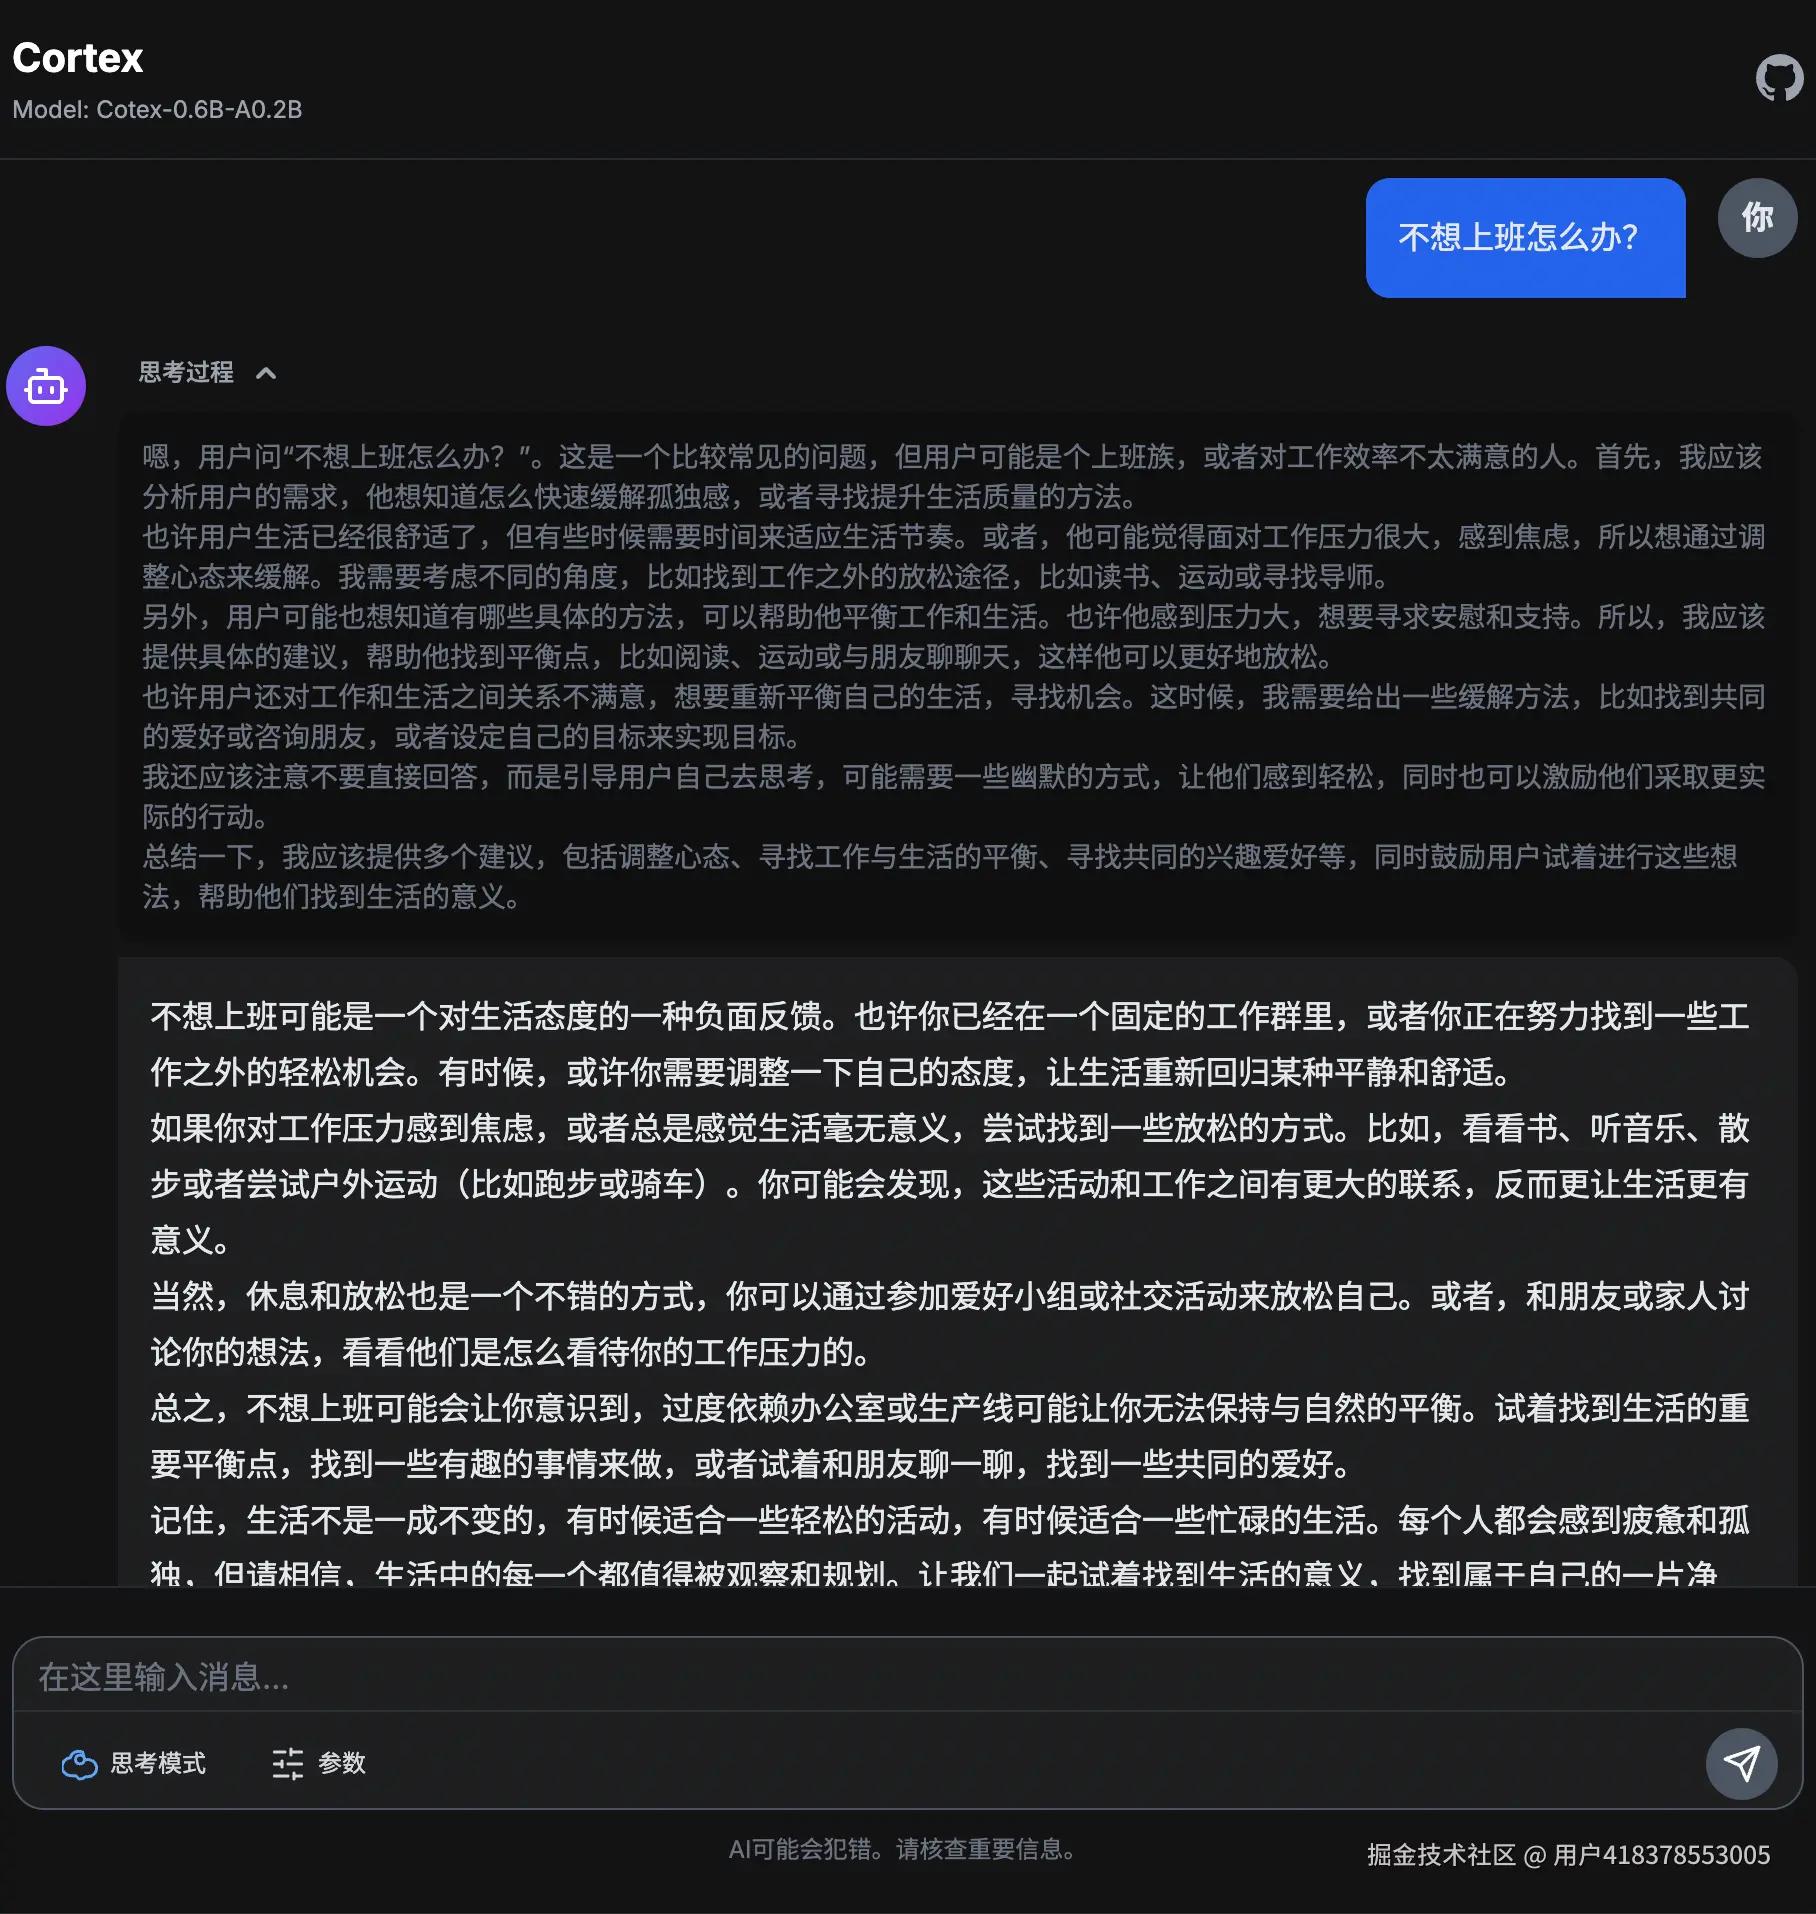
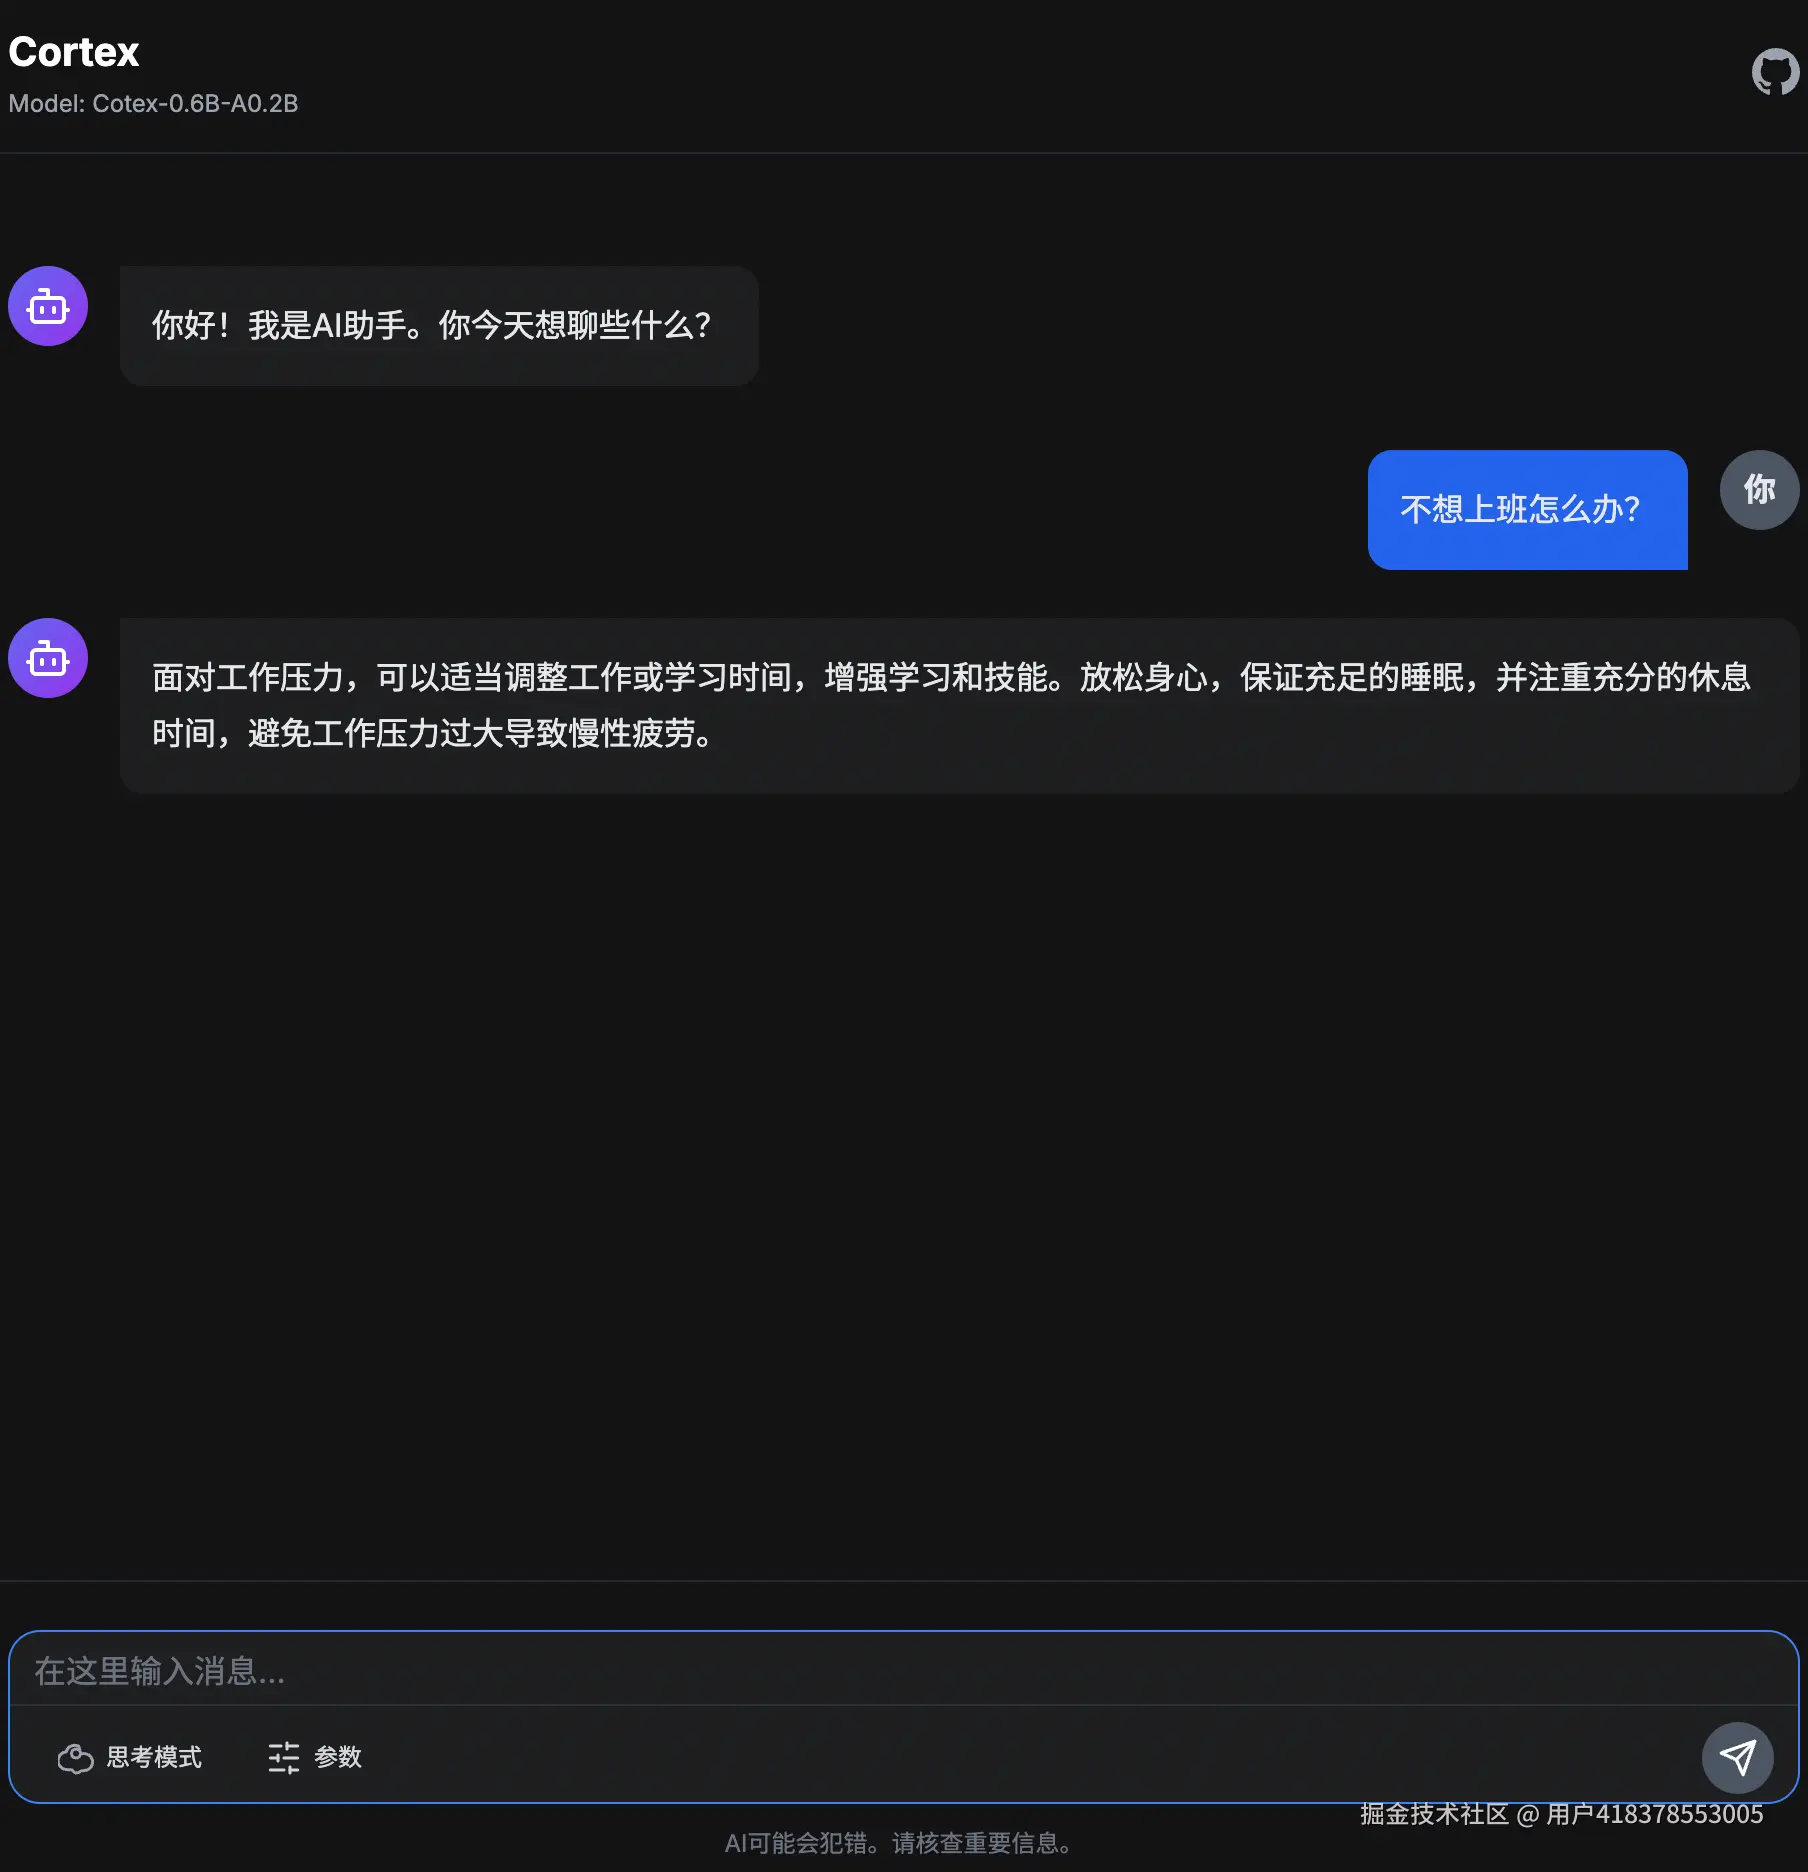
最终模型效果

思考模式
非思考模式
思考预算
模型和训练代码完全开放在github上了。

github.com/qibin0506/C...

另外本项目依赖的模型代码和训练代码也已开源,模型支持LLM和VLM。训练代码支持Pretrain、SFT、GRPO、GSPO、DPO,支持ddp和deepspeed zero0-3训练。

github.com/qibin0506/l...

github.com/qibin0506/l...

相关推荐
ZhengEnCi10 小时前
vLLM是什么:PagedAttention 让大模型推理快 2-4 倍,还能撑起更长思维链
人工智能·性能优化·llm
DigitalOcean15 小时前
WorkBuddy 接入自定义模型教程:配置 GPT、Claude 等大模型
llm·agent
iiiiii1117 小时前
大模型批量生成中的左填充 (left padding)与右填充 (right padding):从生成正确性到 GRPO 的混合策略
人工智能·机器学习·语言模型·大模型·llm·attention·注意力
Eloudy18 小时前
从 huggingFace 下载大模型命令备忘
llm·gpu·rdma
lucas_AI19 小时前
不用一行恶意代码,就能教坏你的 AI Agent:SkillPoison 只用了 15 条『成功经验』
llm
lucas_AI19 小时前
把图转成文字再答题,为什么反而错得更狠?图森破了:答案就吊在那一条边上
llm
lucas_AI20 小时前
DeepMind 发布 Genie 4:世界模型会「出声」了,一句话实时改写世界
人工智能·llm
lucas_AI20 小时前
为什么大模型总敢一本正经地胡说?研究者关掉了它脑内的 8 个「自信开关」
人工智能·llm
blackappleD1 天前
百度 Unlimited OCR 2 拆解:SR-SWA 如何让百页文档的 KV 缓存不再涨
人工智能·llm