Redis有哪些部署方案?
- 单机版*:单机部署,单机redis能够承载的 QPS 大概就在上万到几万不等。这种部署方式很少使用。存在的问题:1、内存容量有限 2、处理能力有限 3、无法高可用。
- 主从模式:一主多从,主负责写,并且将数据复制到其它的 slave 节点,从节点负责读。所有的读请求全部走从节点。这样也可以很轻松实现水平扩容,支撑读高并发。master 节点挂掉后,需要手动指定新的 master,可用性不高,基本不用。
- 哨兵模式:主从复制存在不能自动故障转移、达不到高可用的问题。哨兵模式解决了这些问题。通过哨兵机制可以自动切换主从节点。master 节点挂掉后,哨兵进程会主动选举新的 master,可用性高,但是每个节点存储的数据是一样的,浪费内存空间。数据量不是很多,集群规模不是很大,需要自动容错容灾的时候使用。
- Redis cluster:服务端分片技术,3.0版本开始正式提供。Redis Cluster并没有使用一致性hash,而是采用slot(槽)的概念,一共分成16384个槽。将请求发送到任意节点,接收到请求的节点会将查询请求发送到正确的节点上执行。主要是针对海量数据+高并发+高可用的场景,如果是海量数据,如果你的数据量很大,那么建议就用Redis cluster,所有主节点的容量总和就是Redis cluster可缓存的数据容量。
主从架构
单机的 redis,能够承载的 QPS 大概就在上万到几万不等。对于缓存来说,一般都是用来支撑读高并发的。因此架构做成主从(master-slave)架构,一主多从,主负责写,并且将数据复制到其它的 slave 节点,从节点负责读。所有的读请求全部走从节点。这样也可以很轻松实现水平扩容,支撑读高并发。
Redis的复制功能是支持多个数据库之间的数据同步。主数据库可以进行读写操作,当主数据库的数据发生变化时会自动将数据同步到从数据库。从数据库一般是只读的,它会接收主数据库同步过来的数据。一个主数据库可以有多个从数据库,而一个从数据库只能有一个主数据库。
主从复制的原理?
详情请查看:主从复制
Redis 的主从复制是指一个 Redis 实例(主节点)可以将数据复制到一个或多个从节点(从节点),从节点从主节点获取数据并保持同步。
- 开始同步:从节点通过向主节点发送PSNC命令发起同步,
- 全量复制:如果是第一次连接或之前的连接失效,从节点会请求全量复制,主节点将当前数据快照(RDB文件)发送给从节点。
- 增量复制:全量复制完毕后,主从之间会保持一个长连接,主节点会通过这个连接将后续的写操作传递给从节点执行,来保证数据的一致。
详细流程如下:
- 当启动一个从节点时,它会发送一个
PSYNC命令给主节点; - 全量复制 :如果是从节点初次连接到主节点,那么会触发一次全量复制。此时主节点会启动一个后台线程,开始生成一份
RDB快照文件; - 同时还会将从客户端 client 新收到的所有写命令缓存在内存中。
RDB文件生成完毕后, 主节点会将RDB文件发送给从节点,从节点会先将RDB文件写入本地磁盘,然后再从本地磁盘加载到内存中; - 接着主节点会将内存中缓存的写命令发送到从节点,从节点同步这些数据;
- 增量同步:如果从节点跟主节点之间网络出现故障,连接断开了,会自动重连,连接之后主节点仅会将部分缺失的数据同步给从节点。
主从复制存在的问题
Redis的主从模式重点在于解决整体的承压能力,利用从节点分担读取操作的压力。但是其在容错恢复 等可靠性层面欠缺明显,不具备自动的故障转移与恢复能力:
- 如果slave从节点宕机,整个redis依旧可以正常提供服务,待slave节点重新启动后,可以恢复从master节点的数据同步、然后继续提供服务。
- 如果master主节点宕机,则redis功能受损,无法继续提供写服务,直到手动修复master节点方可恢复。
当然,master节点故障后,也可以手动将其中一个从节点切换为新的master节点来恢复故障。而原先的master节点恢复后,需要手动将其降级为slave节点,对外提供只读服务。
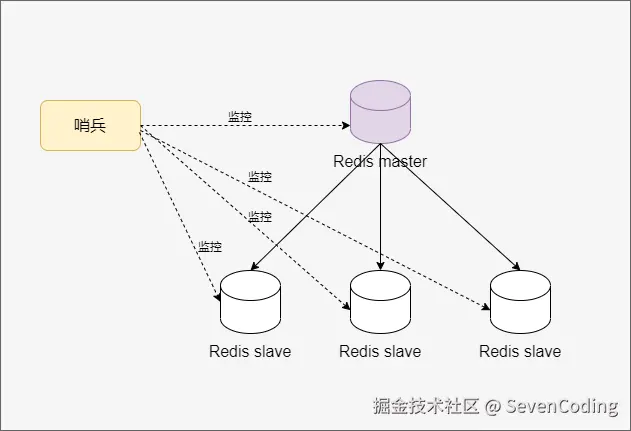
实际使用的时候,手动故障恢复的时效无法得到保证,为了支持自动的故障转移与恢复能力,Redis在主从模式的基础上进行优化增强,提供了哨兵(Sentinel)架构模式。
那么就需要有一个机制,能够监测主节点是否存活,如果发现主节点挂了,就选举一个从节点切换为主节点,并且把新主节点的相关信息通知给从节点和客户端。这就是哨兵机制
Redis 复制延迟的常见原因有哪些?
Redis 的复制延迟是指从节点同步主节点数据时可能出现时间延迟。在读写分离场景,这个延迟会导致明明写入了数据,但是去从节点查的时候没查到。
可能原因如下:
- 网络原因:可能是带宽不足,或者网络抖动导致同步的延迟,不过一般内网情况下不会产生这个问题。
- 主节点负载过高主节点接收到大量的写操作,在处理客户端请求的同时,还需向从节点发送复制数据。如果主节点负载较高时,来不及处理从服务的复制请求,就会导致复制延迟。大量写操作无法避免。但是我们可优化下写入的结构,精简数据,降低单条数据的大小。
- 复制缓存区溢出:复制缓存区暂存当前主节点接收到的写命令,待传输给从节点。如果从节点处理过慢,写入的命令又过多,则会导致复制缓冲区溢出,此时从节点就需要重新执行全量复制,导致延迟。可通过 client-output-buffer-limit间接控制缓冲区大小
- 主节点持久化,无法及时响应复制请求:生成 RDB 快照或 AOF 文件重写都会占用大量的 CPU 和 I/O 资源,可能会影响复制的速度。避免在高峰期触发持久化动作。
- 从节点配置太差:因为从节点需要接收、处理和存储主节点发送的数据。如果从节点性能较低,处理数据的速度会慢,从而导致延迟。此时需要升配。
Redis 的哨兵机制是什么?
Redis 的哨兵机制(Sentinel)是一种高可用性解决方案,用于监控 Redis 主从集群,自动完成主从切换,以实现故障自动恢复和通知。主要功能包括:
- 监控:哨兵不断监控 Redis 主节点和从节点的运行状态,定期发送 PING 请求检查节点是否正常。
- 自动故障转移:当主节点发生故障时,哨兵会选举一个从节点提升为新的主节点,并通知客户端更新主节点的地址,从而实现高可用。
- 通知:哨兵可以向系统管理员或其他服务发送通知,以便快速处理 Redis 实例的状态变化。
哨兵Sentinel工作原理?
详情请查看:哨兵机制
- 每个
Sentinel以每秒钟一次的频率向它所知道的Master,Slave以及其他Sentinel实例发送一个PING命令。 - 如果一个实例距离最后一次有效回复
PING命令的时间超过指定值, 则这个实例会被Sentine标记为主观下线。 - 如果一个
Master被标记为主观下线,则正在监视这个Master的所有Sentinel要以每秒一次的频率确认Master是否真正进入主观下线状态。 - 当有足够数量的
Sentinel(大于等于配置文件指定值)在指定的时间范围内确认Master的确进入了主观下线状态, 则Master会被标记为客观下线 。若没有足够数量的Sentinel同意Master已经下线,Master的客观下线状态就会被解除。 若Master重新向Sentinel的PING命令返回有效回复,Master的主观下线状态就会被移除。 - 哨兵节点会选举出哨兵 leader,负责故障转移的工作。
- 哨兵 leader 会推选出某个表现良好的从节点成为新的主节点,然后通知其他从节点更新主节点信息。
Redis cluster实现原理?
详情请查看:集群
哨兵模式解决了主从复制不能自动故障转移、达不到高可用的问题,但还是存在主节点的写能力、容量受限于单机配置的问题。而cluster模式实现了Redis的分布式存储,每个节点存储不同的内容,解决主节点的写能力、容量受限于单机配置的问题。
Redis cluster集群节点最小配置6个节点以上(3主3从),其中主节点提供读写操作,从节点作为备用节点,不提供请求,只作为故障转移使用。
Redis cluster采用虚拟槽分区,所有的键根据哈希函数映射到0~16383个整数槽内,每个节点负责维护一部分槽以及槽所映射的键值数据。

工作原理:
- 通过哈希的方式,将数据分片,每个节点均分存储一定哈希槽(哈希值)区间的数据,默认分配了16384 个槽位
- 每份数据分片会存储在多个互为主从的多节点上
- 数据写入先写主节点,再同步到从节点(支持配置为阻塞同步)
- 同一分片多个节点间的数据不保持一致性
- 读取数据时,当客户端操作的key没有分配在该节点上时,redis会返回转向指令,指向正确的节点
- 扩容时时需要需要把旧节点的数据迁移一部分到新节点
在 redis cluster 架构下,每个 redis 要放开两个端口号,比如一个是 6379,另外一个就是 加1w 的端口号,比如 16379。
16379 端口号是用来进行节点间通信的,也就是 cluster bus 的东西,cluster bus 的通信,用来进行故障检测、配置更新、故障转移授权。cluster bus 用了另外一种二进制的协议,gossip 协议,用于节点间进行高效的数据交换,占用更少的网络带宽和处理时间。
优点:
- 无中心架构,支持动态扩容;
- 数据按照
slot存储分布在多个节点,节点间数据共享,可动态调整数据分布; - 高可用性 。部分节点不可用时,集群仍可用。集群模式能够实现自动故障转移(failover),节点之间通过
gossip协议交换状态信息,用投票机制完成Slave到Master的角色转换。
缺点:
- 不支持批量操作(pipeline)。
- 数据通过异步复制,不保证数据的强一致性。
- 事务操作支持有限 ,只支持多
key在同一节点上的事务操作,当多个key分布于不同的节点上时无法使用事务功能。 key作为数据分区的最小粒度,不能将一个很大的键值对象如hash、list等映射到不同的节点。- 不支持多数据库空间,单机下的Redis可以支持到16个数据库,集群模式下只能使用1个数据库空间。
- 只能使用0号数据库。
Redis Cluster 模式与 Sentinel 模式的区别是什么?
- Redis Cluster 是 Redis 集群,提供自动分片功能,将数据自动分布在多个节点上,支持自动故障转移。如果一个节点失败,集群会自动重新配置和平衡,不需要外部介入,因为它内置了哨兵逻辑。
- Sentinel是哨兵,主要用于管理多个 Redis 服务器实例来提高数据的高可用性。当主节点宕机,哨兵会将从节点提升为主节点,它并不提供数据分片功能。如果需要处理大量数据并进行数据分片,应选择 Redis Cluster,它支持水平扩展,适用于大规模数据、高吞吐量场景。
如果只是为了提高 Redis 实例的可用性,并不需要数据分片,应选择 主从+Sentinel,它主要关注故障转移和实例高可用,适用于高可用性、读写分离场景。
Redis 集群会出现脑裂问题吗?
Redis 集群存在脑裂问题的风险,特别是在网络分区的情况下,可能会导致同一集群内出现多个主节点,导致数据不一致。
Redis 中如何避免脑裂问题的发生呢?
这里需要了解两个参数:
- min-slaves-to-write:设置主节点在至少有指定数量的从节点确认写操作的情况下才执行写操作
- min-salves-max-lag:设置从节点的最大延迟(以秒为单位),如果从节点的延迟超过这个值,则该从节点不会被计入 min-slaves-to-write 的计数中 举个例子:当 min-slaves-to-write设置为2,min-slaves-max-lag设置为 10 秒时,主节点只有在至少有2 个从节点延迟不超过 10 秒的情况下才会接受写操作,这两个参数就使得发生脑裂的时候,如果某个主节点跟随的从节点数量不够或延迟较大,就无法被写入,这样就能避免脑裂导致的数据不一致。建议集群部署奇数个节点,例如集群数为5,那么可以设置 min-slaves-to-write为3,min-slaves-max-lag为 5-10 秒。
脑裂问题能完全避免吗?
并不能。即使配置了以上两个参数也可能会因为脑裂导致数据不一致。
举个例子,假设某个主节点临时出了问题,哨兵判断它主观下线,然后开始发起选举。在选举进行的时候,主节点恢复了,此时它还是跟着很多从节点,假设 min-slaves-max-log 配置了10s,可能此时从节点和主节点延迟的时间才 6s,因此此时主节点还是可以被写入。而等选举完毕了,选出新的主节点,旧的主节点被哨兵操作需要 salveof 新主,此时选举时间内写入的数据会被覆盖,因此就导致了数据不一致的问题
哈希分区算法有哪些?
- 节点取余分区。 使用特定的数据,如Redis的键或用户ID,对节点数量N取余:hash(key)%N计算出哈希值,用来决定数据映射到哪一个节点上。
优点是简单性。扩容时通常采用翻倍扩容,避免数据映射全部被打乱导致全量迁移的情况。
- 一致性哈希分区。
为系统中每个节点分配一个token,范围一般在0~232,这些token构成一个哈希环。数据读写执行节点查找操作时,先根据key计算hash值,然后顺时针找到第一个大于等于该哈希值的token节点。
这种方式相比节点取余最大的好处在于加入和删除节点只影响哈希环中相邻的节点,对其他节点无影响。
- 虚拟Hash槽分区
所有的键根据哈希函数映射到0~16383整数槽内,计算公式:slot=CRC16(key)&16383。每一个节点负责维护一部分槽以及槽所映射的键值数据。Redis Cluser采用虚拟槽分区算法。
为什么redis集群采用"hash槽"来解决数据分配问题,而不采用"一致性hash"算法呢?
- 一致性哈希的节点分布基于圆环,无法很好的手动控制数据分布,比如有些节点的硬件差,希望少存一点数据,这种很难操作(还得通过虚拟节点映射,总之较繁琐)。
- 而redis集群的槽位空间是可以用户手动自定义分配的,类似于 windows 盘分区的概念,可以手动控制大小。
- 其实,无论是 "一致性哈希" 还是 "hash槽" 的方式,在增减节点的时候,都会对一部分数据产生影响,都需要我们迁移数据。当然,redis集群也提供了相关手动迁移槽数据的命令。
为什么 Redis 集群的最大槽数是 16384 个?
Redis Cluster 采用数据分片机制,定义了 16384个 Slot槽位,集群中的每个Redis 实例负责维护一部分槽以及槽所映射的键值数据。
Redis每个节点之间会定期发送ping/pong消息(心跳包包含了其他节点的数据),用于交换数据信息。
Redis集群的节点会按照以下规则发ping消息:
- 每秒会随机选取5个节点,找出最久没有通信的节点发送ping消息
- 每100毫秒都会扫描本地节点列表,如果发现节点最近一次接受pong消息的时间大于cluster-node-timeout/2 则立刻发送ping消息
心跳包的消息头里面有个myslots的char数组,是一个bitmap,每一个位代表一个槽,如果该位为1,表示这个槽是属于这个节点的。
接下来,解答为什么 Redis 集群的最大槽数是 16384 个,而不是65536 个。
- 如果采用 16384 个插槽,那么心跳包的消息头占用空间 2KB (16384/8);如果采用 65536 个插槽,那么心跳包的消息头占用空间 8KB (65536/8)。可见采用 65536 个插槽,发送心跳信息的消息头达8k,比较浪费带宽。
- 一般情况下一个Redis集群不会有超过1000个master节点,太多可能导致网络拥堵。
- 哈希槽是通过一张bitmap的形式来保存的,在传输过程中,会对bitmap进行压缩。bitmap的填充率越低,压缩率越高。其中bitmap 填充率 = slots / N (N表示节点数)。所以,插槽数越低, 填充率会降低,压缩率会提高。
在 Redis 集群中,如何根据键定位到对应的节点?
Redis 集群将数据分布到 16384 个哈希槽(sots),每个键通过哈希函数计算出一个槽位编号,然后根据槽位编号定位到县体的节点,具体是使用 CRC16 哈希函数计算键的哈希值,然后对 16384 取模, 得到哈希槽编号(范围是0到16383)。
REDIS集群会有写操作丢失吗?为什么
在Redis集群中,由于采用了主从复制模型的异步复制机制,写操作有一定的丢失风险。
当客户端向主节点发送写操作时,主节点会立即返回成功响应,而不等待所有从节点执行复制。如果主节点在执行完写操作后出现故障或网络问题,导致从节点无法及时接收到复制操作,那么这些未复制的写操作将会丢失。
为了减少写操作丢失的可能性,可以采取以下措施:
- 定期监测集群状态,确保主从节点之间的复制正常进行;
- 设置合理的持久化策略,将数据写入磁盘或使用AOF模式以便数据恢复;
- 在应用程序层实施数据确认机制,检查写操作是否成功。
Redis 中如何保证缓存与数据库的数据一致性?
- 先更新缓存,再更新数据库
- 先更新数据库存,再更新缓存
- 先删除缓存,再更新数据库,后续等查询把数据库的数据回种到缓存中
- 先更新数据库,再删除缓存,后续等查询把数据库的数据回种到缓存中
- 缓存双删策略。更新数据库之前,删除一次缓存;更新完数据库后,再进行一次延迟删除
- 使用 Binlog 异步更新缓存,监听数据库的 Binlog 变化,通过异步方式更新 Redis 缓存
以上就是实现数据库与缓存一致性的六种方式,这里前面三种都不太推荐使用,后面三种需要根据实际场景选择:
- 如果是要考虑实时一致性的话,先写 MySQL,再删除 Redis 应该是较为优的方案,虽然短期内数据可能不一致,不过其能尽量保证数据的一致性。
- 如果考虑最终一致性的话,推荐的是使用 binlog + 消息队列的方式,这个方案其有重试和顺序消费,能够最大限度地保证缓存与数据库的最终一致性:。
详情可以看这篇文章:缓存和数据库一致性问题