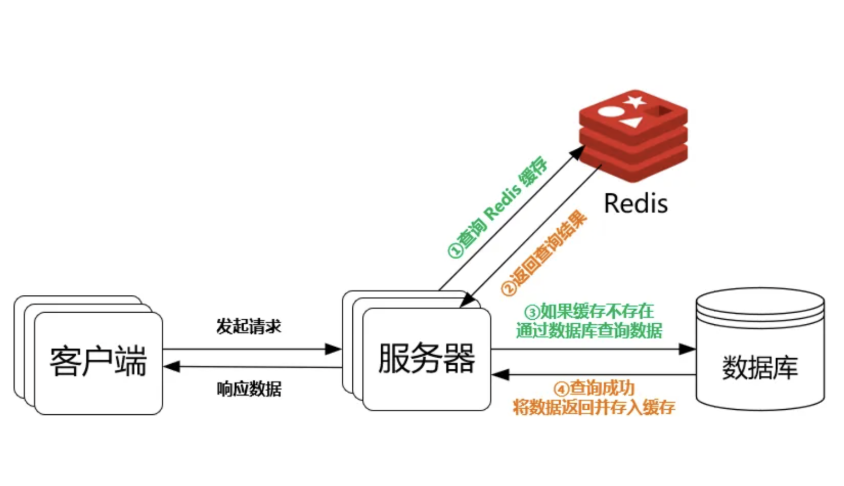
这是一个非常核心且常见的技术主题。我将为你系统地梳理 Redis 的核心原理和常见的面试问题,并附上深入的解析。这不仅能帮助你应对面试,更能深入理解 Redis 的设计思想。
第一部分:Redis 核心原理
1. 为什么快? (核心优势)
这是最根本的问题,几乎所有问题都围绕它展开。Redis 的快得益于其单线程架构 和纯内存操作,但细节远不止如此。
-
纯内存操作:数据存储在内存中,读写操作不受磁盘 I/O 限制。
-
单线程模型 (核心):
-
避免了上下文切换:多线程编程需要处理复杂的锁和线程切换,这会消耗大量 CPU 时间。单线程避免了不必要的性能损耗。
-
避免了竞态条件:所有操作都是顺序串行执行的,不存在加锁释放锁的 overhead,保证了原子性。
-
注意 :Redis 6.0 之后引入了多线程,但这只是为了处理网络 I/O ,核心的命令执行(
set,get,hmset等)依然是单线程的。这解决了网络 I/O 成为瓶颈的问题,但并未改变其命令串行执行的本质。
-
-
高效的数据结构:Redis 精心设计了多种底层数据结构(SDS, HashTable, ZipList, QuickList, SkipList, IntSet 等),使其在时间和空间上都非常高效。
-
I/O 多路复用 :使用
epoll(Linux)、kqueue(BSD)等机制。用一个线程来监控大量的文件描述符(Socket连接),一旦某个描述符就绪(有数据可读/可写),就通知程序进行相应的读写操作。这使得单个线程能高效处理数万个并发连接。
2. 数据结构与内部编码
这是考察对 Redis 理解深度的关键。不仅要懂5种基本类型,更要懂其底层实现。
| 数据类型 | 常用命令 | 底层数据结构(内部编码) | 特点与适用场景 |
| :--- | :--- | :--- | :--- |
| String | SET, GET, INCR | SDS (Simple Dynamic String) | 二进制安全,可存储任何数据(图片、序列化对象)。用于缓存、计数器、分布式锁。 |
| List | LPUSH, RPOP, LRANGE | QuickList (3.2+)
(由 ZipList 组成的双向链表) | 可用作消息队列(FIFO)、栈(LIFO)、慢操作(LINDEX、LINSERT)效率较低。 |
| Hash | HSET, HGET, HGETALL | ZipList (元素少时)
HashTable (元素多时) | 适合存储对象(如用户信息)。可部分获取,节省网络带宽。 |
| Set | SADD, SINTER, SMEMBERS | IntSet (纯整数时)
HashTable (非整数时) | 无序、唯一。用于标签、共同好友(交集)、随机抽奖(SRANDMEMBER)。 |
| ZSet | ZADD, ZRANGE, ZRANK | ZipList (元素少时)
SkipList + HashTable (元素多时) | 有序、唯一。跳表保证范围查询效率,哈希表保证按 member 查询的 O(1) 复杂度。用于排行榜、延迟队列。 |
| 其他 | HyperLogLog, Geo, Stream | 基于上述基础结构实现 | HyperLogLog用于基数统计;Geo用于地理位置;Stream用于消息流(类似Kafka)。 |
面试点 :能说出不同场景下数据结构的底层实现及其转换阈值(可通过 redis.conf 配置)。
3. 持久化机制
如何保证内存中的数据不丢失?这是 Redis 作为数据存储组件必须解决的问题。
-
RDB (Redis Database)
-
原理 :在指定时间间隔内,生成内存数据的快照 (Snapshot)并写入磁盘。
SAVE(阻塞)或BGSAVE(后台 fork 子进程)命令触发。 -
优点:
-
文件紧凑,体积小,适合灾难恢复 和全量备份。
-
恢复大数据集时速度比 AOF 快。
-
-
缺点:
-
会丢失最后一次快照之后的所有数据(数据安全性低)。
-
BGSAVE时 fork 操作,如果数据量大,会导致阻塞,且占用额外内存。
-
-
-
AOF (Append Only File)
-
原理 :记录每一条写命令 ,以日志形式追加到文件末尾。支持每秒同步(
everysec,默认)、始终同步(always,最安全但慢)、由系统决定(no,最快但不安全)三种策略。 -
优点:
-
数据安全性高,最多丢失一秒的数据(默认配置下)。
-
AOF 文件易于理解和解析。
-
-
缺点:
-
文件体积通常比 RDB 大。
-
恢复速度比 RDB 慢。
-
随着命令不断追加,文件会无限增大,需要定期执行 AOF 重写 (
BGREWRITEAOF)来压缩文件(移除冗余命令)。
-
-
-
混合持久化 (Redis 4.0+)
-
原理:结合两者优点。在 AOF 重写时,先将当前数据以 RDB 格式写入 AOF 文件,然后期间的新命令再以 AOF 格式追加。这样恢复时先加载 RDB 快照,再重放增量 AOF 命令。
-
优点 :既保证了恢复速度,又降低了数据丢失风险。是目前生产环境的推荐做法。
-
4. 高可用与集群
如何保证 Redis 服务不中断?
-
主从复制 (Replication)
-
原理:一个主节点(Master)负责写,多个从节点(Slave)负责读和备份。数据从主节点异步复制到从节点。
-
过程 :
SLAVEOF命令建立主从关系。首次连接会进行全量同步 (主节点生成 RDB 发送给从节点),之后通过命令传播进行增量同步。
-
-
哨兵模式 (Sentinel)
-
原理 :哨兵是一个独立的进程,用于监控 主从节点,并在主节点故障时,自动完成故障发现(SD)和转移(Failover),选举出新的主节点,并通知客户端新的地址。
-
功能:监控、通知、自动故障转移、配置提供者。
-
缺点:写操作无法扩展,存储容量受单机限制。
-
-
集群模式 (Cluster)
-
原理 :数据分片 (Sharding)。采用无中心结构,将数据按哈希槽(Slot,共16384个) 分配到多个主节点上。每个节点负责一部分槽。
-
优点:
-
高可用:内置主从复制和故障转移(每个主节点都有从节点)。
-
可扩展性:可通过增加节点轻松扩展读写性能和存储容量。
-
-
key寻址 :客户端直接计算 key 属于哪个槽(
CRC16(key) % 16384),并连接到正确的节点。如果连接错误,节点会返回MOVED错误并指引客户端转向正确节点。
-
第二部分:常见面试问题与解析
基础与原理
-
Redis 为什么这么快?
参考答案:见第一部分第1点。从内存、单线程、数据结构、I/O多路复用四个方面回答。
-
Redis 是单线程的,如何利用多核CPU?
参考答案:可以在一台机器上部署多个 Redis 实例,组成集群模式。这样每个实例是单线程的,但多个实例可以共同利用多核CPU资源。
-
Redis 6.0 之前真的是单线程吗?
参考答案 :不完全是。它的网络 I/O 和命令执行是主线程串行处理的,但持久化(
BGSAVE/BGREWRITEAOF)、异步删除(UNLINK)、同步(SYNC)等操作是由后台线程(BIO) 执行的,以避免阻塞主线程。 -
Redis 的 SDS 和 C 语言的字符串有什么区别?为什么不用 C 的字符串?
参考答案:SDS 更安全、功能更强。
-
获取长度效率 :SDS 有
len属性,O(1) 获取;C 字符串需遍历,O(n)。 -
避免缓冲区溢出:SDS API 会先检查空间,自动扩容。
-
二进制安全 :SDS 可以存储包含
\0的数据(如图片),而 C 字符串以\0结尾,不能存。 -
减少内存重分配 :SDS 有空间预分配 和惰性空间释放机制。
-
持久化与数据管理
-
RDB 和 AOF 的区别?如何选择?
参考答案:见第一部分第3点。选择策略:
-
如果追求极致的数据恢复速度且能容忍数分钟的数据丢失,用 RDB。
-
如果追求最高的数据安全性,用 AOF。
-
生产环境通常两者都开启,并使用 Redis 4.0+ 的混合持久化。
-
-
AOF 重写的过程是怎样的?
参考答案:
-
主进程 fork 一个子进程。
-
子进程基于当前内存数据,生成新的 AOF 重写临时文件。
-
主进程在此期间将新的写命令同时写入 AOF 缓冲区 和 AOF 重写缓冲区。
-
子进程完成重写后,通知主进程。
-
主进程将 AOF 重写缓冲区中的数据追加到新的 AOF 文件中。
-
用新的 AOF 文件原子地替换旧的 AOF 文件。
-
-
Redis 的过期键删除策略?
参考答案 :惰性删除 + 定期删除。
-
惰性删除:只有当访问一个 key 时,才判断它是否过期,过期则删除。优点:对 CPU 友好。缺点:对内存不友好,可能积累大量过期 key。
-
定期删除:每隔一段时间,扫描一定数量的数据库的 expires 字典中一定数量的 key,并清除其中已过期的 key。是前两种的一个折中方案。
-
高可用与集群
-
主从复制原理?
参考答案 :建立连接 -> 全量同步(RDB)-> 命令传播(增量同步)。从节点发送
PSYNC命令,主节点根据runId和offset判断是进行全量同步还是部分同步。 -
哨兵是如何工作的?
参考答案:
-
监控 :每个哨兵每秒向主从节点和其他哨兵发送
PING命令。 -
下线判断 :如果一个节点超时未回复,哨兵会将其标记为主观下线(SDOWN) 。当足够多的哨兵都认为该主节点主观下线时,则将其标记为客观下线(ODOWN)。
-
选举领导者:哨兵节点会选举出一个领导者哨兵来负责故障转移。
-
故障转移:领导者哨兵在从节点中选出一个(优先级高、复制偏移量大、runId小)作为新的主节点,并让其他从节点复制它,并通知客户端。
-
-
Redis Cluster 是如何进行数据分片的?
参考答案 :采用哈希槽(Hash Slot),共16384个槽。每个 key 通过
CRC16(key) mod 16384计算属于哪个槽。集群中的每个主节点负责一部分槽段。客户端可以缓存槽位配置信息,直接访问正确的节点。
实战与场景
-
什么是缓存穿透、击穿、雪崩?如何解决?
-
穿透 :查询一个不存在 的数据,缓存和数据库都没有。解决 :1. 接口校验(如id<=0直接拦截)。2. 缓存空值(
SET null 5s)。3. 布隆过滤器。 -
击穿 :一个热点key 过期瞬间,大量请求直接打到数据库。解决 :1. 设置热点数据永不过期。2. 使用互斥锁(
SETNX),只让一个请求去查DB重建缓存,其他请求等待。 -
雪崩 :大量key 在同一时间过期,或Redis集群宕机。解决:1. 给过期时间加随机值,避免同时过期。2. Redis 高可用(哨兵/集群)。3. 服务降级和熔断。
-
-
如何用 Redis 实现分布式锁?
参考答案 :使用
SET key value NX PX milliseconds命令(原子性地设置键值并指定超时时间)。-
NX:只有当 key 不存在时才设置,保证互斥性。 -
PX:设置超时时间,防止锁持有者崩溃导致死锁。 -
value 应是一个唯一标识(如UUID),在释放锁时(Lua脚本)要先检查标识是否匹配,避免误删其他客户端的锁。
进阶:Redlock 算法,用于在分布式Redis环境中实现更安全的锁。
-
-
Redis 和 Memcached 的区别?
| 特性 | Redis | Memcached |
| :--- | :--- | :--- |
| 数据类型 | 丰富(String, List, Hash, Set, ZSet等) | 简单(key-value) |
| 持久化 | 支持(RDB, AOF) | 不支持 |
| 集群模式 | 原生支持 Cluster | 需客户端支持分片 |
| 线程模型 | 单线程(核心) | 多线程 |
| 应用场景 | 缓存、数据库、消息队列等 | 纯缓存 |
希望这份详细的梳理能帮助你彻底掌握 Redis 的核心原理,并在面试中游刃有余。记住,理解设计思想远比死记硬背答案更重要。