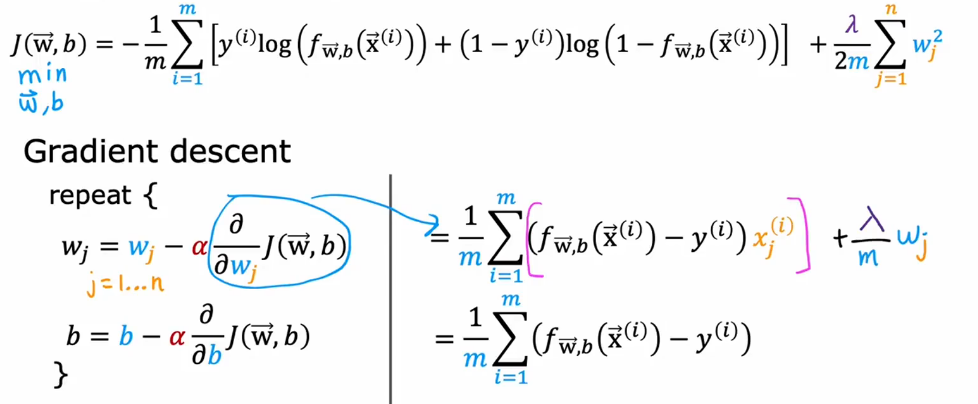机器学习定义
计算机在没有明确编程的情况下,学习能力的研究领域
例:编写一个程序,让计算机可能与自己对弈数万局,通过观察哪些棋盘位置倾向于导致胜利,哪些位置倾向于导致失败,跳棋程序随着时间的推移学会了什么是好的或坏的棋盘位置,通过尝试达到好的位置并避免坏的位置,这个程序越来越擅长玩跳棋
机器学习两种主要类型:
监督学习---许多实际应用中最常用的,发展最快和创新最多的
指的是,学习X到Y,或输入到输出映射的算法
监督学习的关键特征:
你给学习算法提供包含正确答案的实例,正确答案指的是给定输入X的正确标签Y,正是通过看到正确输入X和期望的输出标签Y,算法最终学会了在没有输出标签的情况下仅凭输入就能给出相当准确的预测或者猜测
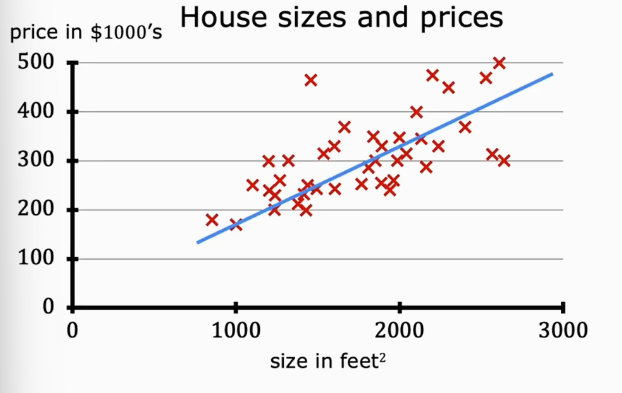
例1:根据房屋大小预测房价
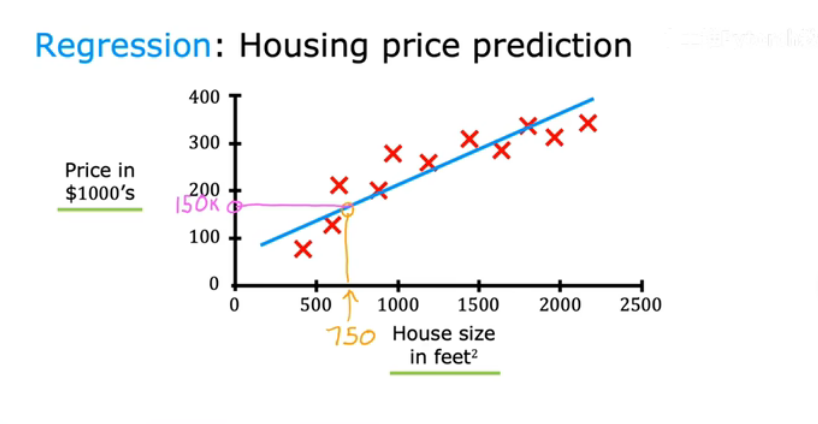
假设一个朋友想知道,750平方英尺的房子价格是多少,学习算法如何进行帮助?
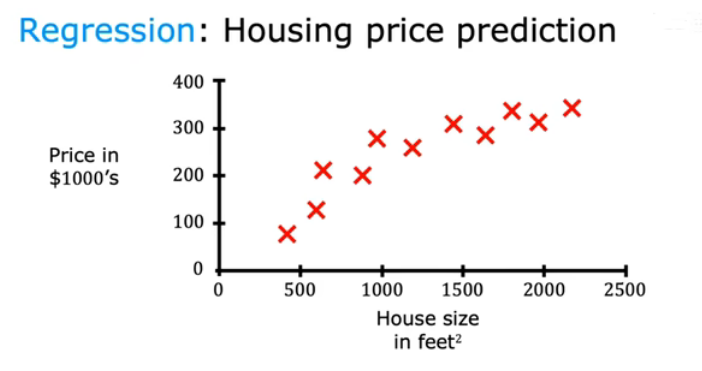
拟合一条直线到数据,
但拟合直线并不是唯一可用的学习算法
比如拟合一条曲线,一个比直线稍微复杂或更复杂的函数
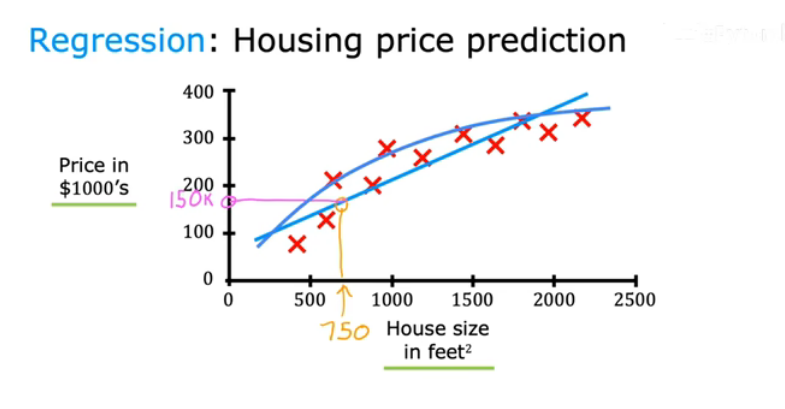
重要的是,如何让算法系统地选择最适合的直线,曲线,或者其他东西来拟合
试图从无限多个可能的数字中预测一个数字,称为回归
例2:乳腺癌检测
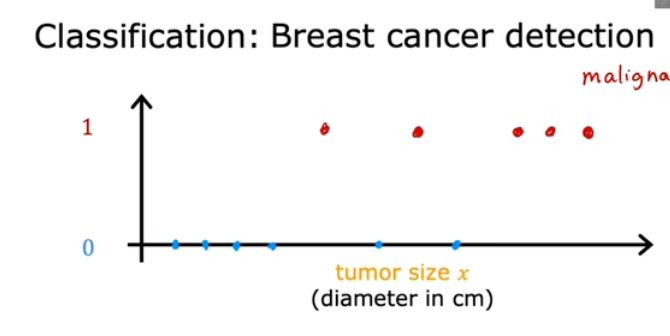
使用患者的数据集,里面有各种大小的肿瘤,你的机器学习系统试图判断一个肿瘤,是恶性(1),还是良性(0),
预测只有少数几种可能的输出,小的,有限的输出类别集合,叫作分类
在分类中,术语输出类和输出类别经常互换使用
也可以在一条线上绘制数据集,用两种不同的符号表示类别
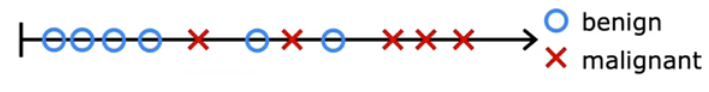
也可以使用多个输入值来预测输出
假如数据集有两个输入,肿瘤大小和患者的年龄,判断良性(圆圈)还是恶性(叉号)
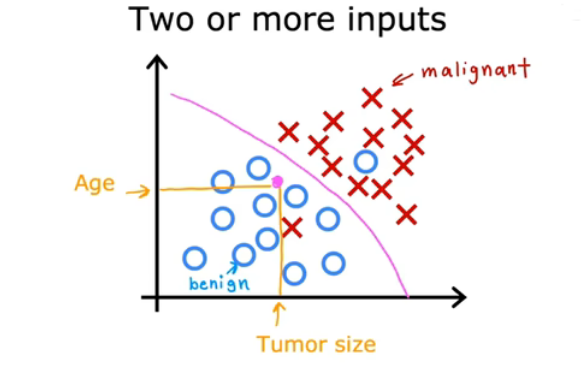
在给定这样的数据集的情况下,学习算法可能会找到边界将恶性与良性分开,因此,学习算法必须决定如何拟合一条边界线来划分这些数据
无监督学习
数据仅包含输入x,没有输出标签Y(正确答案)相关联,所以不知道拿来数据做什么,所以要求算法自己找出数据某种模式或结构
假设得到了关于患者年龄及肿瘤大小的数据,但是没有关于肿瘤良性和恶行的信息,数据集如下
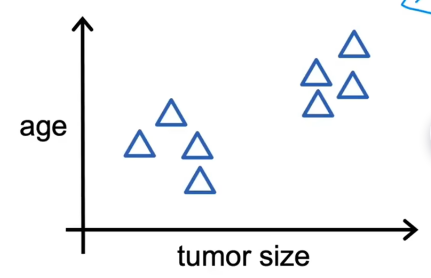
聚类算法:将未标记的数据根据某种规则放入不同的簇中
例如:算法自己阅读文章,找到相关联(如含有相同词语)的文章,进行分组。聚类算法自己从数据中探索和发现哪些词语或模式是重要的,从而形成分组依据,而不是依赖人类事先定义好的规则。
异常检测:用于检测异常事件,
降维:将大数据压缩成小得多的数据集
回归模型,以数字作为输出
分类模型,预测类别或离散类别
分类,存在一组离散的有限可能输出
回归,模型可以输出无限多个可能的数字
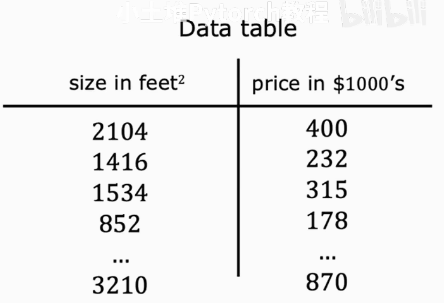
查看数据的有效方式:
图表
数据表
描述数据的符号表示:
用于训练模型的数据集称为训练集
x,输入变量 / 特征 / 输入特征
y,输出变量 / 正在尝试预测的变量 / 目标变量
m,训练样本的总数
( x , y ),单个训练样本
( x^(i) , y^(i) ),引用第i个训练样本
x -> f -> ŷ(y-hat)y-hat是y的估计值或预测值
函数f被称为模型
学习算法关键问题 --- 如何表示函数f,使用什么数学公式来计算
线性回归:
单变量线性回归:有一个单一的输入变量或特征x
关键:构建成本函数
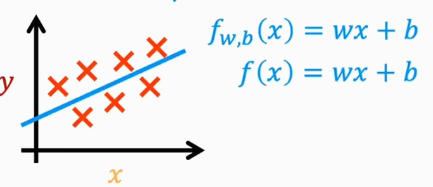
w,b为模型的参数 / 系数 / 权重
要做的是:为参数w,b选择值,以便从函数f得到的直线以某种方式很好地拟合数据
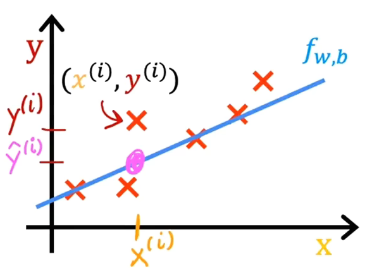
代价函数(Cost function)
通过预测值y-hat与目标值y的差距,即 ŷ - y ,来比较它们,这个差值称为误差,在测量误差时,对于样本i,我们应该计算
(ŷ(i) - y(i))²我们希望在整个训练集上测量误差,将i=1一直加到m
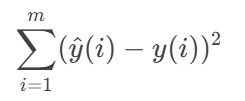
为了构建一个不会随着训练集大小增加而自动变大的代价函数,我们将计算平均平方误差
平方误差代价函数:
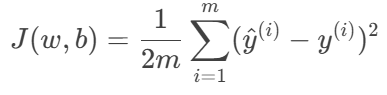
1/2:为了后续求导时抵消平方项的系数2,简化求导后的表达式
也可以写为: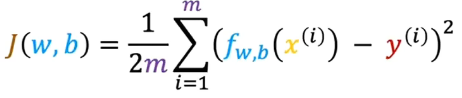
假设 f=wx(b=0)
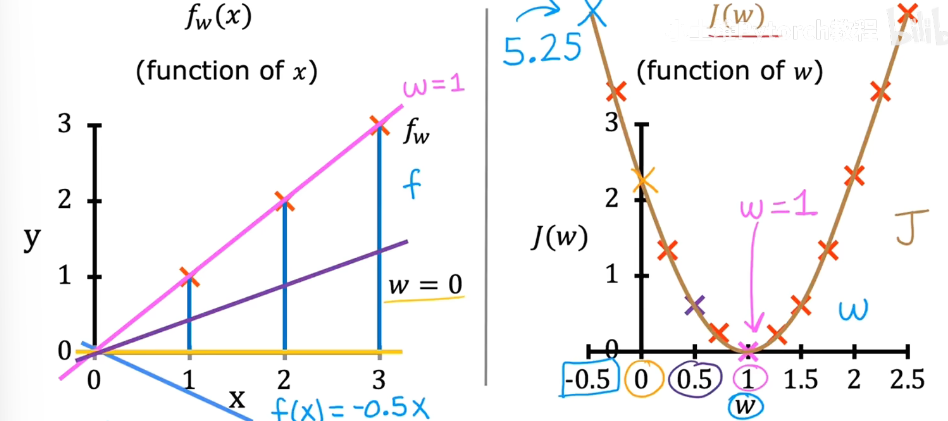
我们希望找到使代价函数J变小的w,b的值
当b≠0时,此时J(w,b)为三维
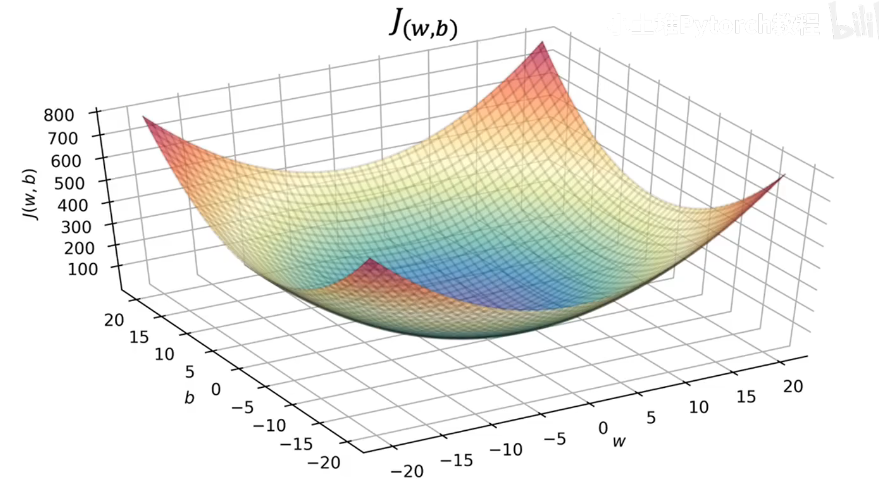
能够更仔细地查看特定点的,另一种绘制代价函数的方法,有助于可视化:等高线图
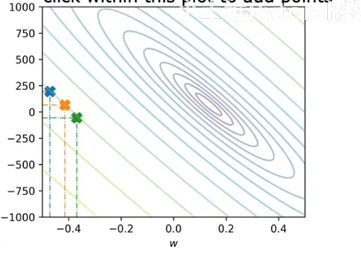
J的最小值在椭圆中心
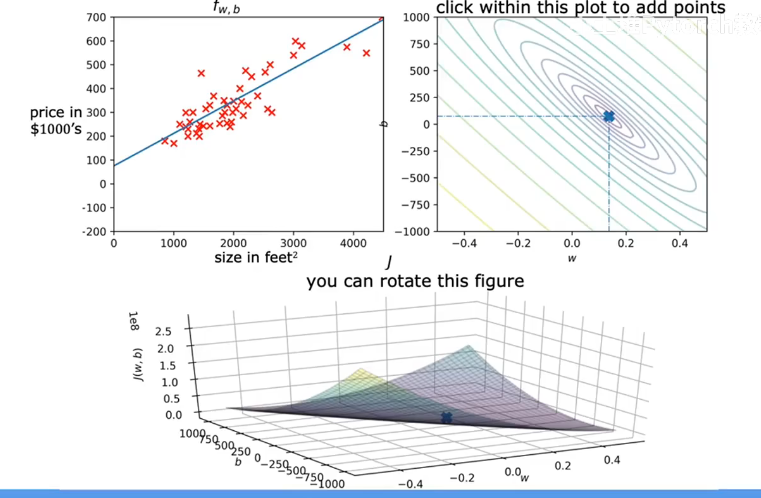
需求:在代码中编写高效算法,用于自动找到使成本函数J最小化的参数w,b的值,从而得到最佳拟合曲线
梯度下降算法:
初始猜测w,b,一般将它们都设置为0 ----> 寻找起点
每次稍微改变参数w和b,以尝试减少代价J,直到J最终稳定或接近最小值
对于某些可能不是碗形的函数,可能存在不止一个可能的最小值
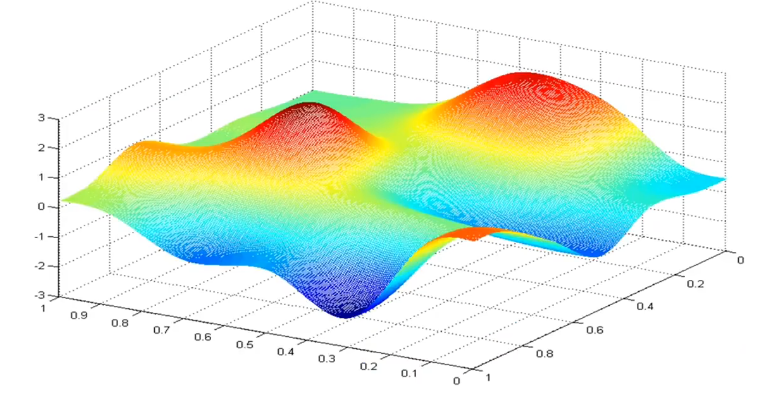
该函数不是一个平方误差代价函数
起点为山顶,目标为山谷,并尽可能高效到达其中一个
其中,梯度算法的作用是:你会旋转360度并环顾四周,寻找下山最快的道路,迈出一步后,重复之前的操作再次旋转寻找。以此类推,知道发现自己到达了山谷
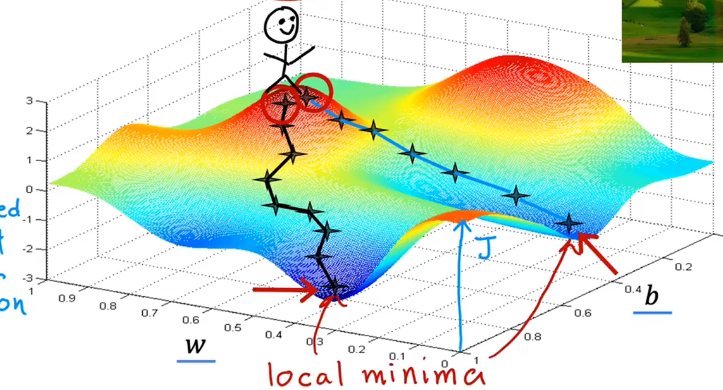
但是一旦你开始下降第一个山谷,梯度下降不会引导你到达第二个山谷
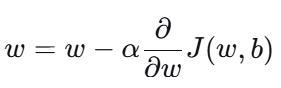
通过取当前的w值,并调整一小部分,即右边这个表达式,减去α乘这个项来更新参数w
α :学习率,通常为介于0和1之间的小正数,相当于控制下坡时步子的大小
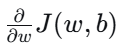
上图为成本函数J的导数项,相当于下坡的方向
相似的赋值操作更新参数b:
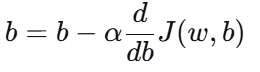
重复这两个更新步骤,直到算法收敛
(达到局部最小值时,参数w和b不再显著变化)
理解导数:
同时将w和b更新到新值:
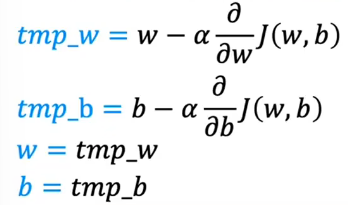
假设J只包含一个参数w,其中是一个数字
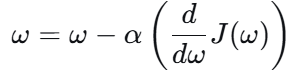
此时,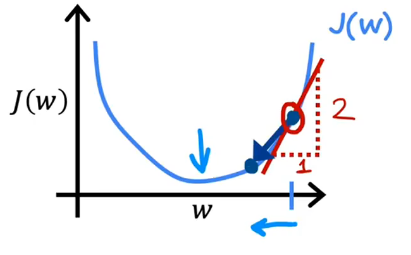
此时导数为正数,w减去该正数变为一个更小的正数,w左移,J变小
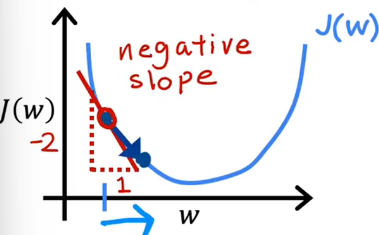
此时导数为负数,w减去该负数变为一个更大的正数,w右移,J变小
理解学习率:
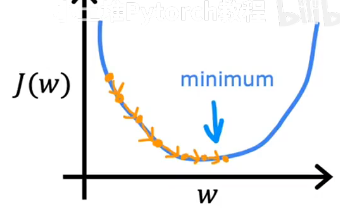
如果学习率过小,只能迈出很小一步,结果为,会非常缓慢地降低代价J,花费时间长
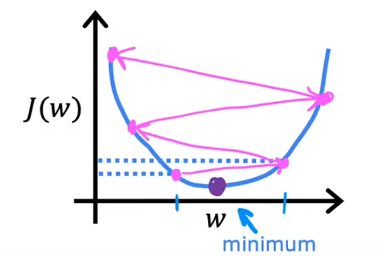
如果学习率过大,就会大步更新w,梯度下降可能会超过最小值,可能无法到达最小值(梯度下降可能无法收敛,甚至可能发散)
如果已经位于局部最小值,梯度下降的下一步会做什么?
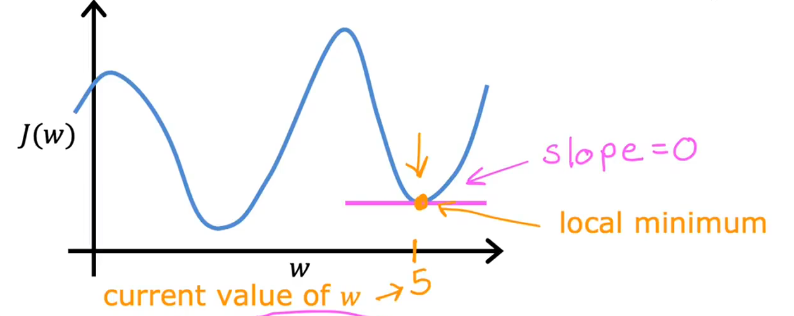
此时导数项为0,式子为
w = w不会再改变参数
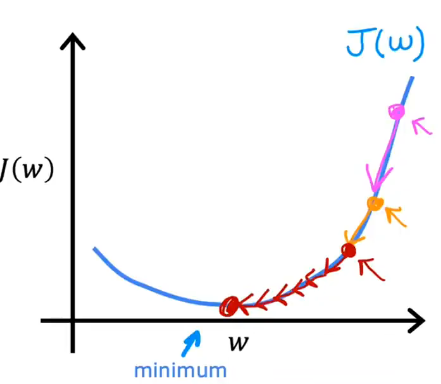
当接近局部最小值时,下降会自动采取更小的步伐,因为导数越来越小
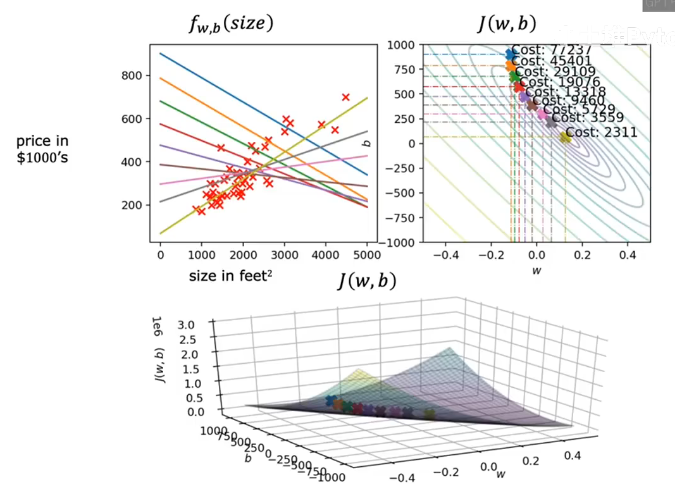
批量梯度下降:在梯度下降的每一步都查看所有的训练样本,而不是训练数据的一个子集
当为多个输入时,

:表示一个训练样本中第j个特征的值
n:表示一个训练样本中特征的数量

:第i个训练样本中第j个特征的值
例:
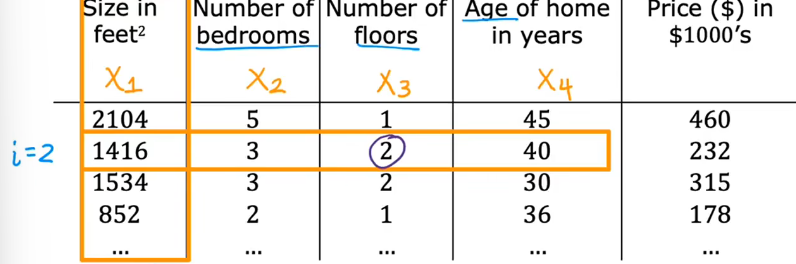
此时,
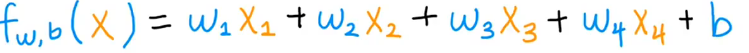
具有n个特征的模型:
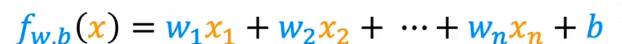
向量化:
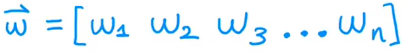
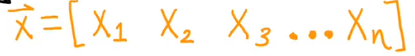
那么可以写成:
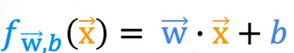
多元线性:具有多个输入特征的线性回归
python
w = np.array([1.0, 2.5, -3.3])
w = np.array([[1.0], [2.5], [-3.3]])  # 列向量形

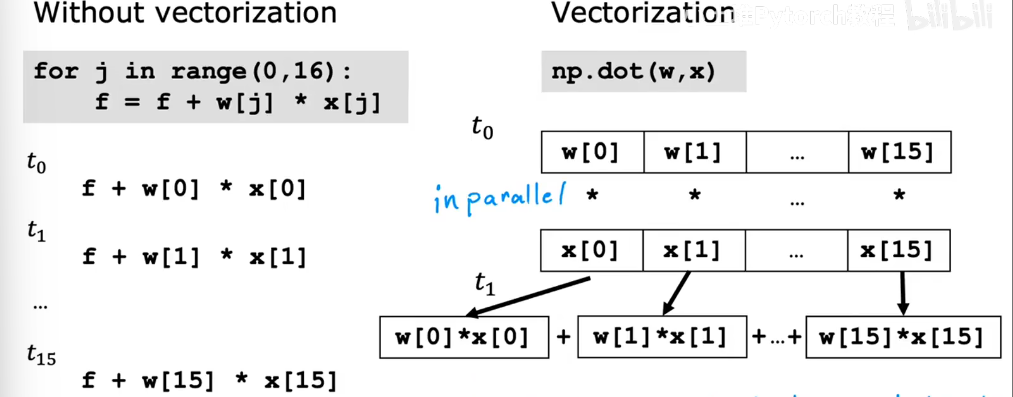
# 计算方法1:手动循环
f = 0
for j in range(n):
    f = f + w[j] * x[j]
f = f + b
print(f)  # 输出: -35.0

# 计算方法2:使用numpy点积(更高效)
f = np.dot(w, x) + b
print(f)  # 输出: -35.0
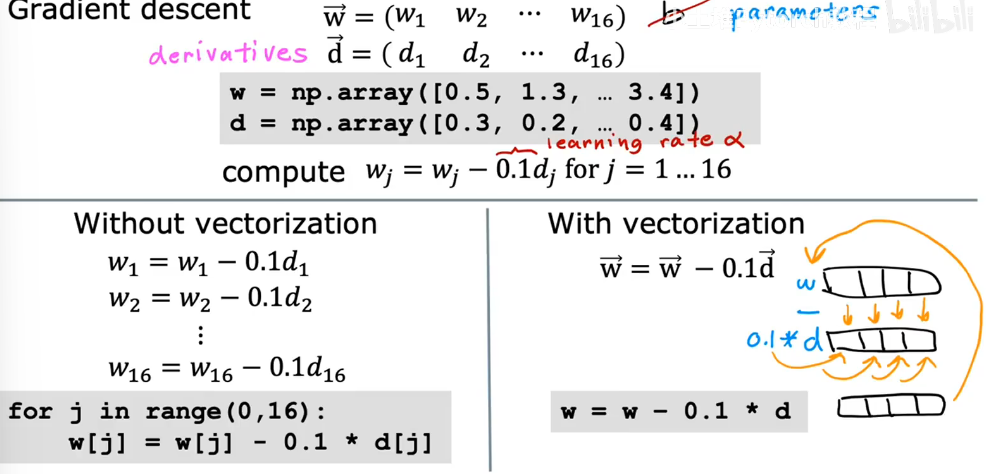
两种计算方法对比:
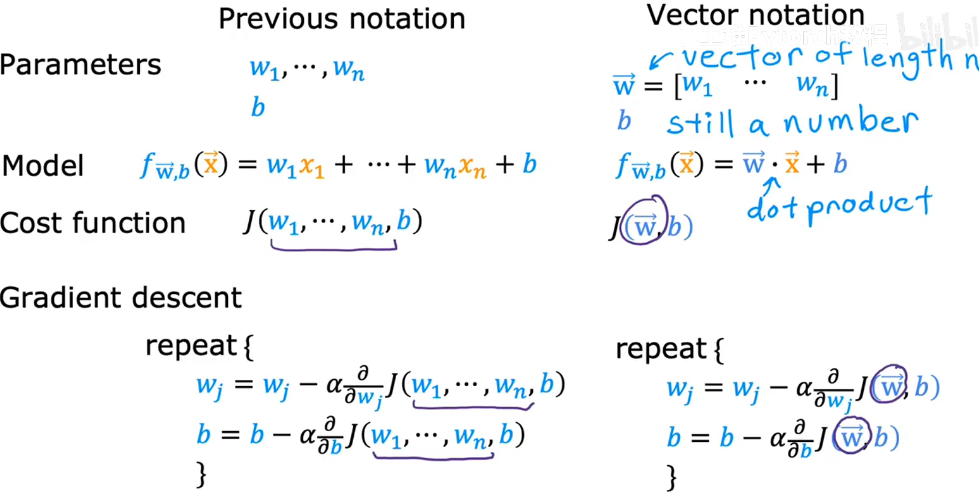
使用向量定义多元线性回归:
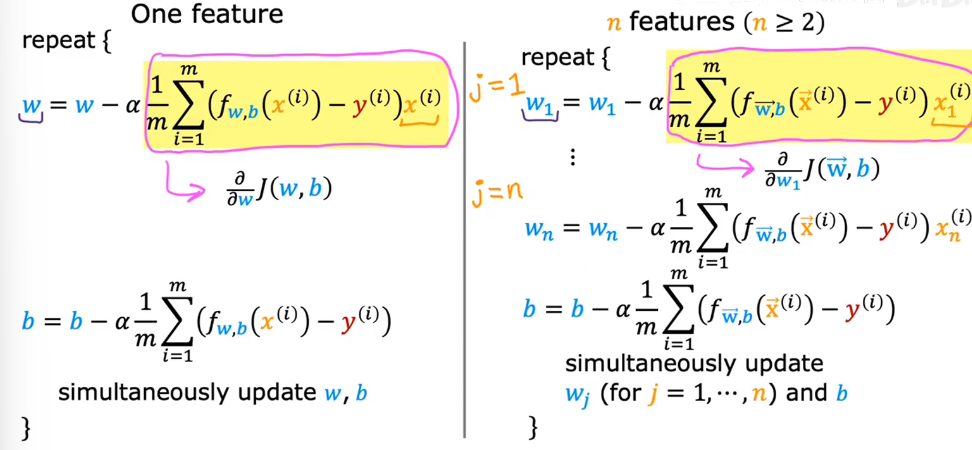
导数部分:
正规方程算法:
通过使用高级线性代数库一次性求解w,b,不需要迭代
与梯度下降不同,正规方程不能推广到其他算法
如果特征数量n很大,正规方程方法会相当慢
对比:
梯度下降:像蒙着眼一步步摸索下山。
正规方程:像直接用GPS算出下山的最短路径,然后一步到位。
特征下降:
使梯度下降运行得更快
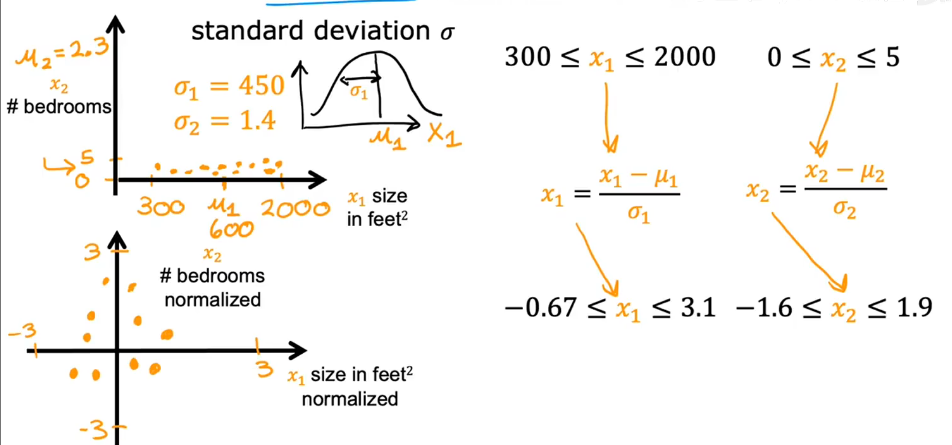
例:用两个特征(x1:房屋的面积【300-2000】;x2:卧室的数量【0-5】)来预测价钱
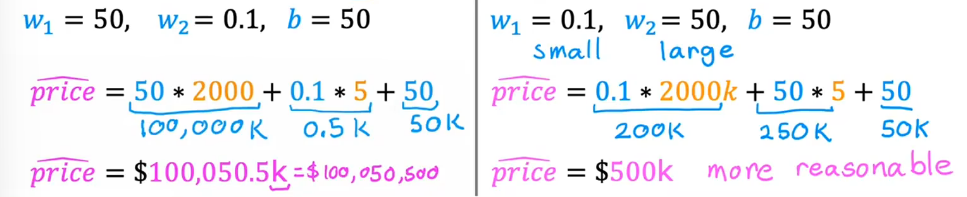
当特征值的可能取值范围较大,可能选择一个较小的参数值更好
w1的微小变化会对预测价格产生很大的影响,从而对J产生很大影响
如果直接训练梯度下降,可能会在寻找最小路径前弹跳很长时间
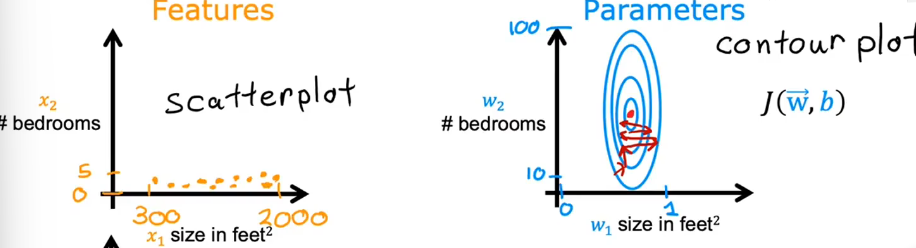
应:
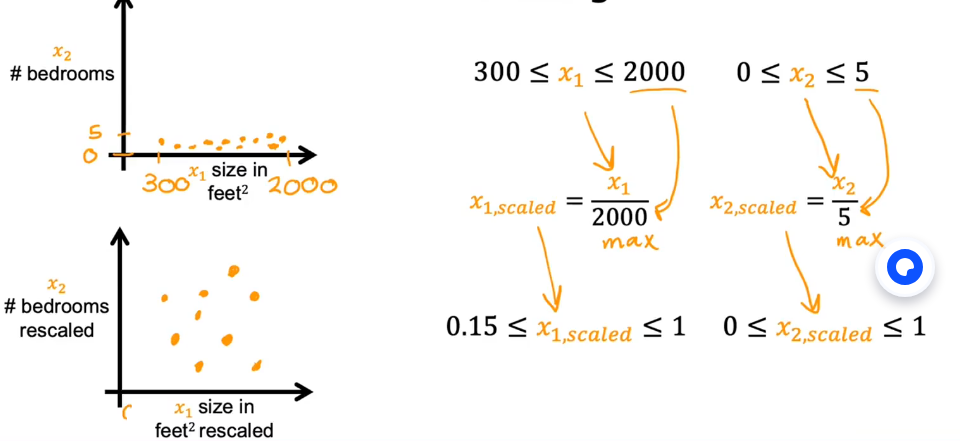
对特征进行缩放 :对u捏脸数据进行某种变换,使x1和x2现在都取值在彼此可比较的范围
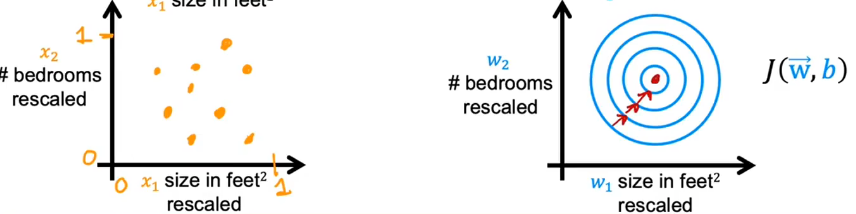
如何缩放?
1.除以最大值
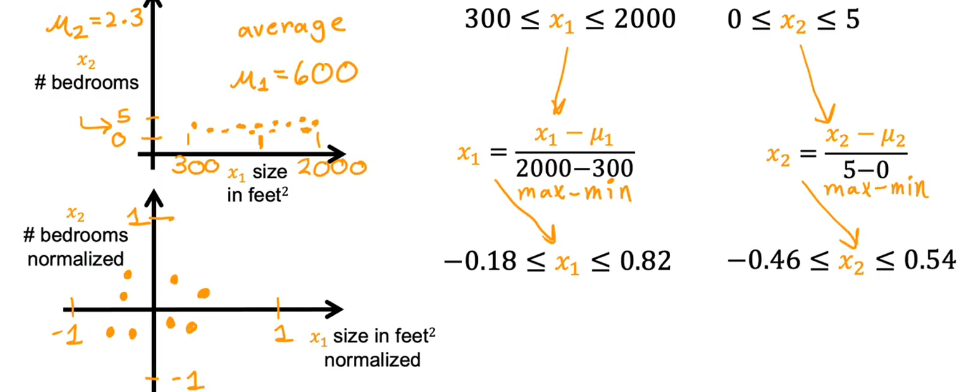
2.均值归一化
使特征都以0为中心
μ1:x1的平均值
3.Z分数归一化
计算均值μ以及每个特征的标准差σ
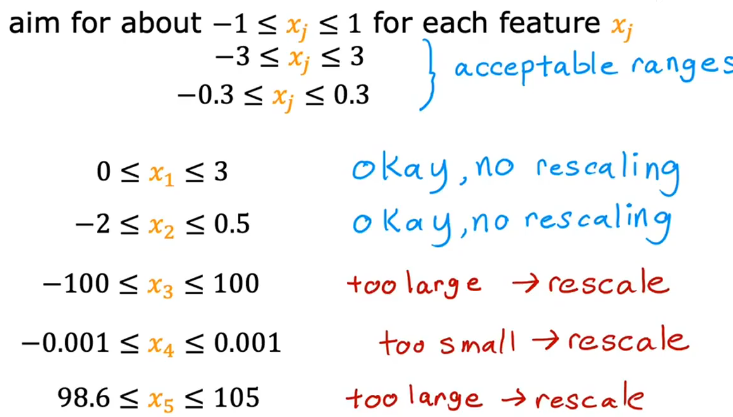
什么时候进行特征缩放?
运行梯度下降时,如何判断它在收敛?
横轴为梯度下降迭代次数,纵轴为代价J
学习曲线:
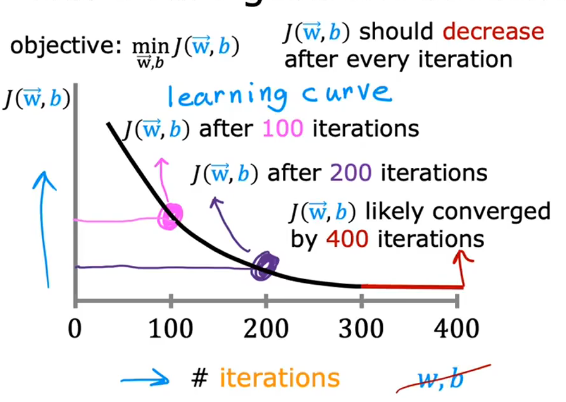
梯度下降运行正常 -> j每次迭代后都应该下降
若J在某次迭代后增加 -> α选择不当
很难提前知道梯度下降需要多少次迭代才能收敛
自动收敛测试:
ε,变量,表示一个小的数值,例如10^-3
如果成本函数j在一次迭代中减少的量小于ε,那么可能处于上图中平坦部分,意味着收敛
收敛,通常表示找到了接近J最小可能值的参数
如何为模型选一个好的学习率
如果绘制多次的迭代的代价曲线 ,发现代价时上升时下降 -> 梯度下降为正常工作 -> 代码错误/学习率太大
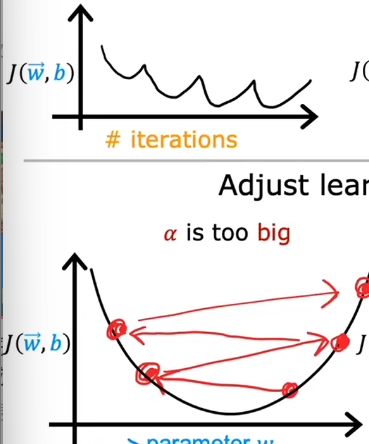
可以尝试设置α为非常小的数字,检查此时J是否上升,这个操作是为了调试步骤,并不是实际训练学习算法最有效选择,因为梯度下降需要很多次迭代才能收敛
尝试α的值:......0.001 ,0.003 , 0.01 ,0.03 , 0.1 ,0.3 ,1......
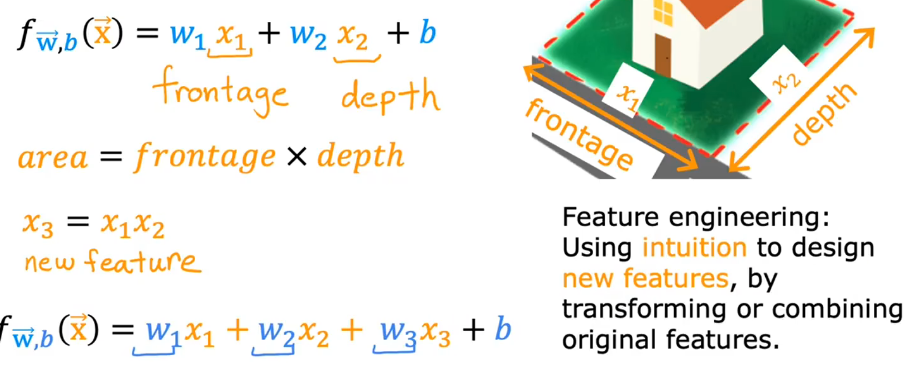
如何为为学习算法选择或设计最适合的特征
以估算房价为例:
x1:房屋所建地块的宽度
x2:地块的深度
创建一个新特征:x3:地块的面积
多项式回归
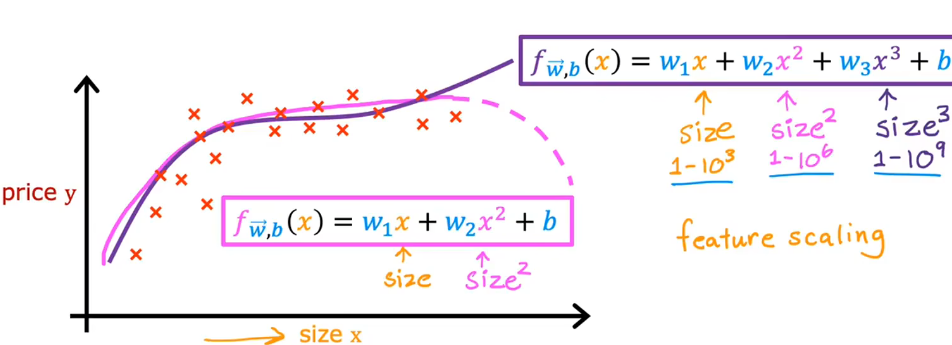
可以看出,此时拟合曲线更恰当
拟合三次函数而不是二次函数原因:最后x越大,价钱应该越高
但是此时,x,x^2, x^3取值范围相差较大
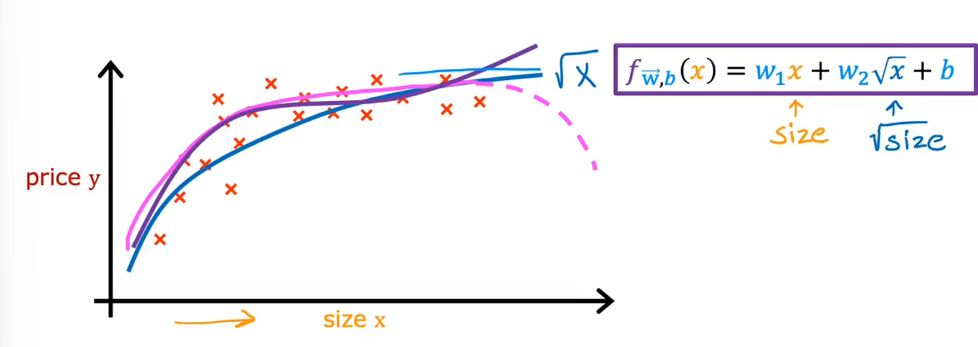
或者拟合曲线为:平方根函数
分类/类别
二元分类:只有两个可能输出的分类问题
y: 负类:否 - 假 - 0 ; 正类: 是 - 真 - 1
线性回归方法:
可以尝试选择一个阈值,如0.5
输出模型值低于0.5,预测y = 0 ; 输出模型值大于等于0.5,预测y = 1
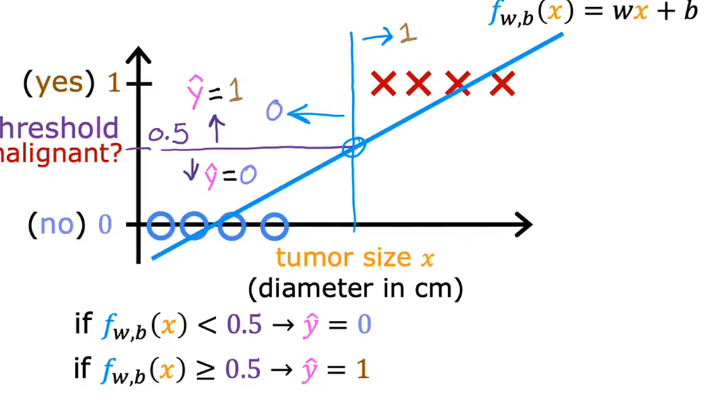
若含有一个额外的训练样本:
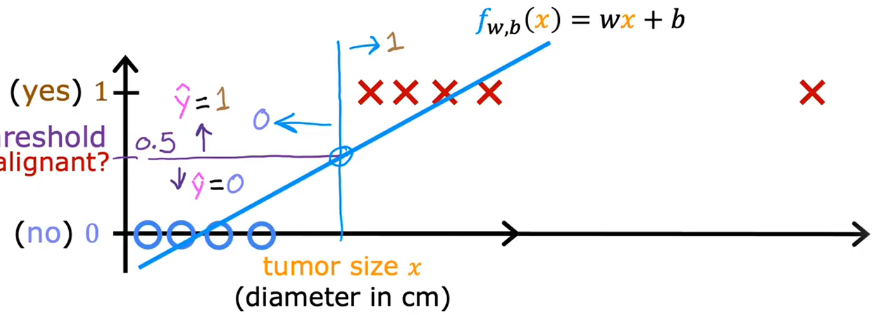
这个训练样本不应该真正改变如何分类数据点:
依然为:输出模型值低于0.5,预测y = 0 ; 输出模型值大于等于0.5,预测y = 1
但此时,函数往右偏移
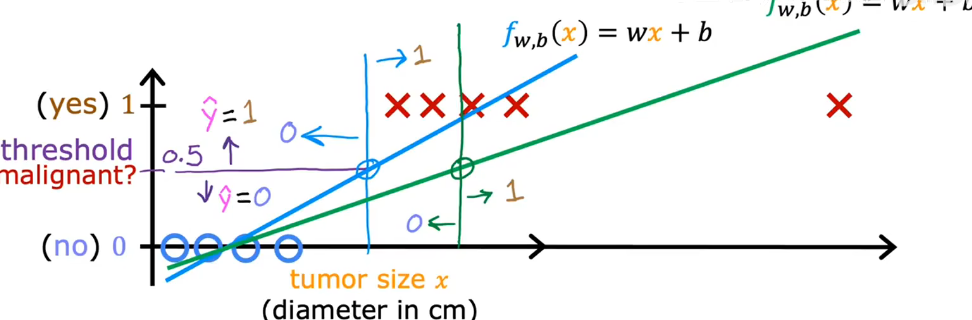
但会发现此时判断良性和恶行的分界线(决策边界),向右偏移
逻辑回归
逻辑函数:
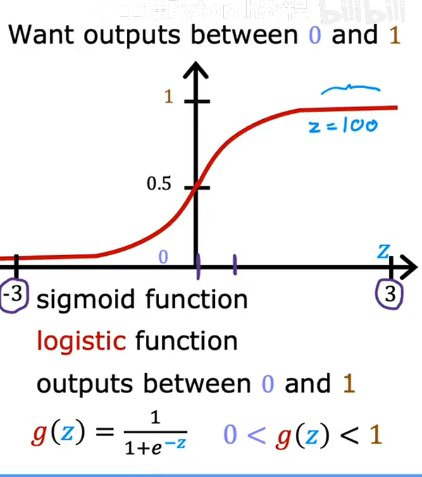
逻辑函数的构建:
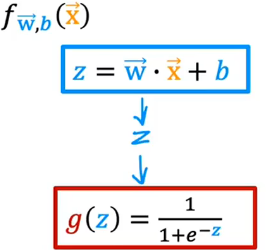
从而得到逻辑回归模型 :
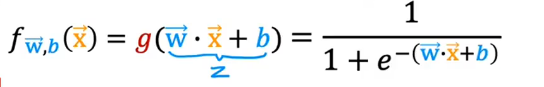
作用:输入一个特征或一组特征x,并输出一个介于0和1之间的数字
输入x输出为1的概率的表示方法:
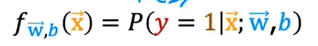
输出:
1.设置一个阈值,高与该阈值时预测y为1
2.将预测值y-hat设为1,低于该阈值时预测y-hat为0
常用阈值为0.5
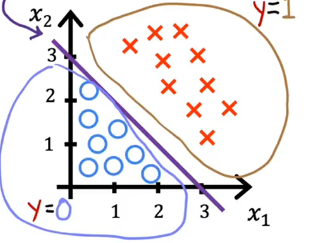
例:已知有两个特征x1,x2
红色叉号为正例,y=1
蓝色圆圈为负例,y=0
此时,
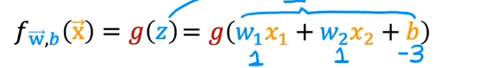
决策边界:
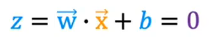
假设此时 w1=1,w2=1,b=-3
那么决策边界为x1 + x2 - 3 = 0
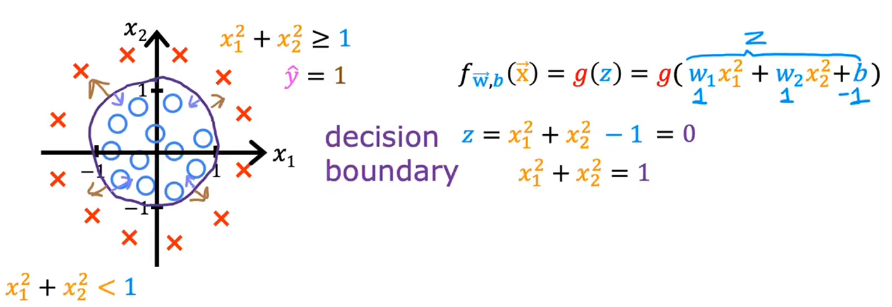
决策边界不再是直线时:
更复杂的决策边界:
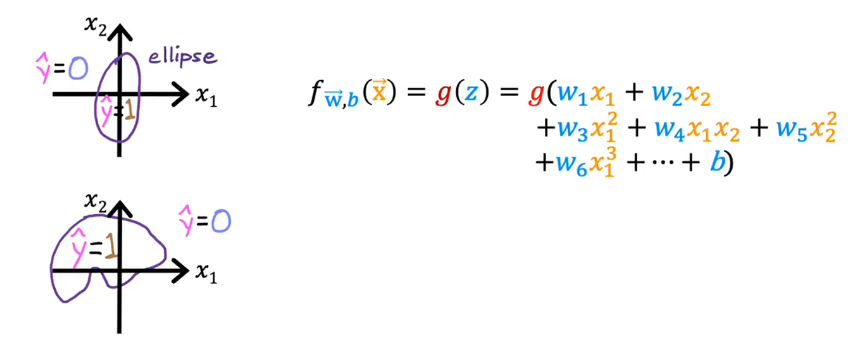
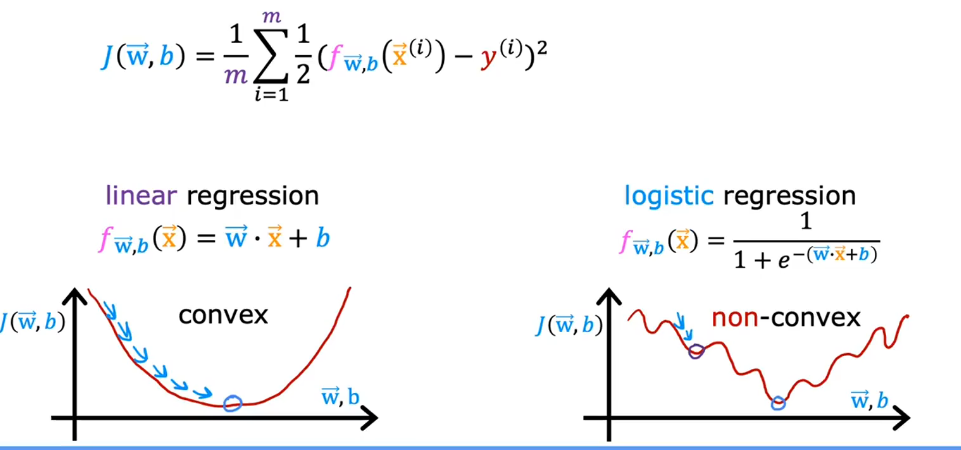
如果逻辑回归使用线性回归的平方误差代价函数:
会出现非凸代价函数 ,会有很多局部最小值
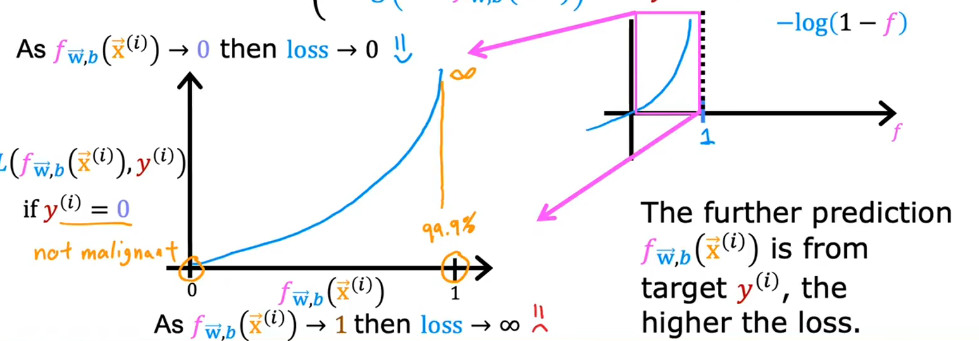
单个训练样本的损失:
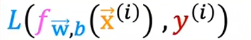
对数损失函数Loss:
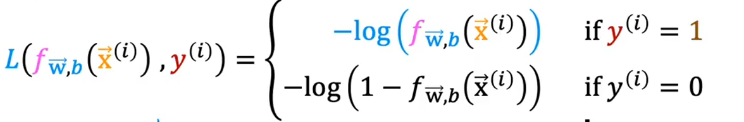
也可以写为:
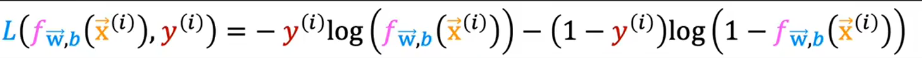
如果y^(i)=1:
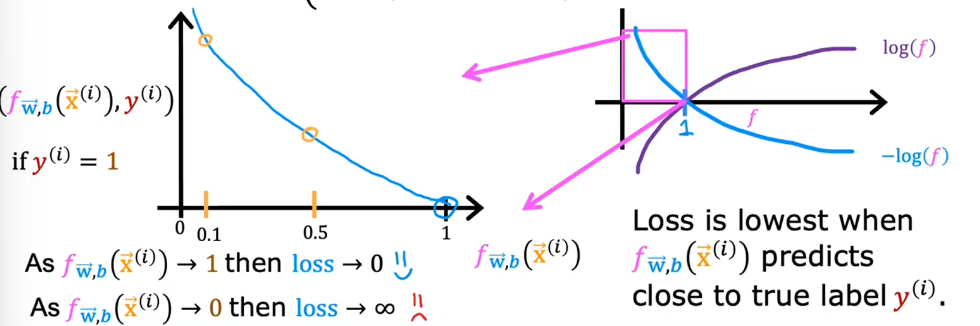
如果y^(i)=0:
代价函数:
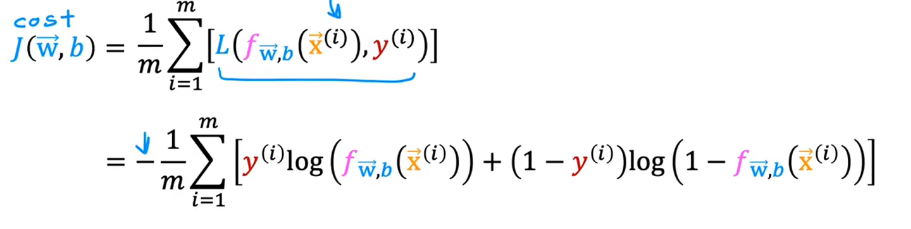
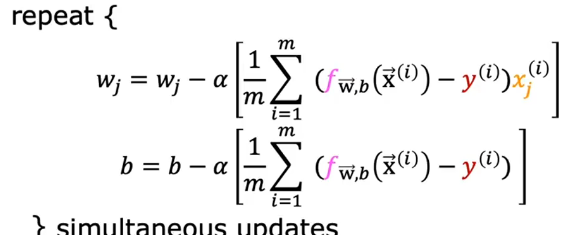
欠拟合和过拟合
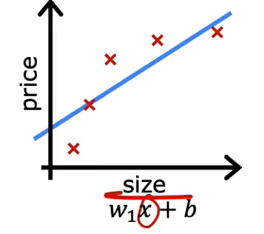
算法没有很好地拟合训练数据 -- 模型欠拟合训练数据 / 算法具有高偏差
学习算法在训练集之外的例子上也能表现良好 -- 泛化
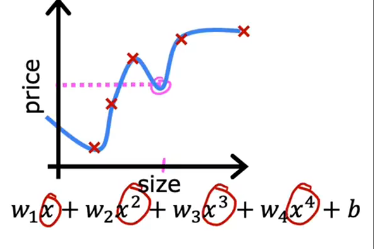
过拟合数据 / 算法有高方差:
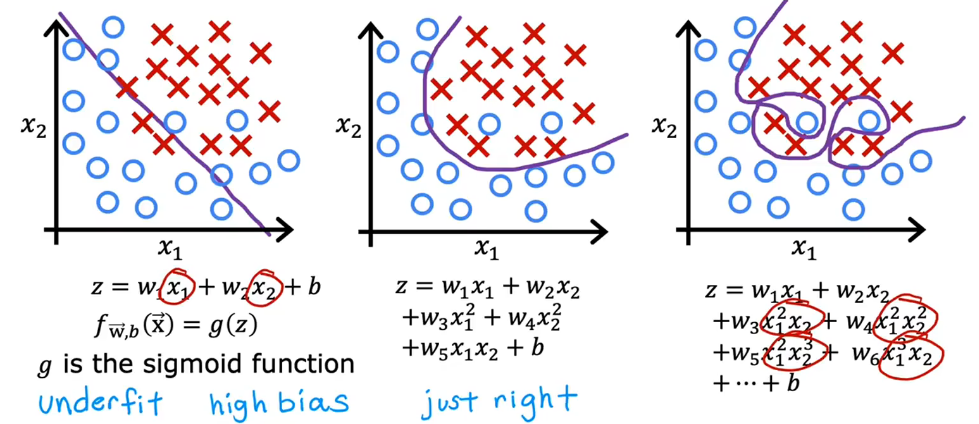
在分类中:
从左到右分别为欠拟合,拟合良好,过拟合
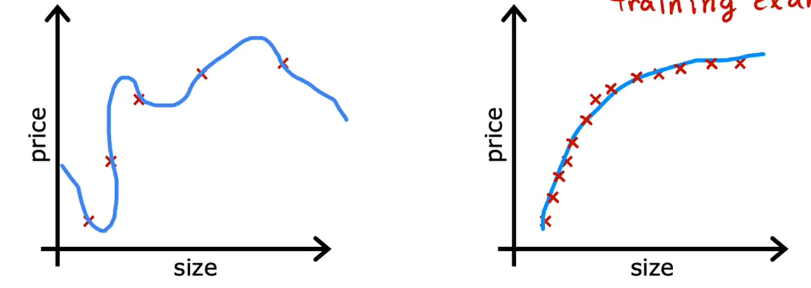
过拟合发生时,可以采取什么措施?
1.收集更多的训练数据
2.看看是否可以使用更少的特征 -- 选择最适合预测的特征集
选择最合适的特征集 -- 特征选择
特征选择缺点:通过仅使用特征的子集,算法会丢弃掉一些信息(将参数设置为0来消除一个特征)
例:也许所有的特征,实际上对预测房屋价格有用,所以也许不想通过丢弃一些特征丢弃一些信息
3.正则化
鼓励学习算法缩小参数(wj)的值(保留所有特征,但防止特征产生过大影响)
正则化线性回归
例1:
拟合数据更接近二次
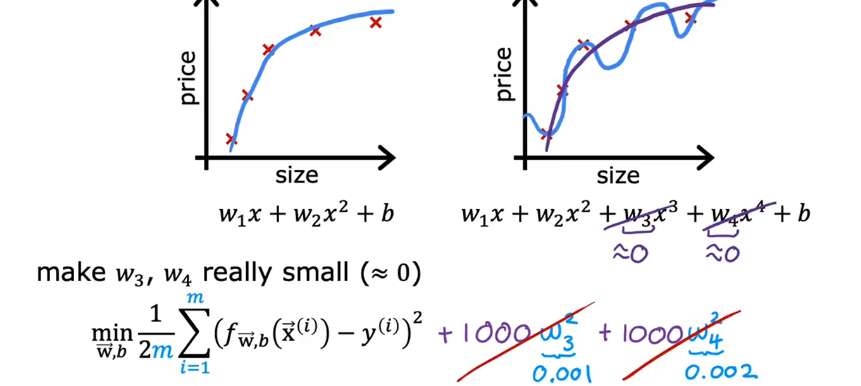
例2:
如果有很多特征,却不知道哪些是最重要的,此时,正则化的实现方式是惩罚所有特征(wj)
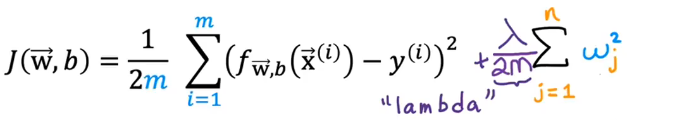
λ:正则化参数
1/2m:同前面进行缩放
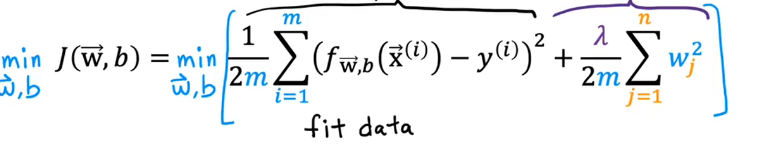
最小化第一项:鼓励算法通过最小化预测值和实际值之间的平方差来很好地拟合训练数据
最小化第二项:保持参数wj较小,以减少过拟合
λ:制定了这两个目标之间的相对重要性或相对权衡
λ = 0:无正则化,过拟合
λ很大,此时最小化J的唯一方法就是使w的所有值趋近于0,f(x)基本等于b,欠拟合
如何使梯度下降与正则化线性回归一起工作?
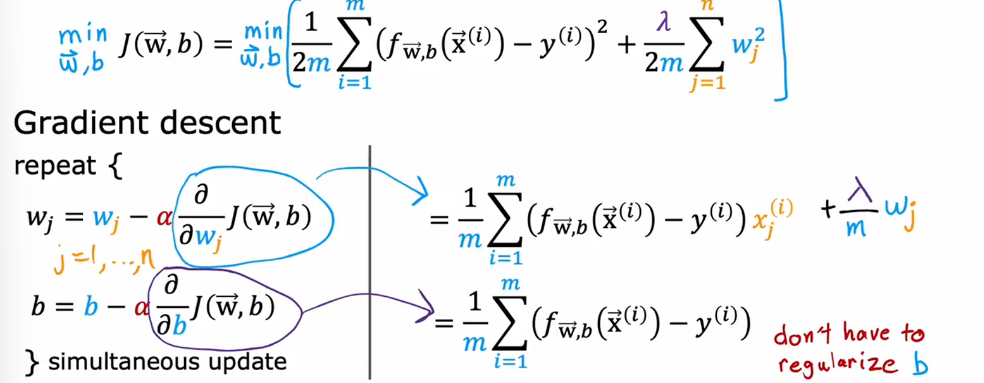
正则化线性回归的梯度下降算法:
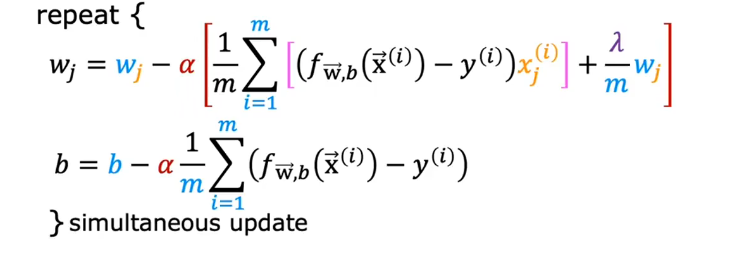
可将wj改写为:
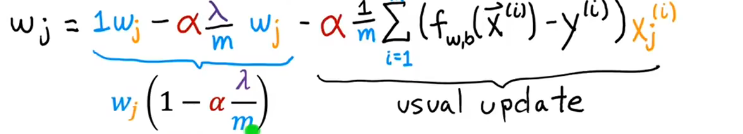
第一项:
由于α和λ都是很小的数,那么(1 - αλ/m)就是一个略小于1的数
效果:在每次下降到迭代中,稍微缩小wj的值
正则化的逻辑回归