现在很多网站对selenium机器人检测机制非常的严格,当然也包括playwright、puppeteer等同类自动化工具,但凡发现有机器操作的痕迹就会跳出来验证码,而且有些网站哪怕你是真人访问,也要做人机验证。
不过playwright、puppeteer这俩货比selenium更难被检测,也就是先进一些,因为它们更贴近浏览器的底层操作。
但要注意自动化工具要合理合法使用,得遵守网站的robot协议,做一些自动化检测、采集少量公开数据没啥问题,对网站造成干扰的事情可不能干。
再回到Python用selenium这么规避检测,这里面就涉及到太多需要做的事情了,我觉得有几下几个事情比较重要。
1、尽量不要使用无头浏览器
因为很多网站会直接识别headless模式,也就是无头模式,只有selenium这样的自动化工具才会这么干,真人只会在浏览器界面访问,所以用selenium时要打开真实浏览器界面,这样不容易被检测。
2、要模仿真人使用浏览器的行为
在selenium点击、翻页、下载等动作之间设置不定时的延迟,比如1~5秒的随机延迟,这样是为了模仿真人行为的不规律性。
3、调整浏览器指纹
浏览器指纹包括像User-Agent、屏幕分辨率等,可以使用多个真实的User-Agent随机轮换访问,设置浏览器界面为常见分辨率等。
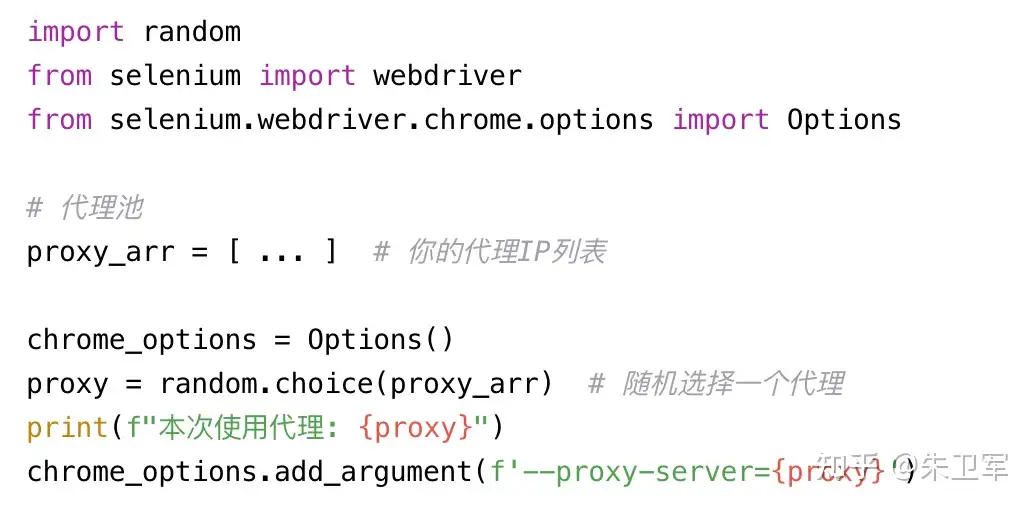
4、可以设置代理IP池
同一个IP访问频率和时间过长,也会被检测,所以需要找一些质量好点的IP池,可以切换访问。
python selenium可以通过options模块专门设置代理,可以随机切换,设置不定时的延迟,这样就不容易被封掉。
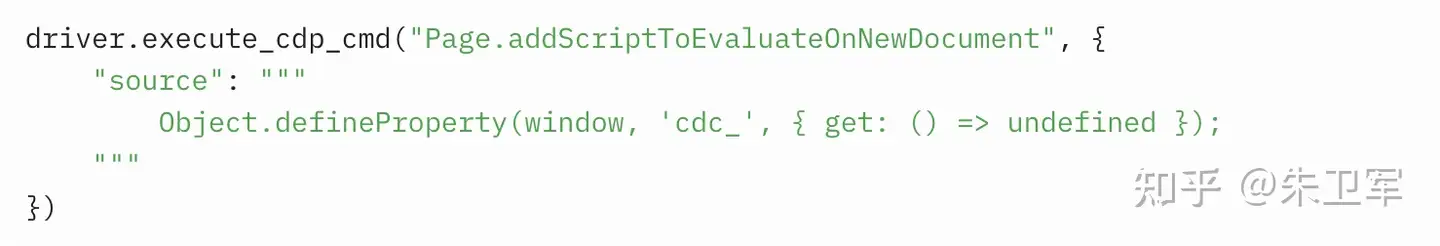
5、修改execute_cdp_cmd文件,隐藏selenium痕迹
selenium会默认在DOM中加入selenium标记脚本,这比较容易被识别出来,可以修改execute_cdp_cmd文件。
6、可以尝试用亮数据的采集api
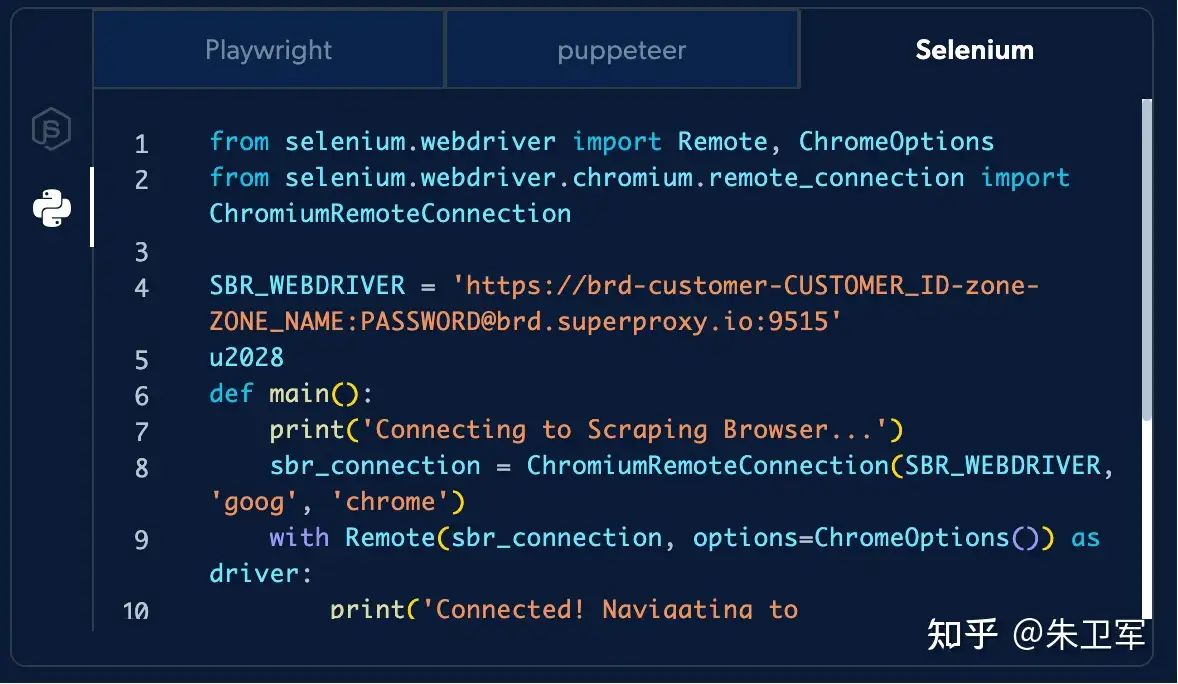
如果是技术小白,不会写上面提到的那些规避措施代码,就可以尝试用亮数据的这样的采集api,它把各种规避检测的技术、IP代理池都封装到一个接口里,还提供专门的云上浏览器,用selenium接入,和普通浏览器一样,有头无头都支持,但不需要再写各种反爬措施之类的脚本,比较简单直接。
https://get.brightdata.com/webscra
总的来说,selenium规避检测有很多措施,但现在检测技术也越来越先进,魔高一尺道高一丈的博弈,注意合理合法的使用就行。