【GPT入门】第67课 多模态模型实践: 本地部署文生视频模型和图片推理模型
- [1. 文生视频模型CogVideoX-5b 本地部署](#1. 文生视频模型CogVideoX-5b 本地部署)
-
- [1.1 模型介绍](#1.1 模型介绍)
- [1.2 环境安装](#1.2 环境安装)
- [1.3 模型下载](#1.3 模型下载)
- [1.4 测试](#1.4 测试)
- [2.ollama部署图片推理模型 llama3.2-vision](#2.ollama部署图片推理模型 llama3.2-vision)
-
- [2.1 模型介绍](#2.1 模型介绍)
- [2.2 安装ollama](#2.2 安装ollama)
- [2.3 下载模型](#2.3 下载模型)
- [2.4 测试模型](#2.4 测试模型)
- [2.5 测试](#2.5 测试)
1. 文生视频模型CogVideoX-5b 本地部署
https://www.modelscope.cn/models/ZhipuAI/CogVideoX-5b/summary
1.1 模型介绍
https://www.modelscope.cn/models/ZhipuAI/CogVideoX-5b/summary
1.2 环境安装
下载 安装conda
wget https://repo.anaconda.com/miniconda/Miniconda3-latest-Linux-x86_64.sh
conda create --prefix /root/autodl-tmp/xxzhenv/video python=3.10 -y
或
conda create --name video python=3.10
pip install --upgrade transformers accelerate diffusers imageio-ffmpeg 1.3 模型下载
modelscope download --model ZhipuAI/CogVideoX-5b --local_dir /root/autodl-tmp/models_xxzh/ZhipuAI/CogVideoX-5b 1.4 测试
跑
import torch
from modelscope import CogVideoXPipeline
from diffusers.utils import export_to_video

prompt = "A panda, dressed in a small, red jacket and a tiny hat, sits on a wooden stool in a serene bamboo forest. The panda's fluffy paws strum a miniature acoustic guitar, producing soft, melodic tunes. Nearby, a few other pandas gather, watching curiously and some clapping in rhythm. Sunlight filters through the tall bamboo, casting a gentle glow on the scene. The panda's face is expressive, showing concentration and joy as it plays. The background includes a small, flowing stream and vibrant green foliage, enhancing the peaceful and magical atmosphere of this unique musical performance."

pipe = CogVideoXPipeline.from_pretrained(
    "/root/autodl-tmp/models_xxzh/ZhipuAI/CogVideoX-5b",
    torch_dtype=torch.bfloat16
)

pipe.enable_sequential_cpu_offload()
pipe.vae.enable_tiling()
pipe.vae.enable_slicing()

video = pipe(
    prompt=prompt,
    num_videos_per_prompt=1,
    num_inference_steps=50,
    num_frames=49,
    guidance_scale=6,
    generator=torch.Generator(device="cuda").manual_seed(42),
).frames[0]

export_to_video(video, "output.mp4", fps=8)
2.ollama部署图片推理模型 llama3.2-vision
2.1 模型介绍
官网: https://ollama.com/library/llama3.2-vision
Llama 3.2-Vision 多模态大型语言模型(LLM)系列,是包含 110 亿参数和 900 亿参数两种规模的指令微调型图像推理生成模型集合,支持 "输入文本 + 图像 / 输出文本" 的交互模式。
经过指令微调的 Llama 3.2-Vision 模型,在视觉识别、图像推理、图像描述生成,以及回答与图像相关的通用问题等任务上进行了优化。在行业常用基准测试中,该系列模型的性能优于多款已有的开源及闭源多模态模型。
支持语言
- 纯文本任务:官方支持英语、德语、法语、意大利语、葡萄牙语、印地语、西班牙语和泰语共 8 种语言。此外,Llama 3.2 的训练数据涵盖了比这 8 种官方支持语言更广泛的语种范围。
- 图像 + 文本任务:需注意,目前仅支持英语。
2.2 安装ollama
curl -fsSL https://ollama.com/install.sh | sh
2.3 下载模型
ollama pull llama3.2-vision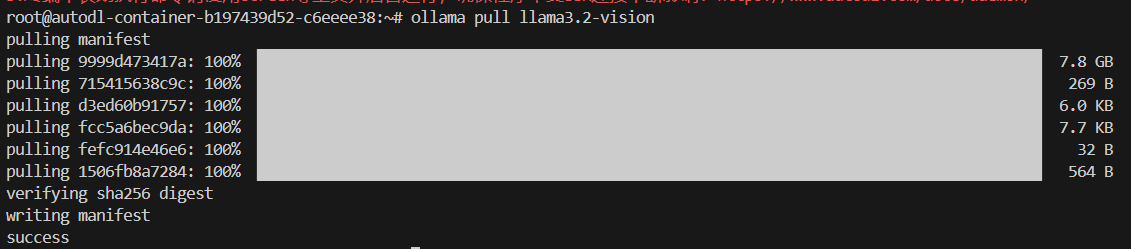
2.4 测试模型
conda create --prefix /root/autodl-tmp/xxzhenv/ollama python=3.10 -y
conda activate ollama
pip install ollama
2.5 测试
放一个图片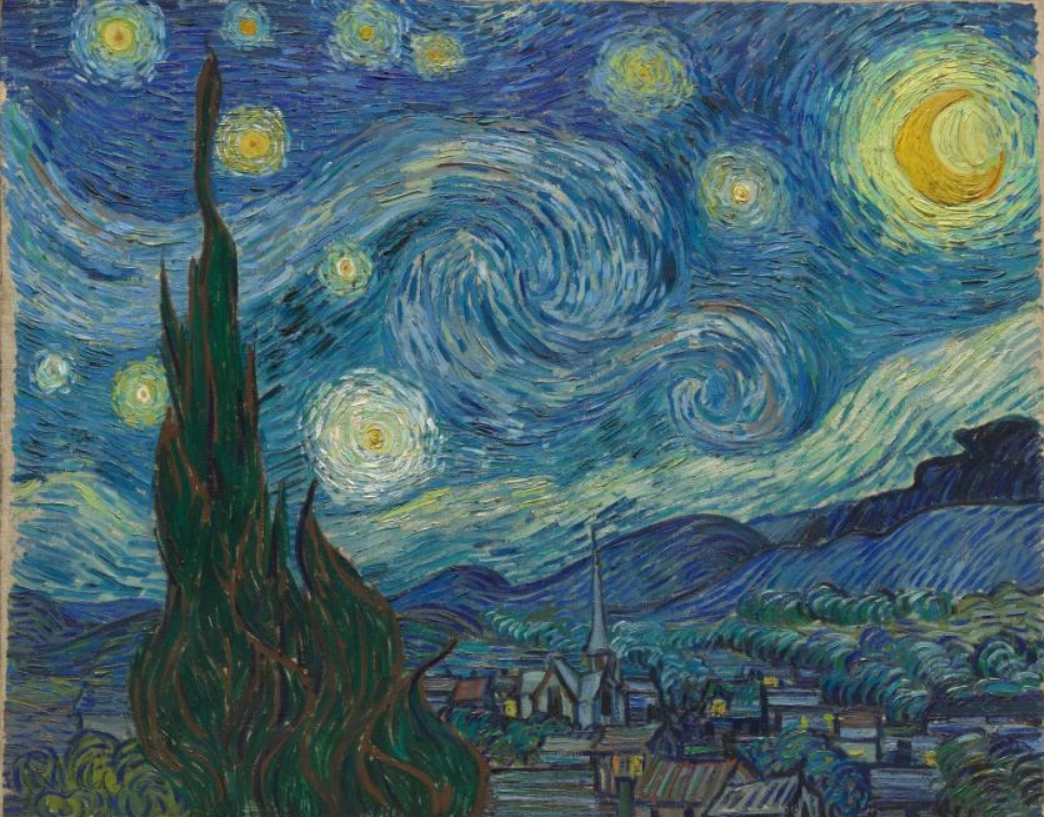
import ollama

response = ollama.chat(
    model='llama3.2-vision',
    messages=[{
        'role': 'user',
        'content': 'What is in this image?',
        'images': ['image.jpeg']
    }]
)

print(response)
回复:
(/root/autodl-tmp/xxzhenv/ollama) root@autodl-container-b197439d52-c6eeee38:~/autodl-tmp/xxzh# python test01.py
model='llama3.2-vision' created_at='2025-09-12T07:40:47.282497498Z' done=True done_reason='stop' total_duration=9314004386 load_duration=6304258184 prompt_eval_count=16 prompt_eval_duration=1965372891 eval_count=74 eval_duration=1036467359 message=Message(role='assistant', content='The image is a painting of a starry night sky with a village below, featuring a large cypress tree and a bright crescent moon. The painting is called "The Starry Night" and was created by Vincent van Gogh in 1889. It is one of his most famous works and is widely considered a masterpiece of Post-Impressionism.', thinking=None, images=None, tool_name=None, tool_calls=None)