一、RDD五大核心属性
| 属性 | 技术实现 | 设计意义 |
|---|---|---|
| 1. 分区(Partitions) | 分片列表 | 定义并行计算粒度,每个分区对应一个Task |
| 2. 计算函数(Compute) | compute(Partition, TaskContext): Iterator[T] 方法 |
封装分区计算逻辑,与迭代器复合避免中间结果存储 |
| 3. 依赖关系(Dependencies) | 窄依赖(OneToOne/Range) 和 宽依赖(Shuffle) | 容错与Stage划分依据,窄依赖允许流水线执行 |
| 4. 分区器(Partitioner) | HashPartitioner/RangePartitioner (仅Key-Value RDD) | 决定Shuffle数据分布和分区策略 |
| 5. 优先位置(Preferred Locations) | 返回分区数据所在节点列表 | 遵循"移动计算而非数据"原则,减少网络传输 |
二、实现类
| 实现类 | 依赖类型 | 关键特征 |
|---|---|---|
| MapPartitionsRDD | 窄依赖 | 封装map/filter等操作,compute调用父分区迭代器转换 |
| ShuffledRDD | 宽依赖 | reduceByKey等操作的底层实现,依赖ShuffleManager读写数据 |
| ReliableCheckpointRDD | 无依赖 | 从HDFS读取检查点数据,dependencies_=空 |
| UnionRDD | 窄依赖 | 合并多个父RDD分区,不改变原始数据分布 |
三、核心设计
1、不支持RDD嵌套
scala
if (classOf[RDD[_]].isAssignableFrom(elementClassTag.runtimeClass)) {
    // This is a warning instead of an exception in order to avoid breaking user programs that
    // might have defined nested RDDs without running jobs with them.
    logWarning("Spark does not support nested RDDs (see SPARK-5063)")
  }
2、RDD Functions 隐式转换
scala
implicit def rddToPairRDDFunctions[K, V](rdd: RDD[(K, V)])
    (implicit kt: ClassTag[K], vt: ClassTag[V], ord: Ordering[K] = null): PairRDDFunctions[K, V] = {
    new PairRDDFunctions(rdd)
  }

  implicit def rddToAsyncRDDActions[T: ClassTag](rdd: RDD[T]): AsyncRDDActions[T] = {
    new AsyncRDDActions(rdd)
  }

  implicit def rddToSequenceFileRDDFunctions[K, V](rdd: RDD[(K, V)])
      (implicit kt: ClassTag[K], vt: ClassTag[V],
                keyWritableFactory: WritableFactory[K],
                valueWritableFactory: WritableFactory[V])
    : SequenceFileRDDFunctions[K, V] = {
    implicit val keyConverter = keyWritableFactory.convert
    implicit val valueConverter = valueWritableFactory.convert
    new SequenceFileRDDFunctions(rdd,
      keyWritableFactory.writableClass(kt), valueWritableFactory.writableClass(vt))
  }

  implicit def rddToOrderedRDDFunctions[K : Ordering : ClassTag, V: ClassTag](rdd: RDD[(K, V)])
    : OrderedRDDFunctions[K, V, (K, V)] = {
    new OrderedRDDFunctions[K, V, (K, V)](rdd)
  }

  implicit def doubleRDDToDoubleRDDFunctions(rdd: RDD[Double]): DoubleRDDFunctions = {
    new DoubleRDDFunctions(rdd)
  }

  implicit def numericRDDToDoubleRDDFunctions[T](rdd: RDD[T])(implicit num: Numeric[T])
    : DoubleRDDFunctions = {
    new DoubleRDDFunctions(rdd.map(x => num.toDouble(x)))
  }
3、RDD、DataSet、DataFrame
| 特性维度 | RDD | DataFrame | Dataset |
|---|---|---|---|
| 数据类型 | 任意对象 | 结构化数据(Row对象) | 强类型对象(Case类) |
| 序列化 | Java/Kryo序列化 | Tungsten二进制格式 | Tungsten编码器 |
| 优化能力 | 无 | Catalyst优化器 | Catalyst优化器 |
| 类型安全 | 编译时类型安全 | 运行时类型检查 | 编译时类型安全 |
| API风格 | 函数式编程 | SQL类似操作 | 函数式+SQL操作 |
| 性能 | 较低 | 高 | 较高 |
1、RDD转换
- 逻辑计划生成:解析操作依赖关系,构建抽象语法树(AST)
- 物理计划优化(Catalyst引擎) :
- 应用启发式规则进行逻辑优化(如谓词下推、常量折叠)
- 生成可执行计划
- Tungsten引擎优化 :
- 堆外内存管理:绕过JVM堆内存限制,减少GC暂停时间
- 缓存感知计算:优化数据布局(列式存储),提高CPU缓存命中率
- 全阶段代码生成:将查询编译为单个函数,消除虚拟函数调用
2、DataFrame
ColumnVector 表示 Spark 中内存中列式数据的接口。
ColumnarBatch 此类将多个 ColumnVectors 包装为按行表,提供行视图
3、Dataset
ExpressionEncoder 对象 → UnsafeRow
连续内存访问
与传统Java对象存储相比的节省效果
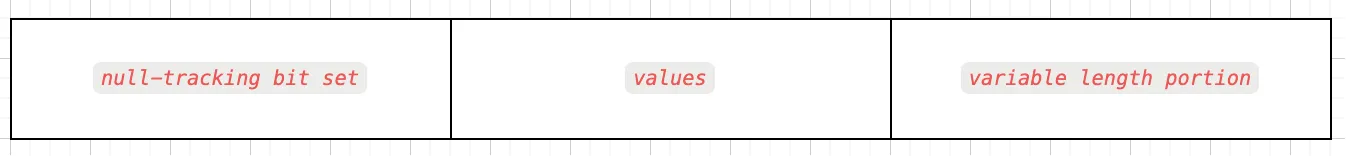
*null-tracking bit set*:用来表示那些字段是 null 值,一个字段占用 1bit,总大小用 bitSetWidthInBytes 表示:大小=((字段数 + 63)/ 64) * 8;
*values*: 在该区域,每个字段固定会占用 8 个字节,对于持有固定长度的字段基本类型(如long、double或int)直接将值存储在字中。为字段变长值,则存储相对偏移量指向变长字段开头的行(基址baseObject)和长度size
*variable length portion* 处理字符串等可变长度数据