点一下关注吧!!!非常感谢!!持续更新!!!
🚀 AI篇持续更新中!(长期更新)
AI炼丹日志-31- 千呼万唤始出来 GPT-5 发布!"快的模型 + 深度思考模型 + 实时路由",持续打造实用AI工具指南!📐🤖
💻 Java篇正式开启!(300篇)
目前2025年09月15日更新到: Java-124 深入浅出 MySQL Seata框架详解:分布式事务的四种模式与核心架构 MyBatis 已完结,Spring 已完结,Nginx已完结,Tomcat已完结,分布式服务正在更新!深入浅出助你打牢基础!
📊 大数据板块已完成多项干货更新(300篇):
包括 Hadoop、Hive、Kafka、Flink、ClickHouse、Elasticsearch 等二十余项核心组件,覆盖离线+实时数仓全栈! 大数据-278 Spark MLib - 基础介绍 机器学习算法 梯度提升树 GBDT案例 详解
章节内容
上节我们完成了如下的内容:
- Spark Streaming DStream 转换函数
- DStream 无状态转换
- DStream 无状态转换 案例
转换方式
有两个类型:
- 无状态转换(已经完成)
- 有状态转换
接下来开始有状态转换。
有状态转换
有状态转换主要有两种:
- 窗口操作
- 状态跟踪操作
窗口操作
Window Operations 可以设置窗口大小和滑动窗口间隔来动态获取当前Streaming的状态 基于窗口的操作会在一个比 StreamingContext 的 batchDuration(批次间隔)更长的时间范围内,通过整合多个批次的结果,计算出整个窗口的结果。
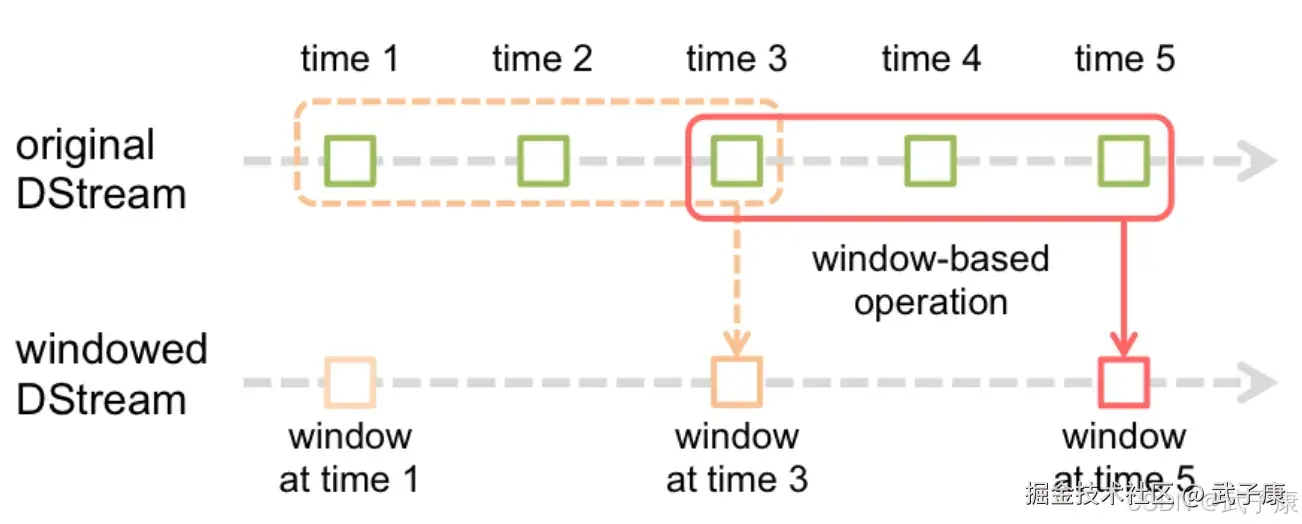
基于窗口的操作需要两个参数:
- 窗口长度(Window Duration):控制每次计算最近的多少个批次的数据
- 滑动间隔(Slide Duration):用来控制对新的 DStream 进行计算的间隔
两者都必须是StreamingContext中批次间隔(batchDuration)的整数倍
准备编码
我们先编写一个每秒发送一个数字:
scala
package icu.wzk

import java.io.PrintWriter
import java.net.{ServerSocket, Socket}

object SocketWithWindow {

  def main(args: Array[String]): Unit = {
    val port = 9999
    val ss = new ServerSocket(port)
    val socket: Socket = ss.accept()
    var i = 0
    while (true) {
      i += 1
      val out = new PrintWriter(socket.getOutputStream)
      out.println(i)
      out.flush()
      Thread.sleep(1000)
    }
  }
}
窗口操作 案例2观察窗口数据
- 观察窗口的数据
- 观察 batchDuration、windowDuration、slideDuration 三者之间的关系
- 使用窗口相关的操作
编写代码
scala
package icu.wzk
object WindowDemo {

  def main(args: Array[String]): Unit = {
    val conf = new SparkConf()
      .setAppName("WindowDemo")
      .setMaster("local[*]")

    val ssc = new StreamingContext(conf, Seconds(5))
    ssc.sparkContext.setLogLevel("WARN")

    val lines: ReceiverInputDStream[String] = ssc.socketTextStream("localhost", 9999)
    lines.foreachRDD {
      (rdd, time) => {
        println(s"rdd = ${rdd.id}; time = $time")
      }
        rdd.foreach(value => println(value))
    }

    // 20秒窗口长度(DS包含窗口长度范围内的数据)
    // 10秒滑动间隔(多次时间处理一次数据)
    val res1: DStream[String] = lines
      .reduceByWindow(_ + " " + _, Seconds(20), Seconds(10))
    res1.print()

    val res2: DStream[String] = lines
      .reduceByWindow(_ + _, Seconds(20), Seconds(10))
    res2.print()

    // 求窗口元素的和
    val res3: DStream[Int] = lines
      .map(_.toInt)
      .reduceByWindow(_ + _, Seconds(20), Seconds(10))
    res3.print()

    // 请窗口元素和
    val res4 = res2.map(_.toInt).reduce(_ + _)
    res4.print()

    // 程序启动
    ssc.start()
    ssc.awaitTermination()

  }
}
运行结果
shell
-------------------------------------------
Time: 1721628860000 ms
-------------------------------------------

rdd = 39; time = 1721628865000 ms
rdd = 40; time = 1721628870000 ms
-------------------------------------------
Time: 1721628870000 ms
-------------------------------------------

-------------------------------------------
Time: 1721628870000 ms
-------------------------------------------

-------------------------------------------
Time: 1721628870000 ms
-------------------------------------------
运行之后控制截图如下: 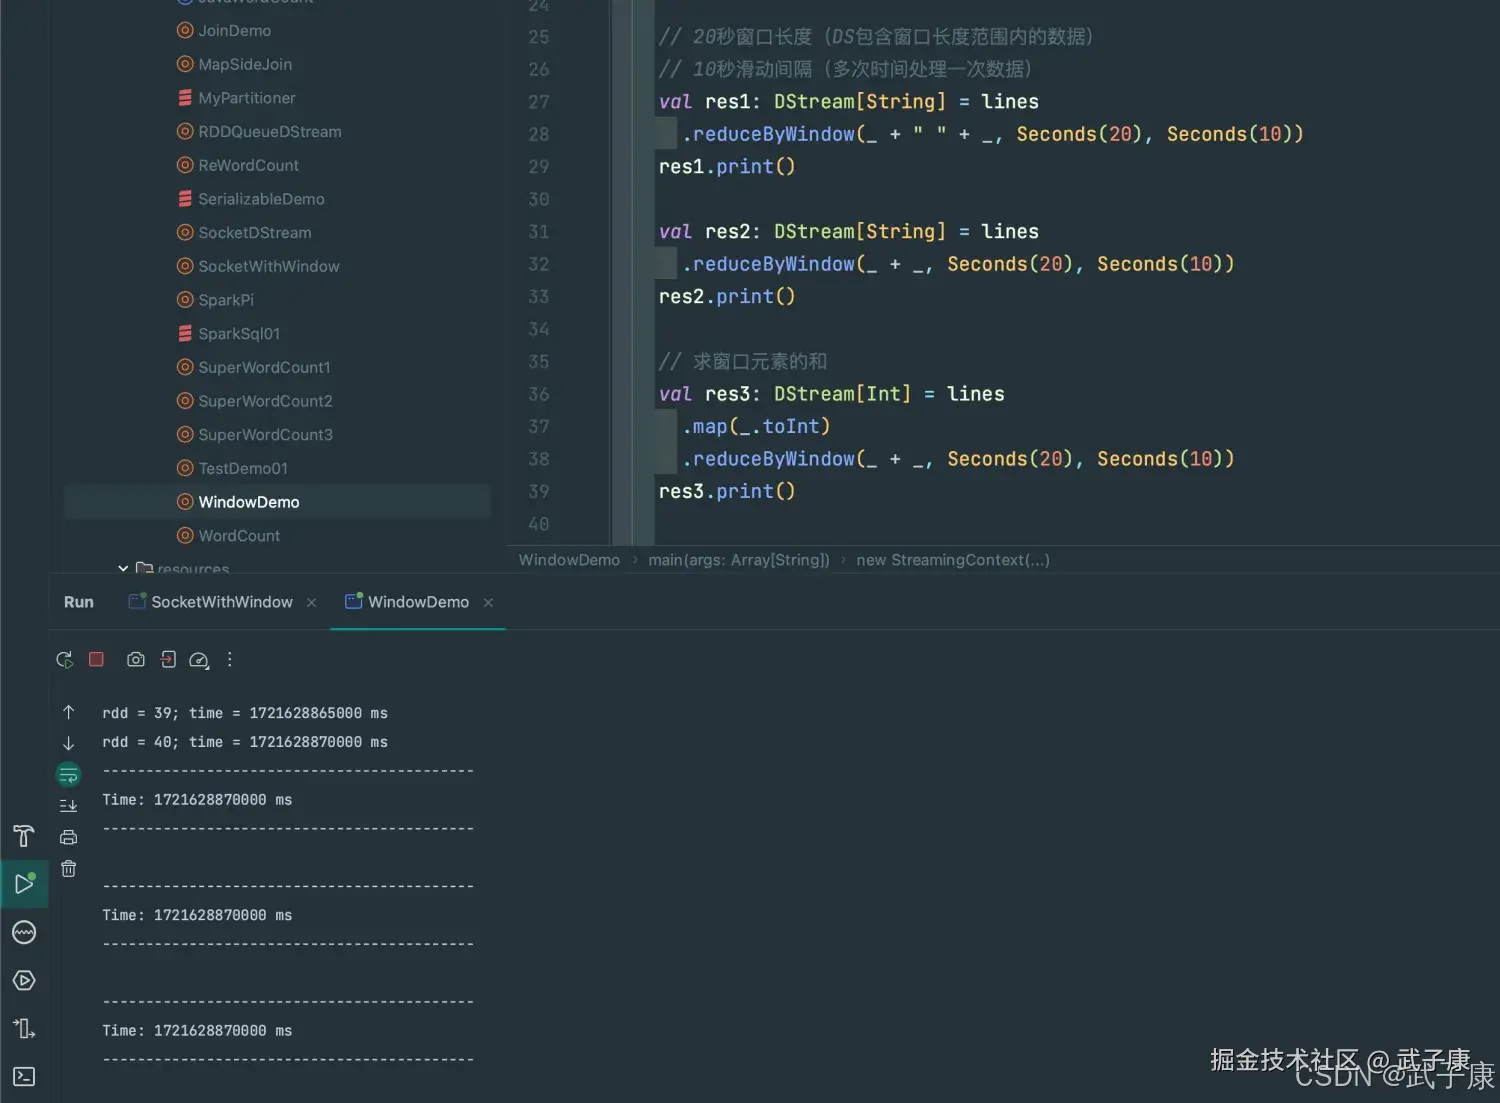
窗口操作 案例3 热点搜索词实时统计
编写代码
scala
package icu.wzk
object HotWordStats {

  def main(args: Array[String]): Unit = {
    val conf = new SparkConf()
      .setAppName("HotWordStats")
      .setMaster("local[*]")

    val ssc = new StreamingContext(conf, Seconds(2))
    // 检查点设置 也可以设置到 HDFS
    ssc.sparkContext.setLogLevel("ERROR")
    ssc.checkpoint("checkpoint")

    val lines: ReceiverInputDStream[String] = ssc.socketTextStream("localhost", 9999)
    val words: DStream[String] = lines.flatMap(_.split("\\s+"))
    val pairs: DStream[(String, Int)] = words.map(x => (x, 1))

    // 通过 reduceByKeyAndWindow算子 每隔10秒统计最近20秒的词出现的的次数
    val wordCounts1: DStream[(String, Int)] = pairs
      .reduceByKeyAndWindow(
        (a: Int, b: Int) => a + b, Seconds(20), Seconds(10), 2
      )
    wordCounts1.print()

    // 需要CheckPoint的支持
    val wordCounts2: DStream[(String, Int)] = pairs
      .reduceByKeyAndWindow(
        _ + _, _ - _, Seconds(20), Seconds(10), 2
      )
    wordCounts2.print()

    // 运行程序
    ssc.start()
    ssc.awaitTermination()
  }

}
运行结果
shell
-------------------------------------------
Time: 1721629842000 ms
-------------------------------------------
(4,1)
(8,1)
(6,1)
(2,1)
(7,1)
(5,1)
(3,1)
(1,1)

-------------------------------------------
Time: 1721629842000 ms
--------------------
运行结果如下图: 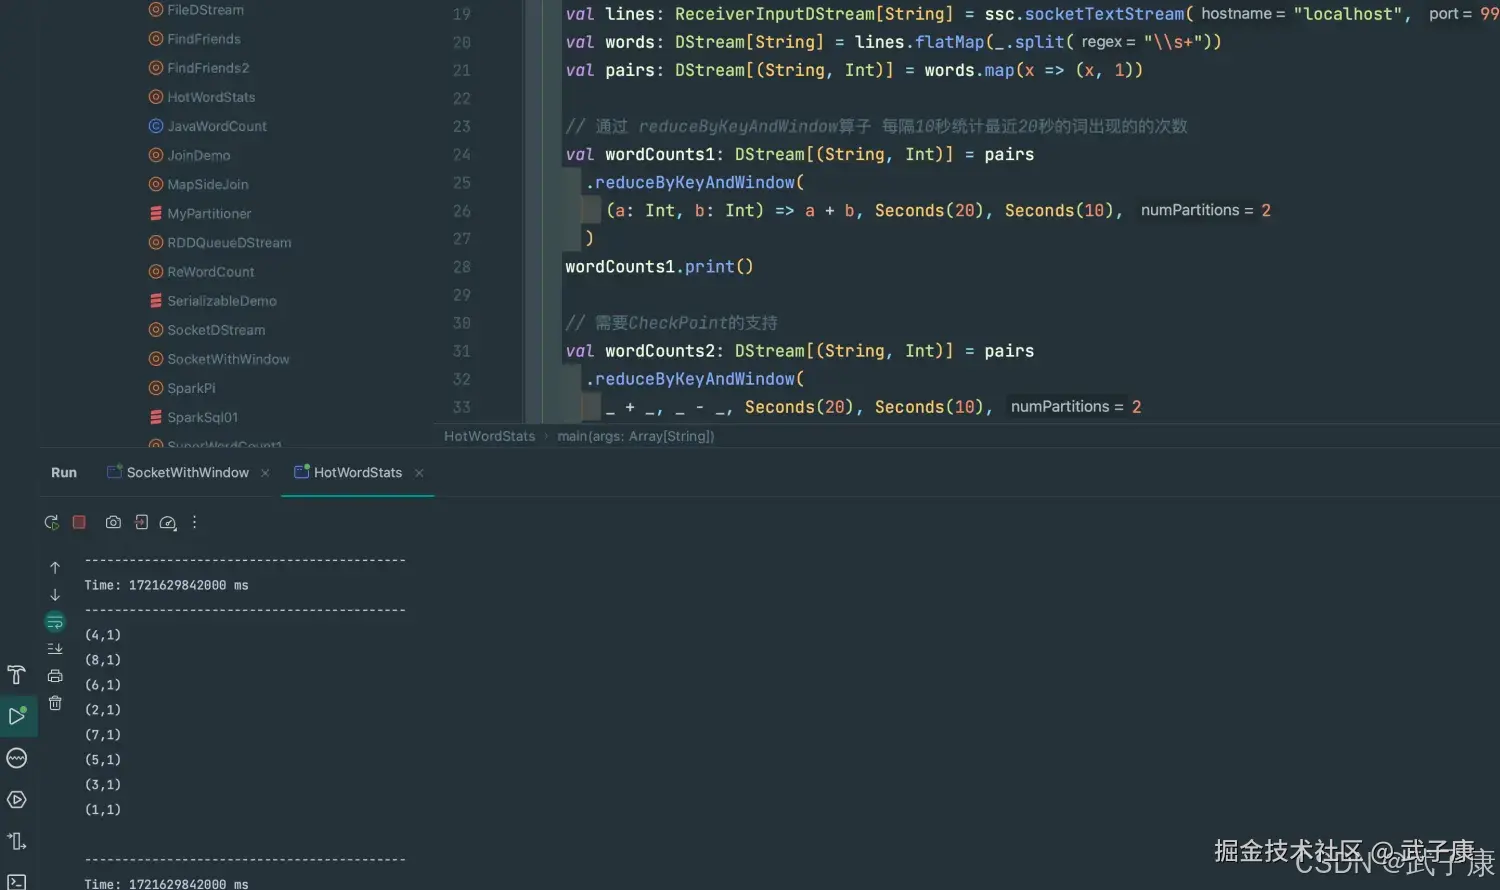
状态追踪操作 updateStateByKey
UpdateStateByKey的主要功能:
- 为Streaming中每一个Key维护一份State状态,state类型可以是任意类型的,可以是自定义对象,更新函数也可以是自定义的
- 通过更新函数对该Key的状态不断更新,对于每个新的batch而言,Spark Streaming会在使用updateStateByKey的时候已经存在的key进行state状态更新
- 使用updateStateByKey时要开启 CheckPoint 功能
编写代码1
流式程序启动后计算wordcount的累计值,将每个批次的结果保存到文件
scala
package icu.wzk
object StateTracker1 {

  def main(args: Array[String]): Unit = {
    val conf = new SparkConf()
      .setAppName("StateTracker1")
      .setMaster("local[*]")
    val ssc = new StreamingContext(conf, Seconds(5))
    ssc.sparkContext.setLogLevel("ERROR")
    ssc.checkpoint("checkpoint")

    val lines: ReceiverInputDStream[String] = ssc.socketTextStream("localhost", 9999)
    val words: DStream[String] = lines.flatMap(_.split("\\s+"))
    val wordDStream: DStream[(String, Int)] = words.map(x => (x, 1))

    // 定义状态更新函数
    // 函数常量定义 返回类型是 Some(Int),表示的含义是最新状态
    // 函数的功能是将当前时间间隔内产生的Key的Value集合,加到上一个状态中,得到最新状态
    val updateFunc = (currValues: Seq[Int], prevValueState: Option[Int]) => {
      // 通过Spark内部的reduceByKey按Key规约,然后这里传入某Key当前批次的Seq,再计算当前批次的总和
      val currentCount = currValues.sum
      // 已累加的值
      val previousCount = prevValueState.getOrElse(0)
      Some(currentCount + previousCount)
    }

    val stateDStream: DStream[(String, Int)] = wordDStream.updateStateByKey[Int](updateFunc)
    stateDStream.print()

    // 把DStream保存到文本文件中 会生成很多的小文件 一个批次生成一个目录
    val outputDir = "output1"
    stateDStream
      .repartition(1)
      .saveAsTextFiles(outputDir)

    // 开始运行
    ssc.start()
    ssc.awaitTermination()
  }
}
运行结果1
shell
-------------------------------------------
Time: 1721631080000 ms
-------------------------------------------
(1,1)
(2,1)
(3,1)

-------------------------------------------
Time: 1721631085000 ms
-------------------------------------------
(8,1)
(1,1)
(2,1)
(3,1)
(4,1)
(5,1)
(6,1)
(7,1)
运行结果是: 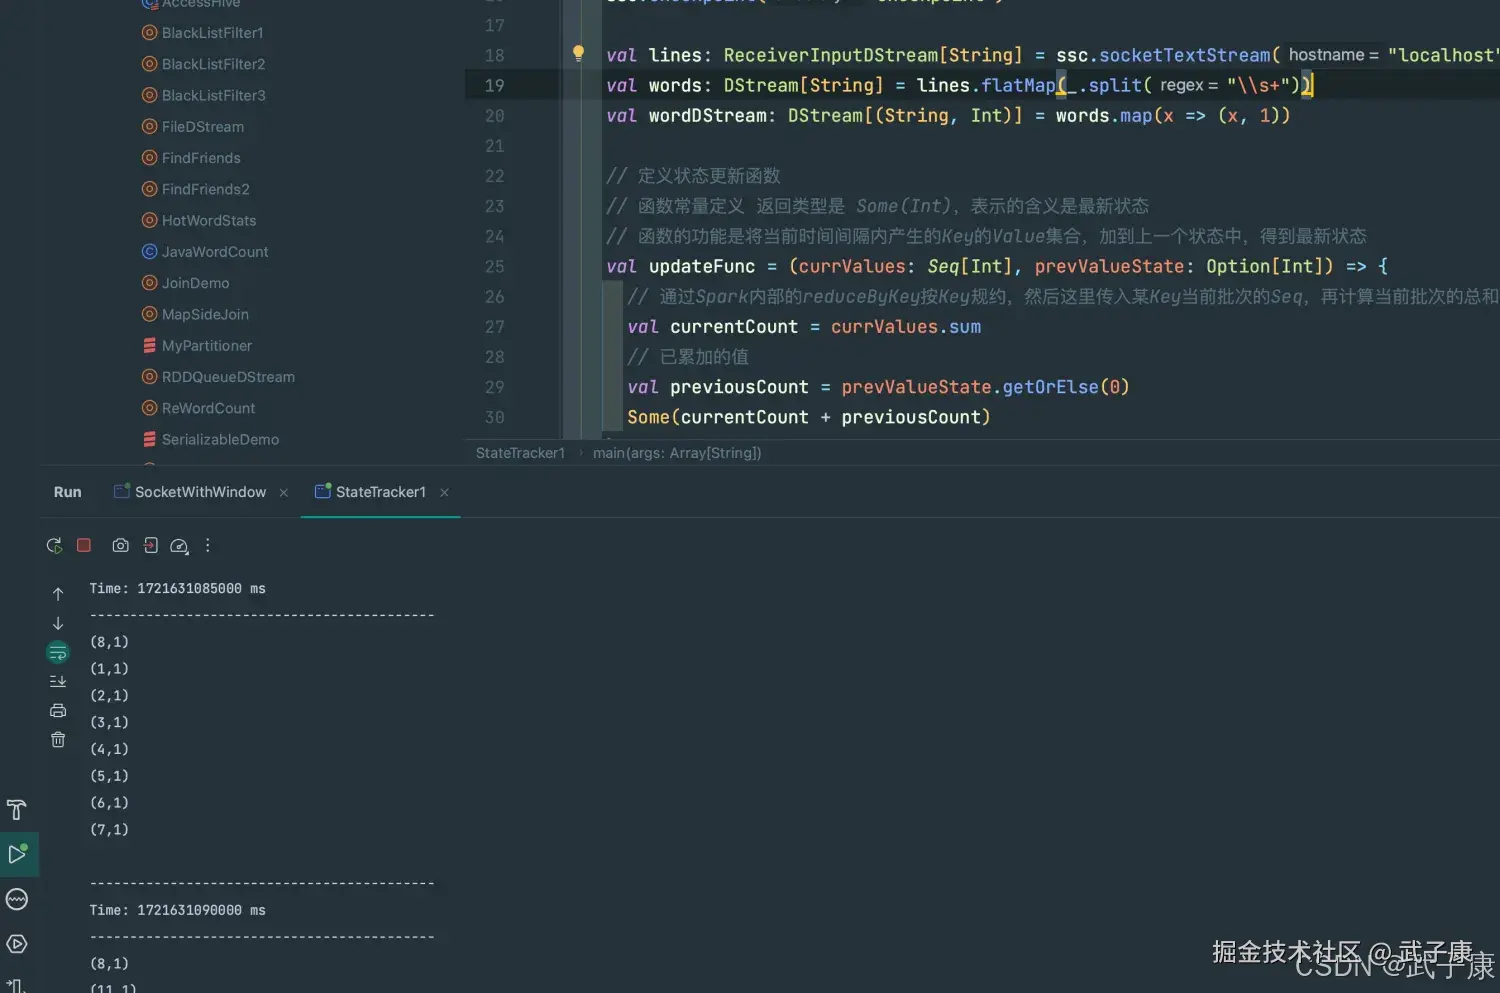 统计全局的Key的状态,但是就算没有数据输入,也会在每一个批次的时候返回之前的Key的状态。
这样的缺点:
- 如果数据量很大的话,CheckPoint数据会占用较大存储,而且效率也不高
编写代码2
mapWithState:也是用于全局统计Key的状态,如果没有数据输入,便不会返回之前的Key的状态,有一点增量的感觉。 这样做的好处是,只关心那些已经发生的变化的Key,对于没有数据输入,则不会返回那些没有变化的Key的数据,即使数据量很大,checkpoint也不会像updateStateByKey那样,占用太多的存储。
scala
package icu.wzk
object StateTracker2 {

  def main(args: Array[String]): Unit = {
    val conf: SparkConf = new SparkConf()
      .setAppName("StateTracker2")
      .setMaster("local[*]")
    val ssc = new StreamingContext(conf, Seconds(2))
    ssc.sparkContext.setLogLevel("ERROR")
    ssc.checkpoint("checkpoint")

    val lines: ReceiverInputDStream[String] = ssc.socketTextStream("localhost", 9999)
    val words: DStream[String] = lines.flatMap(_.split("\\s+"))
    val wordDStream: DStream[(String, Int)] = words.map(x => (x, 1))

    def mappingFunction(key: String, one: Option[Int], state: State[Int]): (String, Int) = {
      val sum: Int = one.getOrElse(0) + state.getOption.getOrElse(0)
      state.update(sum)
      (key, sum)
    }

    val spec = StateSpec.function(mappingFunction _)
    val resultDStream: DStream[(String, Int)] = wordDStream.mapWithState(spec)

    resultDStream.cache()

    // 把DStream保存到文本文件中,会生成很多的小文件。一个批次生成一个目录
    val outputDir = "output2"
    resultDStream.repartition(1).saveAsTextFiles(outputDir)

    ssc.start()
    ssc.awaitTermination()

  }
}
运行代码