目录
- 引言:数据洪流下的时序数据爆炸
- 选型维度再梳理:时序数据库的核心考量
- [IoTDB 的选型优势解析](#IoTDB 的选型优势解析)
- [IoTDB 与海外产品的差异化思路](#IoTDB 与海外产品的差异化思路)
- [企业实践:Timecho 在能源、金融等领域的应用](#企业实践:Timecho 在能源、金融等领域的应用)
- 总结:面向未来的时序数据库选型
引言:数据洪流下的时序数据爆炸
过去十年,随着 物联网(IoT)、工业互联网、智能制造、能源监控 等行业的快速发展,时序数据的规模以指数级增长。
这种数据有几个特点:
- 高频产生:传感器每秒采集成千上万条数据。
- 强时间属性:数据点以时间为主索引,关注趋势和变化。
- 规模庞大 :在能源、金融、电信等场景中,存储量可轻松达到 TB 到 PB 级。
传统关系型数据库(如 MySQL、PostgreSQL)并不是为时序数据而生的:它们在 高并发写入、长时间跨度查询 场景下往往性能不足,也缺乏针对时间维度的优化能力。
于是,时序数据库(Time Series Database, TSDB) 成为必然选择。
但是,面对市面上多种开源与商业产品,企业如何选型?又为什么 IoTDB 被越来越多的用户采用?
选型维度再梳理:时序数据库的核心考量
在选择时序数据库时,可以从以下五个核心维度出发:
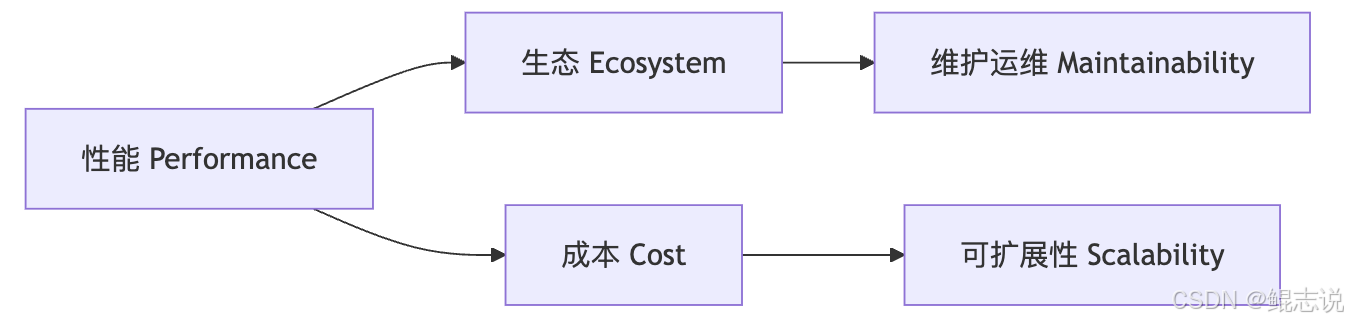
性能(Performance)
- 数据写入吞吐:能否支撑百万级点/秒?
- 查询效率:能否高效完成大窗口聚合(如近一年趋势分析)?
生态(Ecosystem)
- 是否兼容 SQL 或类 SQL?
- 是否支持大数据计算框架(Hadoop、Spark、Flink)?
- 是否有活跃的社区?
成本(Cost)
- 存储压缩率如何?能否降低硬件成本?
- 开源与企业版的平衡点?
维护与运维(Maintainability)
- 部署复杂度高吗?
- 是否有监控、告警、可视化工具支持?
可扩展性(Scalability)
- 支持单机 + 集群模式吗?
- 是否能支撑未来 PB 级扩展?
在这些维度上,IoTDB 给出了独特的答案。
IoTDB 的选型优势解析
Apache IoTDB 是由 清华大学数据库实验室发起并捐赠至 Apache 基金会的顶级项目,如今已经成为业界重要的时序数据库代表。其优势主要体现在以下几个方面:
高性能写入与查询
- IoTDB 针对时序数据优化了存储引擎,写入吞吐量可轻松达到百万点/秒。
- 内置 时序聚合算子 (如
avg,sum,max,min),在长时间窗口上也能保持高效。
高压缩比,降低成本
- IoTDB 的存储引擎采用 编码 + 压缩 技术,能够在保证查询性能的同时,大幅降低存储成本。
- 实际场景中,压缩比常常达到 10:1 以上。
友好的生态
- 提供类似 SQL 的查询语言,开发者学习成本低。
- 与 Hadoop、Spark、Flink、Grafana 等生态深度集成。
- 同时支持 标准 JDBC/REST API,方便对接企业现有系统。
单机与集群双模式
- 从小规模 PoC 到大规模集群部署,IoTDB 都能平滑迁移。
- 集群模式下,支持分布式存储与计算。
企业版 Timecho 的增强能力
- 商业支持版本 TimechoDB 提供了 安全、权限控制、多租户、可视化管理平台 等功能。
- 为能源、电力、金融等企业提供成熟的生产级方案。
IoTDB 与海外产品的差异化思路
很多人会拿 InfluxDB、TimescaleDB 这类国外开源产品来比较。这里我们不做正面对比,而是从差异化角度来解读:
- API 与查询语言:IoTDB 提供类 SQL 语法和标准 JDBC,降低了开发门槛。
- 社区活跃度:作为 Apache 顶级项目,IoTDB 拥有稳定的国际社区贡献与更新。
- 生态适配性:IoTDB 在大数据生态(Hadoop/Spark/Flink)上的集成更加深入,非常适合中国本土企业既有架构。
简单来说,如果企业目标是 和大数据生态深度结合,IoTDB 在这方面更具优势。
企业实践:Timecho 在能源、金融等领域的应用
IoTDB 已经在多个行业中得到落地验证,尤其是对 高频采集、长周期存储 的场景:
-
能源行业
- 电力公司需要实时监控电网数据,IoTDB 可以存储并分析数十亿条传感器数据。
- 通过 Timecho 的企业级功能,提升了 数据查询延迟与可用性。
-
金融行业
- 高频交易与市场行情数据的处理,需要 毫秒级查询 与 高可靠存储。
- IoTDB 支撑了实时分析与可追溯存档。
-
制造与工业互联网
- 工厂设备监控需要采集 振动、温度、压力 等指标。
- IoTDB 的压缩存储大幅降低了成本,并且支持长时间趋势分析。
这些实践充分说明,IoTDB 已经从"实验室项目"走向了"企业生产级应用"。
总结:面向未来的时序数据库选型
在"数据洪流"时代,选型一款面向未来的时序数据库,不仅仅是看 性能参数 ,更要考量 生态、成本、维护与扩展性。
IoTDB 在这些维度上都有成熟的表现,既能满足 开源开发者的学习与实验需求 ,也能通过 Timecho 企业版 服务支撑大规模行业落地。
IoTDB 正在成为越来越多企业的 未来时序数据库答案。