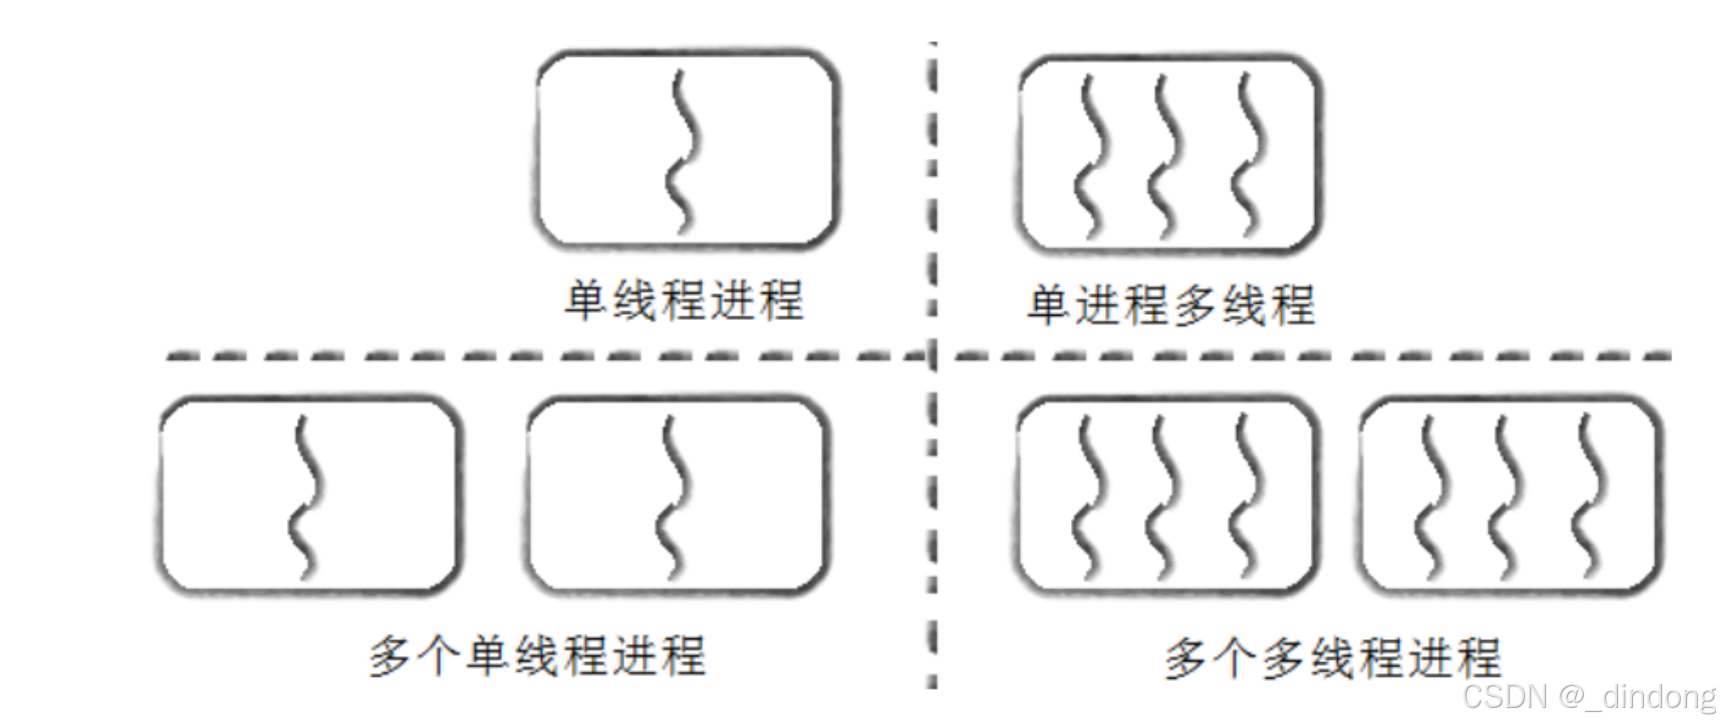
通过进程几个章节的学习,我们了解到:进程是一个运行起来的执行流,是一个加载到内存中的程序。而且,进程=内核数据结构+自己的代码和数据。所以,
1.什么是线程
• 在⼀个程序⾥的⼀个执⾏路线就叫做线程(thread)。更准确的定义是:线程是"⼀个进程内部
的控制序列"。
• ⼀切进程⾄少都有⼀个执⾏线程。
• 线程在进程内部运⾏,本质是在进程地址空间内运⾏。
• 在Linux系统中,在CPU眼中,看到的PCB都要⽐传统的进程更加轻量化。
• 透过进程虚拟地址空间,可以看到进程的⼤部分资源,将进程资源合理分配给每个执⾏流,就形
成了线程执⾏流。
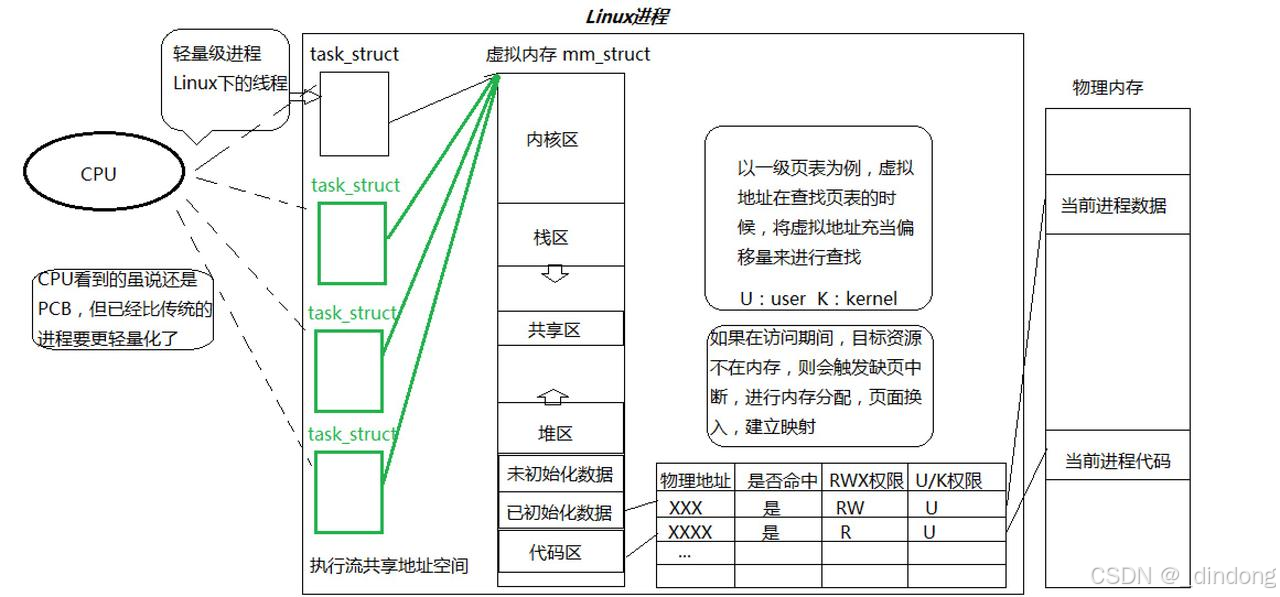
所以内核是如何进行资源划分的??
2.分页式存储管理
虚拟地址和页表的由来
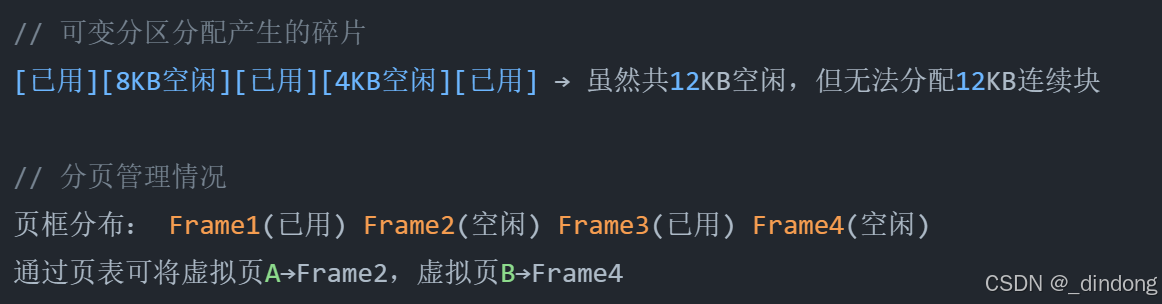
如果没有虚拟内存和分页机制,每一个用户程序在物理内存上所对应的空间必须是连续的。就像下图这样
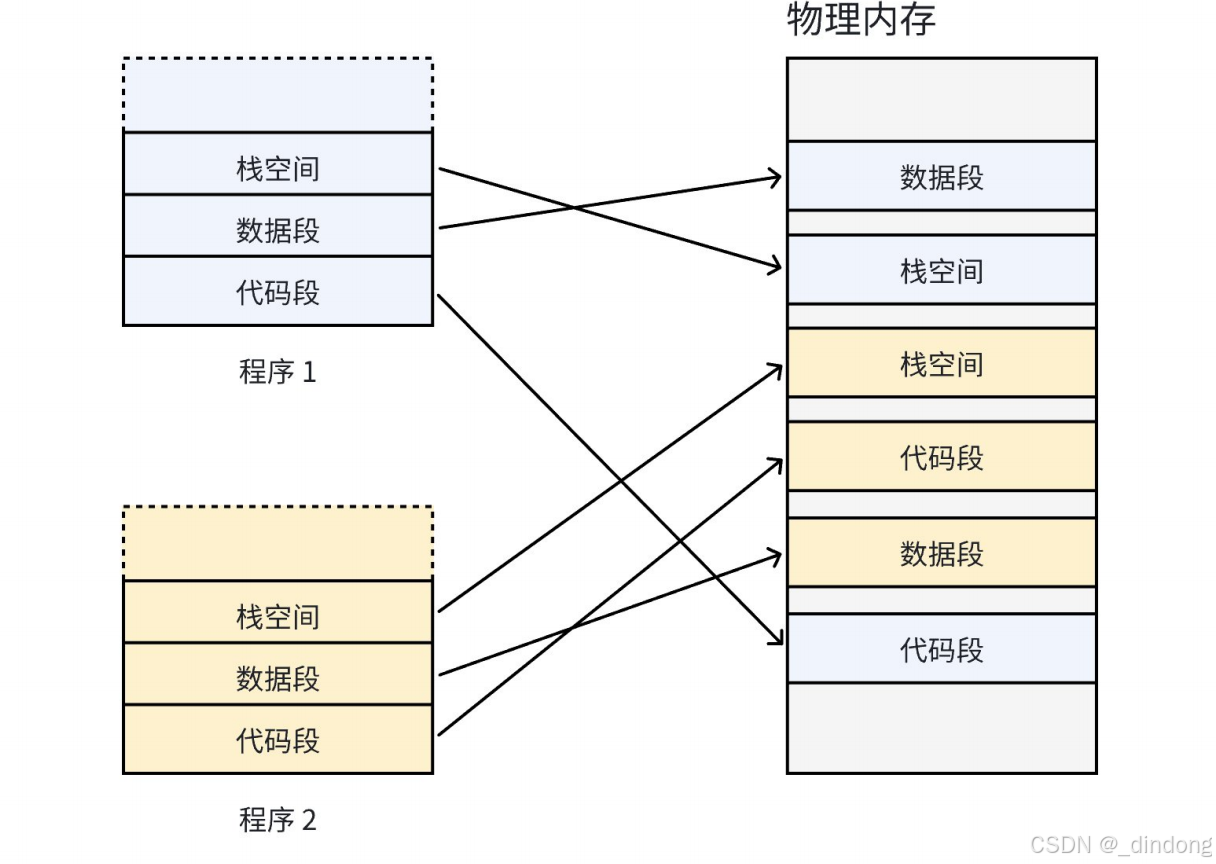
因为每一个程序的代码长度,数据长度都是不一样的,按照这样的映射方式,物理内存将会被分割成各种离散的,大小不同的块。经过一段运行时间之后,有些程序会退出,那么它们占据的物理内存空间可以被回收,导致这些物理内存都是以很多碎片的形式存在。这样内存空间被分割成许许多多不连续的小块,导致虽然总体上剩余内存足够,但却无法满足较大内存请求。
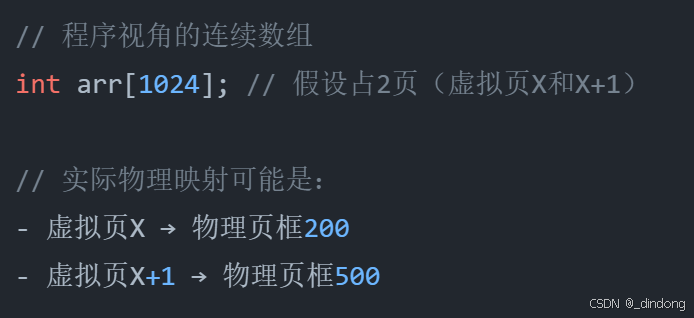
我们希望操作系统提供给用户的空间必须是连续的,但是物理内存最好不要连续。此时虚拟内存和分页便出现了,如下图所示:
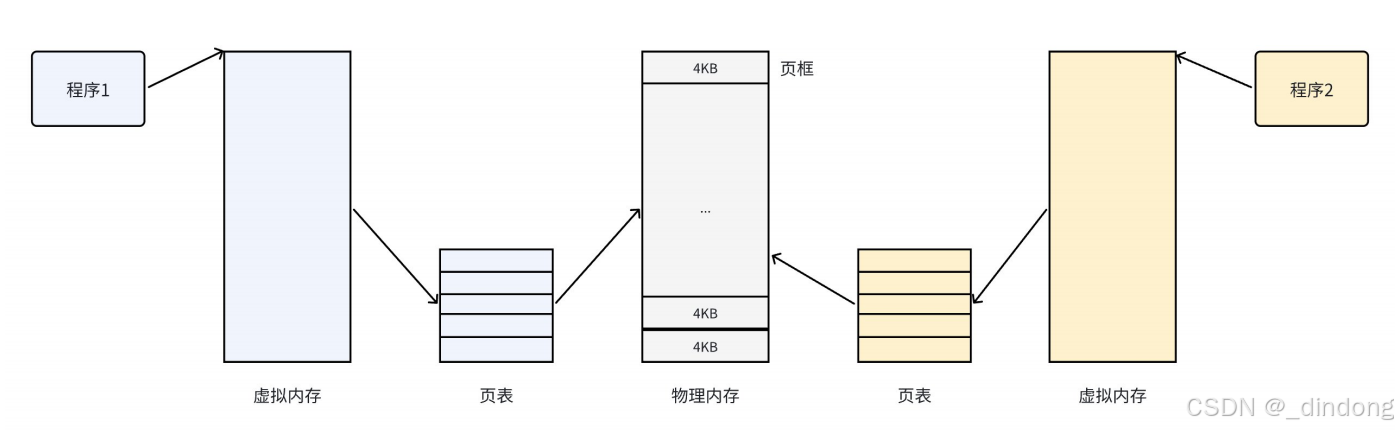
把物理内存按照一个固定的长度的页框 进行分割,有时叫做物理页。每个页框包含一个物理页(page)。一个页的大小等于页框的大小。大多数32位体系结构支持4kb的页,而64位体系结构一般会支持8kb的页。
区分一页和一个页框是很重要的:
页框是一个存储区域;而页是一个数据块,可以存放在任何页框或磁盘中。
有了这种机制,CPU便并非是直接访问物理内存地址,而是通过虚拟地址空间来间接的访问物理内存地址。所谓的虚拟地址空间,是操作系统为每一个正在执行的进程分配的一个逻辑地址,在32位机上,其范围为0~4G。
操作系统通过将虚拟地址空间和物理内存地址之间建立映射关系,也就是页表,这张表上记录了每一对 页和页框 的映射关系,能让CPU间接的访问物理内存地址。
总结一下,其思想是 将虚拟内存下的逻辑地址空间分为若干页,将物理内存空间分为若干页框,通过页表便能把连续的虚拟内存,任意映射到若干个不连续的物理内存页。这样就解决了使用连续的物理内存造成的碎片化问题。(实际上就是所有内存分配都以页为单位,一个页大小等于一个页框大小,避免分配过程中存在"尺寸匹配"问题)看下面两张图就很好理解了
物理内存管理
假设一个可用的物理内存有4GB空间。按照一个页框的大小4KB进行划分,4GB空间就是 4GB/4KB=1048576个页框。有这么多页框,操作系统肯定需要将其管理起来,操作系统需要知道哪些页正在被使用,哪些页空闲等等。
内核用 struct page 结构表示系统中的每一个物理页,处于节省内存的考虑,struct page中使用了大量的联合体union(联合体大小等于其最大成员的大小,同一时间只有一个成员是活跃的)。这样每个page都节省一点空间,page数量庞大,能带来显著的整体效益。
内核中会有struct page pages1048576的数组
0下标对应的page->第一个物理内存块(4KB)
1下标对应的page->第二个物理内存块(4KB)
....
那么 物理地址,可以通过数组下标转化而来,物理块的起始地址=数组下标*4KB
申请一个内存块4KB,本质是你要访问什么struct page
知道对应struct page的下标,那么物理内存的所有地址就全有了。
所以,申请所谓的内存,本质就是在数组中申请一个struct page结构。
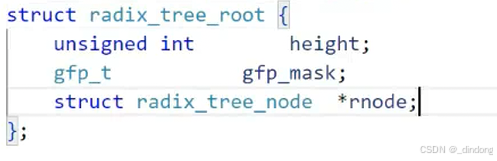
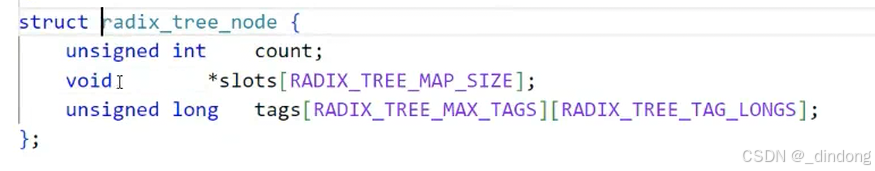
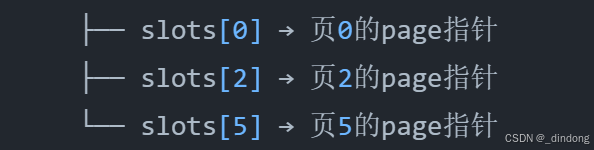
struct file里有一个struct address_space数据项(,其内部又有一个struct radix_tree_root,其内部又有一个struct radix_tree_node
其内部的slots存储一个个指向 struct page结构 的指针。
所谓的文件缓冲区,本质就是无数个struct page构成的内存池。
struct page是一个个文件的物理载体,address_space是组织方式,struct file是访问入口。
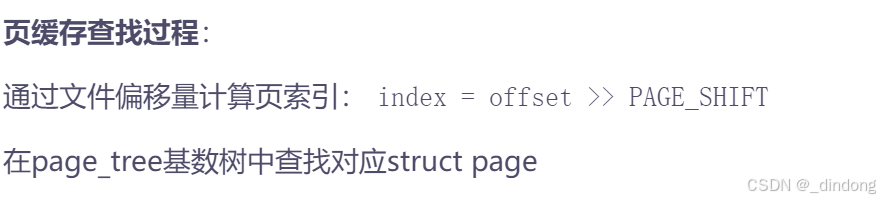
所以文件,进程等和内存之间的关系,就转换成了file , task_struct和page的数据结构了。
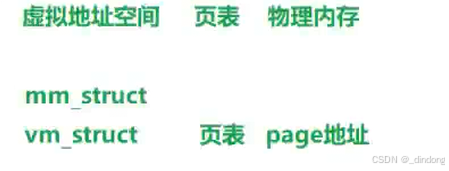
虚拟空间 通过 页表 和物理内存之间建立映射,本质就是
mm_struct,vm_struct 通过页表 和 page地址 进行映射
struct page:
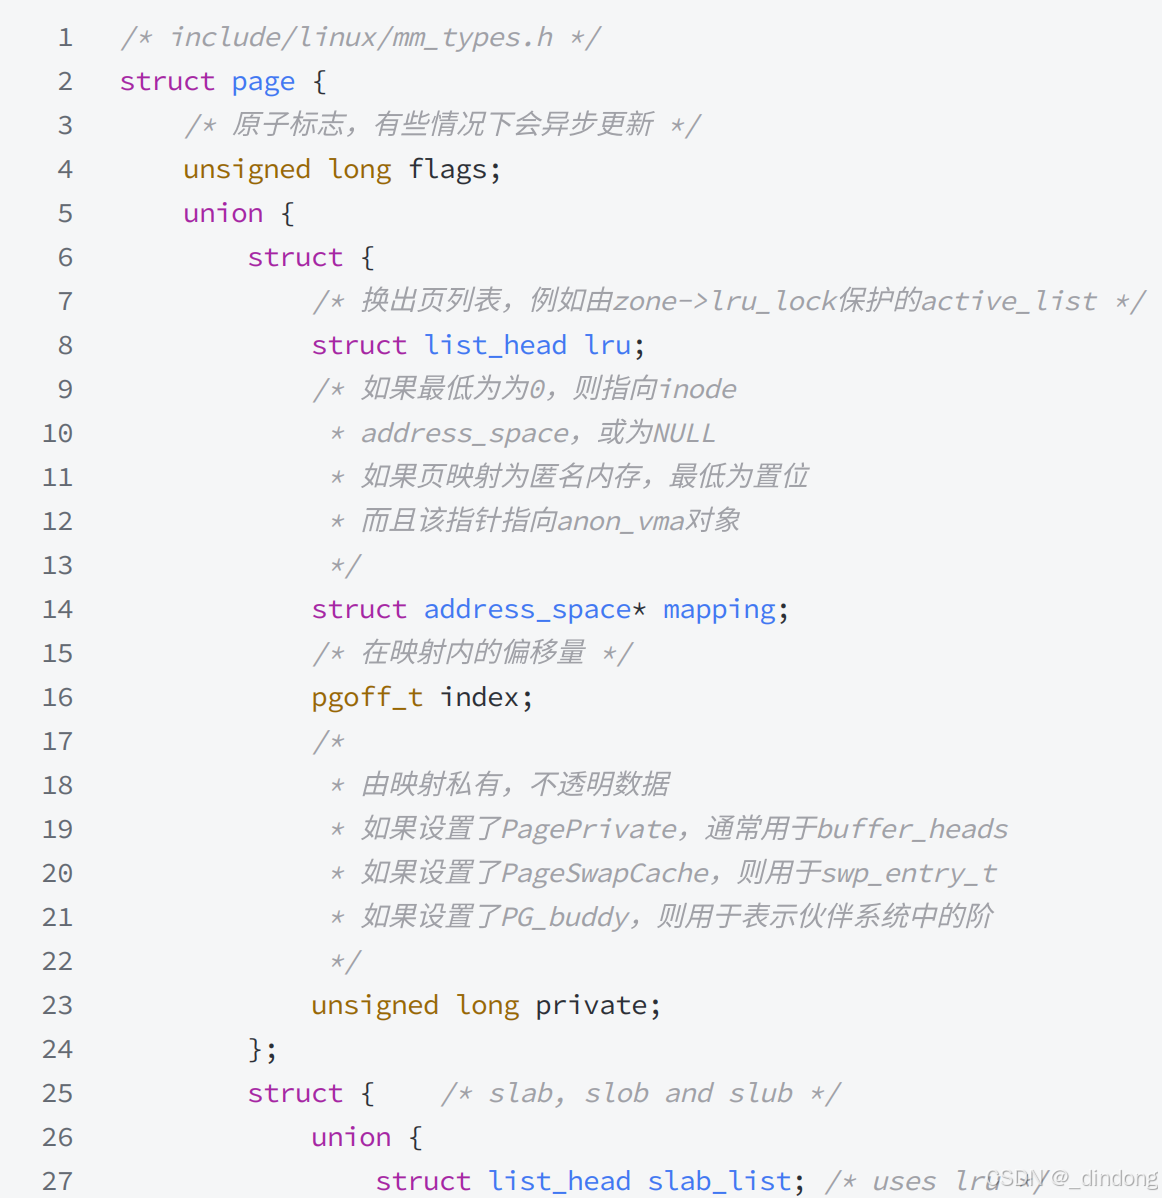
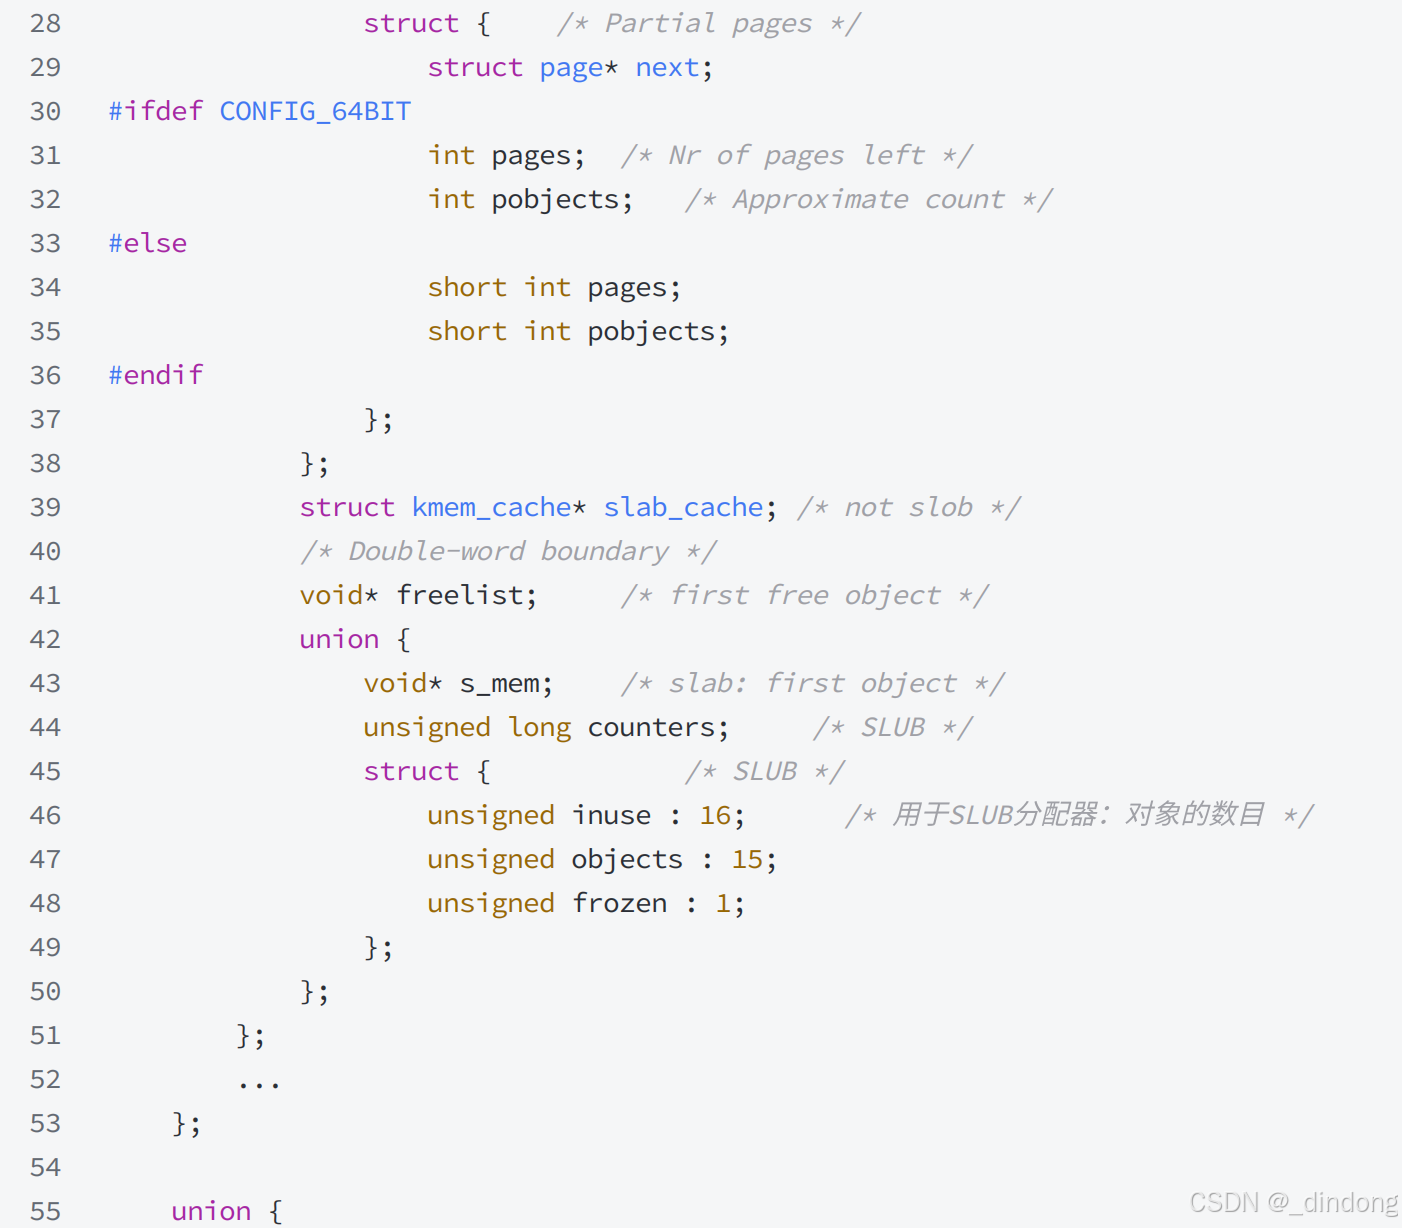
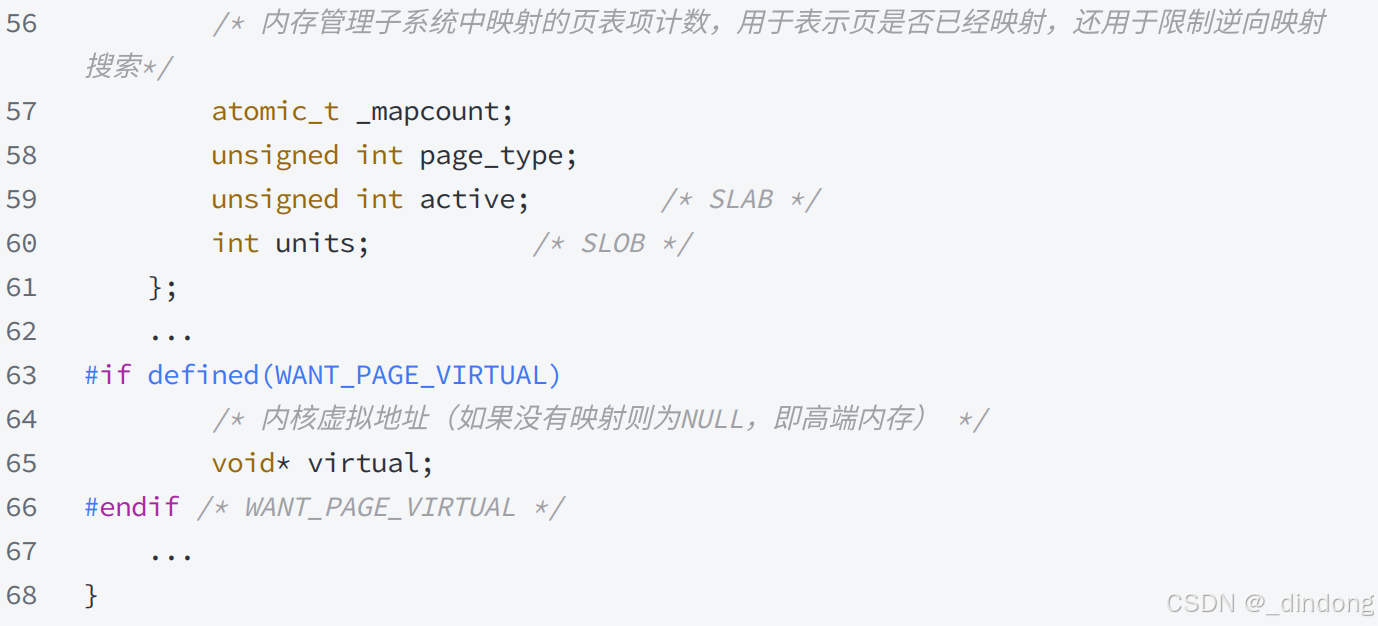
其中一些重要的参数:
flags:
本质是一个位图,用来存放页的状态。这些状态包括页是不是脏的,是不是被锁定在内存中等。flag的每一位单独表示一种状态,所以它至少可以同时表示出32种不同的状态。这些标志定义在<linux/page-flags.h>中。其中一些比特位非常重要,如PG_locked用于指定页是否锁定,PG_uptodate用于表示页的数据已经从块设备读取并且没有出现错误。
_mapcount:
表示在页表中有多少项指向该页,也就是这一页被引用了多少次。当计数值变为-1时,就说明当前内核并没有引用这一页,于是在新的分配中就可以使用它。
virtual:
页的虚拟地址。通常情况下,它就是页在虚拟内存中的地址。有些内存(即所谓的高端内存)并不永久地映射到内核地址空间上。在这种情况下,这个域的值为NULL,需要的时候,必须动态地映射这些页。
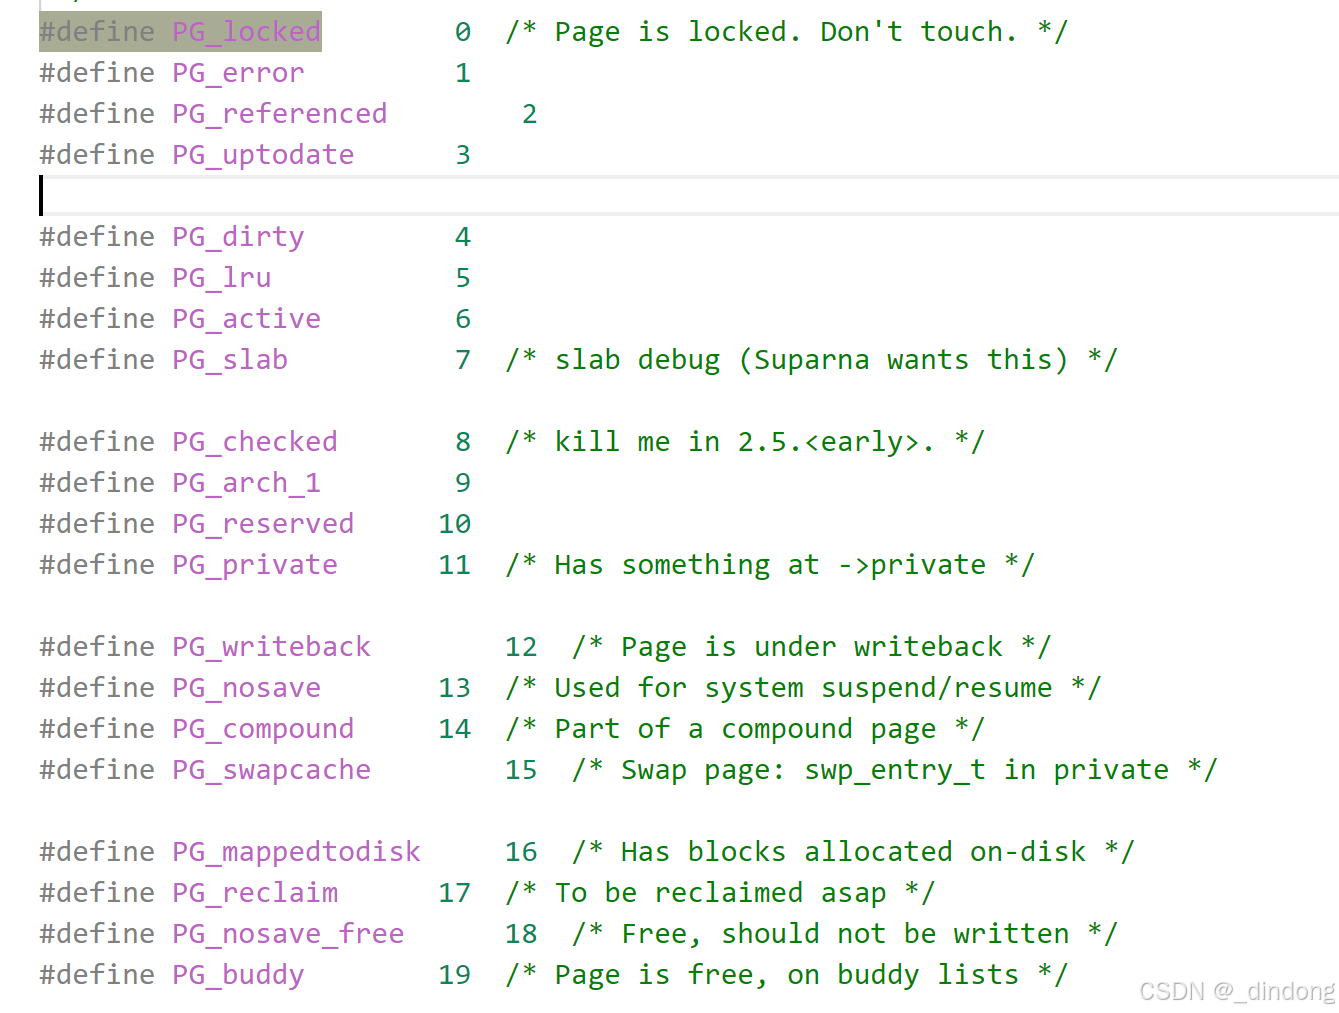
要注意的是 struct page与物理页相关,而并非与虚拟页相关。而系统中的每个物理页都要分配一个这样的结构体,对所有这些页面都这么做,需要消耗多少内存?
算struct page占40个字节。假定系统的物理页为4KB大小,系统有4GB物理内存,那么系统中共有页面大概 1兆个。所以描述这么多页面的page结构体消耗的内存只不过40MB,相对系统4GB内存而言,仅是很小的一部分罢了。因此,要管理系统中这么多物理页面,这个代价很小很小。
页的大小对于 内存利用 和 系统开销 来说非常重要,页太大,页内必然会剩余较大不能利用的空间(页内碎片)。页太小,虽然可以减小页内碎片的大小,但是页太多,会占用太多内存,同时系统频繁地进行页转化,加重系统开销。因此,页的大小应该适中,通常为512B-8KB,windows/Linux系统的页框大小为4KB。
页表
页表中的每一个表项,指向一个物理页的开始地址。在32位系统中,虚拟内存的最大空间是4GB,这是每一个用户程序都拥有的虚拟内存空间。既然需要让4GB的虚拟空间内存全部可用,那么页表中就需要能够表示这所有的4GB空间,那么就一共需要 4GB/4KB=1048576个表项。
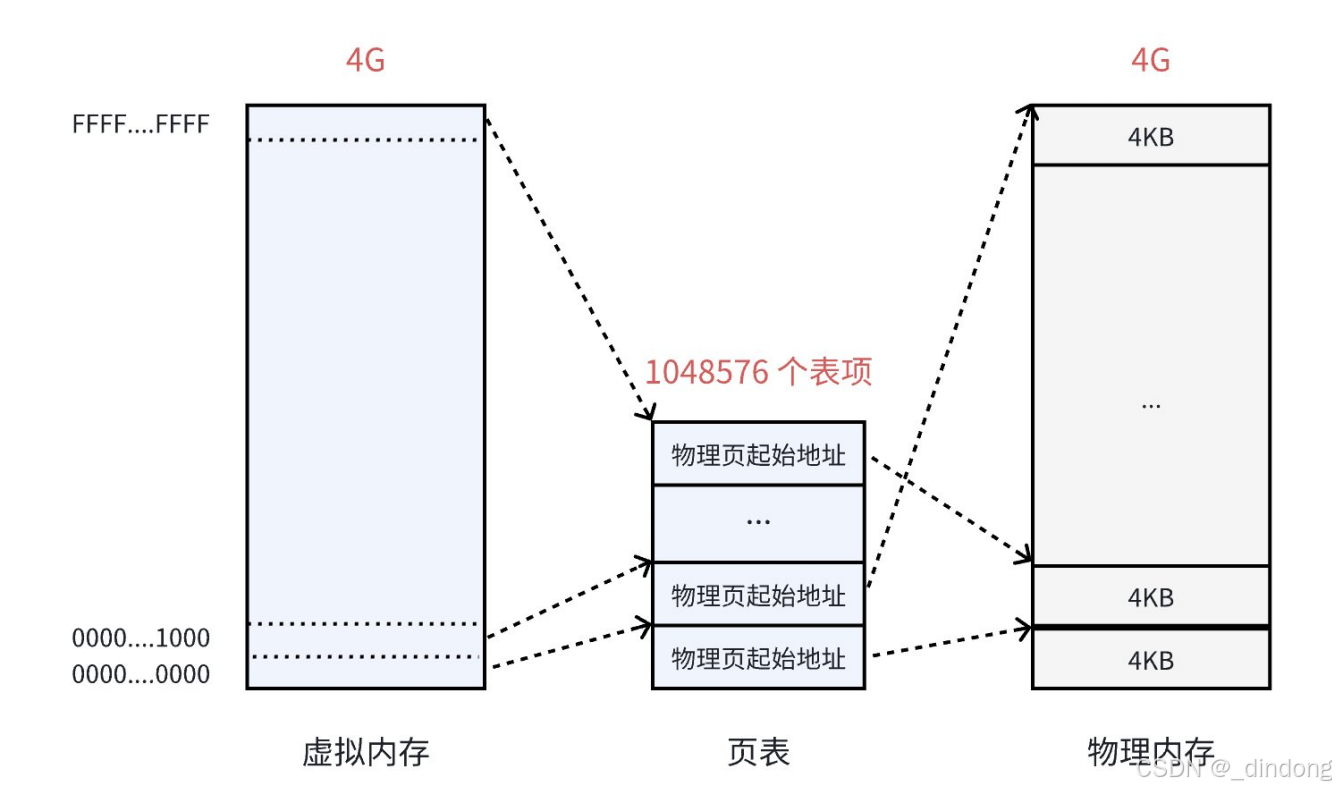
虚拟内存看上去被虚线"分割"成一个个单元,其实并不是真的分割,虚拟内存仍然是连续的。这个虚线的单元仅仅表示它与页表中的每一个表项的映射关系,并最终映射到相同大小的一个物理内存页上。页表中的物理地址,与物理内存之间,是随机的映射关系,哪里可用就指向哪里(物理页)。虽然最终使用的物理内存是分散的,但是与虚拟内存对应的线性地址是连续的。处理器在访问数据、获取指令时,使用的都是线性地址(也就是虚拟地址),只要它是连续的就可以了,最终都能够通过页表找到实际的物理地址。
假设,在32位的系统中,地址的长度是4个字节,那么页表中的每一个表项就是占用4个字节。所以页表占据的总共空间大小就是1048576*4=4MB的大小。也就是说,映射表自己就要占用4MB/4KB=1024个连续的物理页框。这会造成以下问题:
当初使用页表,就是要将进程划分为一个个页可以不用连续的存放在物理内存中,但是此时的页表却是1024个连续的页框,这与页式管理的"允许不连续"的初衷背道而驰。
此外,根据局部性原理,即使进程运行时通常只需要访问少数几个页,但是整个大页表必须常驻内存。
解决方案就是:
对页表进行再分页,也就是将大页表拆分成很多小页表,形成类似多叉树的层次结构,比如下面的页目录结构。就相当于一本书的目录,原先是详细的目录,现在我只在目录写每个章节的目录,你翻到对应章节,才能看到这个章节下的详细细分目录。
比如把单一的大页表,拆分成1024个体积更小的映射表。这样一来1024(每个表中的表项个数)*1024(表的个数),仍然可以覆盖4GB的物理内存空间。
这样我们就能按需要动态分配你需要的页框的内存,而不是让整个大页表常驻内存。而且不同二级页表也不需要连续。
页目录结构
管理页表的表 称为 页目录表,形成二级页表。如图所示:
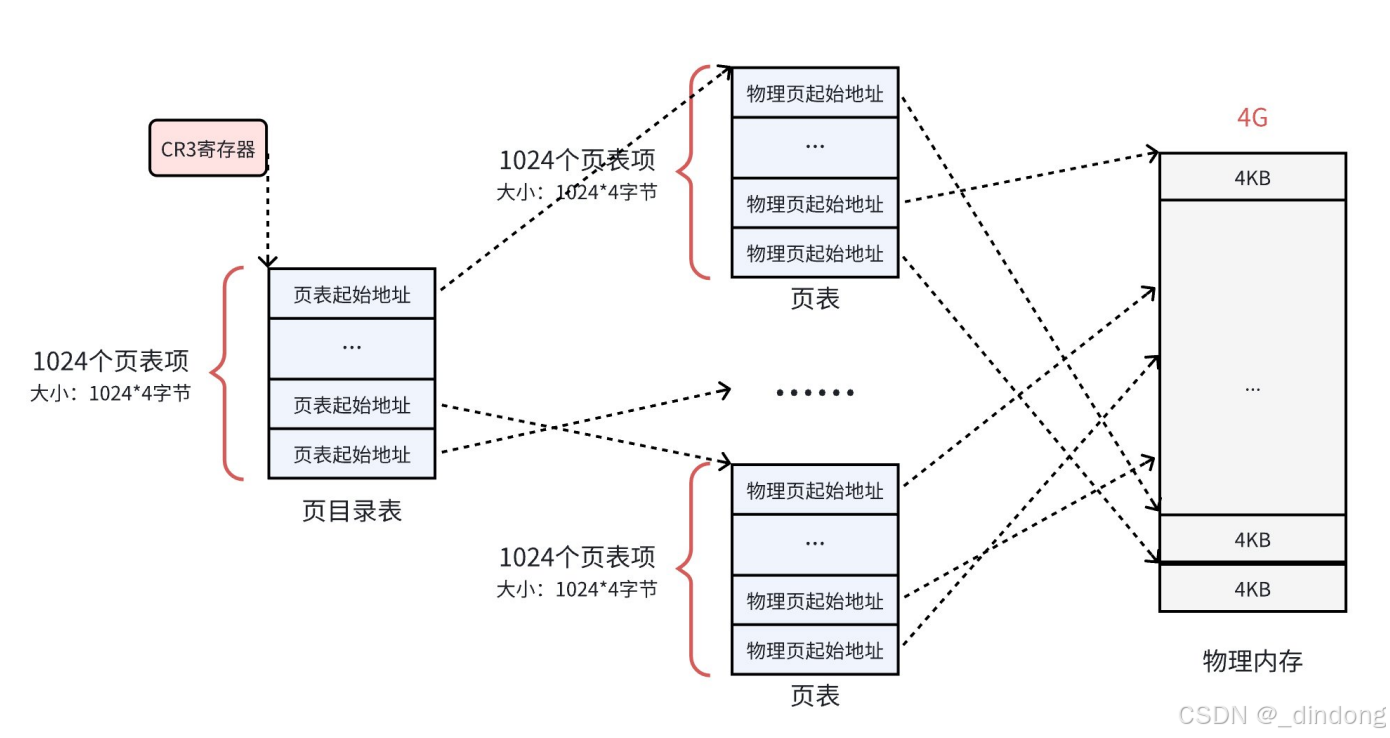
• 所有⻚表的物理地址被⻚⽬录表项指向
• ⻚⽬录的物理地址被 CR3 寄存器 指向,这个寄存器中,保存了当前正在执⾏任务的⻚⽬录地
址。
所以操作系统在加载用户程序的时候,不仅仅需要为程序内容来分配物理内存,还需要为用来保存程序的页目录和页表分配物理内存。
二级页表的地址转换
逻辑地址( 0000000000,0000000001,11111111111 )转换为物理地址的过程:
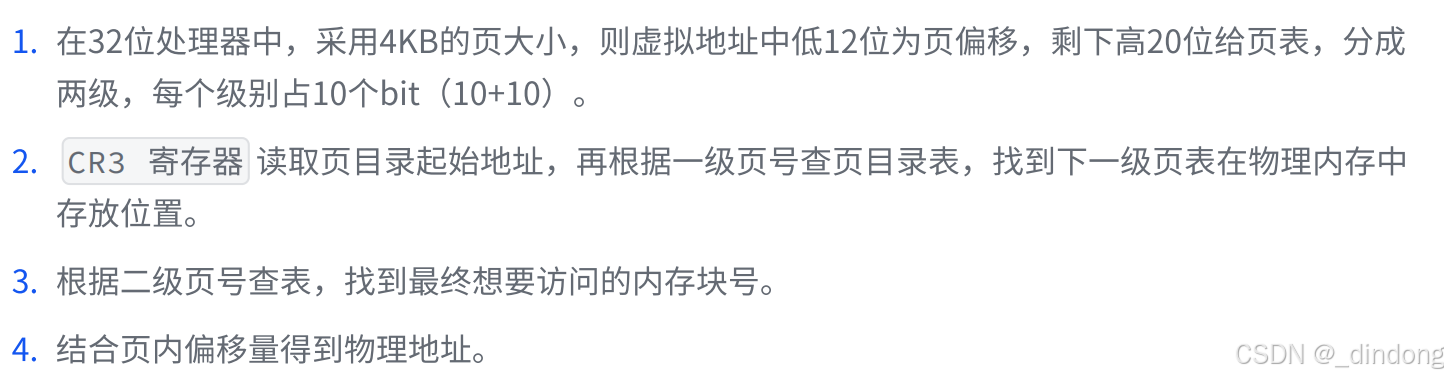
CR3会保存页目录的起始地址,从左往右,第一个10位表示 页目录索引,第二个10位 表示页表索引,剩余12位表示 页内偏移量。
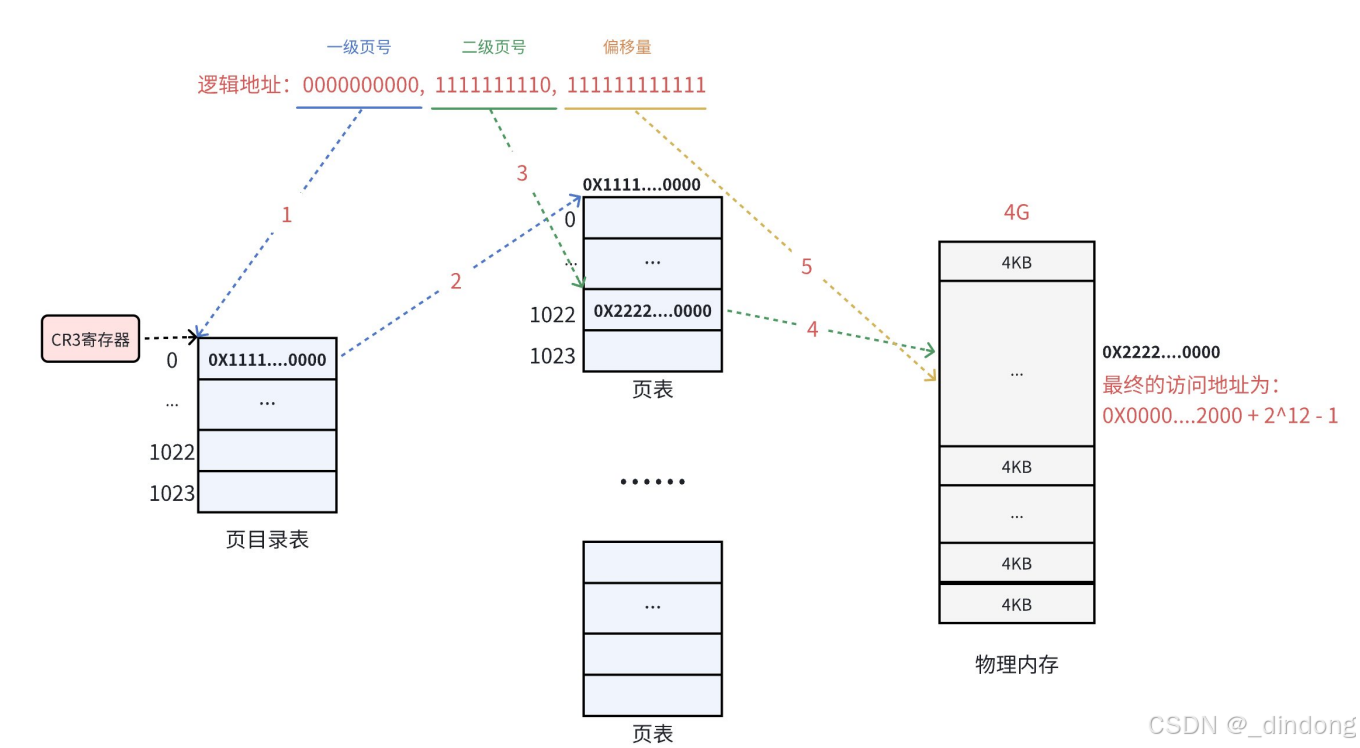
注:一个物理页的地址一定是4KB一个单位的,也就是说最后12位全部为0,所以其实只需要记录物理页地址高20位即可。
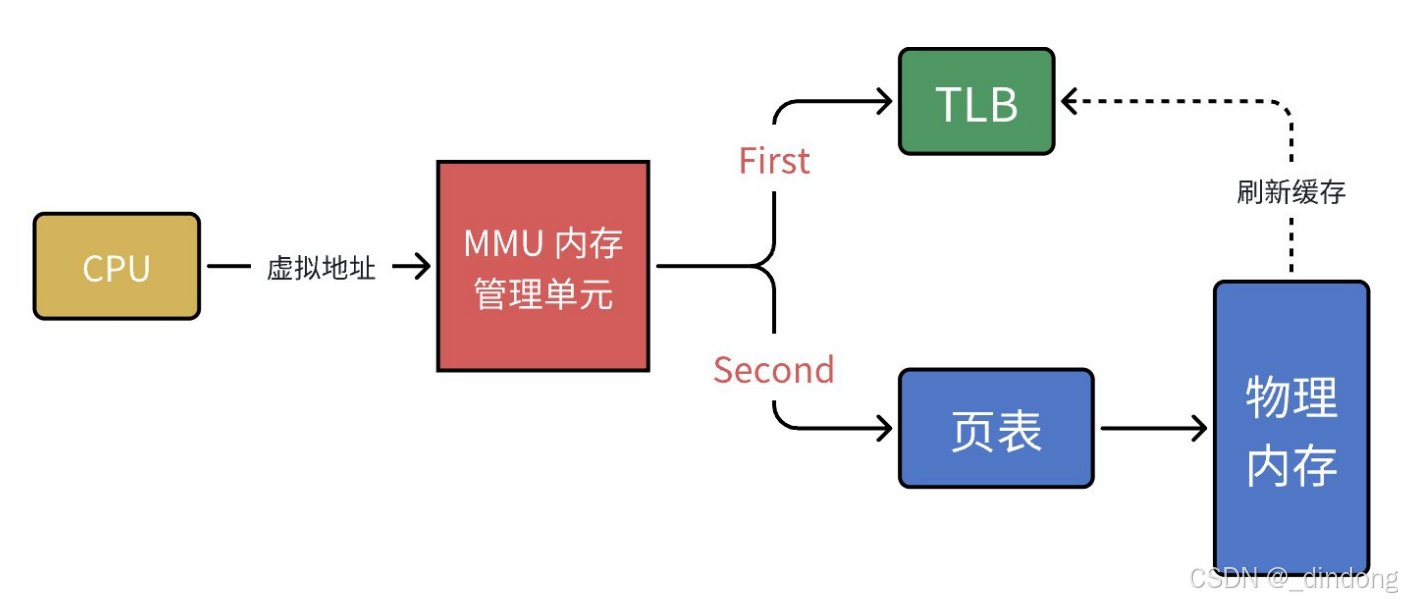
以上其实就是MMU的工作流程。MMU(Memory Manage Unit)是一种硬件电路,其速度很快,主要工作是进行内存管理,地址转换只是它承接的业务之一。
目前为止还存在一个问题,MMU要先进行两次页表查询确定物理地址,在确认了权限等问题后,MMU再将这个物理地址发送到总线,内存收到之后开始读取对应地址的数据并返回。那么当页表变为N级时,就变成了N次检索+1次读写。页表级数越多查询的步骤越多,对于CPU来说等待时间越长,效率越低。
总结一下:单级页表对连续内存要求高,于是引入了多级页表,但是多级页表也是一把双刃剑,在减少连续存储要求且减少存储空间的同时降低了查询效率。
有没有提升效率的办法呢?计算机科学中的所有问题,都可以通过添加⼀个中间层来解决。 MMU 引⼊了新武器,江湖⼈称快表的 TLB (其实,就是缓存,Translation Lookaside Buffer,学名转译后备缓冲器)当 CPU 给 MMU 传新虚拟地址之后, MMU 先去问 TLB 那边有没有,如果有就直接拿到物理地址发到总线给内存,⻬活。但 TLB 容量⽐较⼩,难免发⽣ Cache Miss ,这时候 MMU 还有保底的⽼武器⻚表,在⻚表中找到之后 MMU 除了把地址发到总线传给内存,还把这条映射关系给到TLB,让它记录⼀下刷新缓存。
缺页异常
设想,CPU 给 MMU 的虚拟地址,在 TLB 和⻚表都没有找到对应的物理⻚,该怎么办呢?其实这就是缺⻚异常 Page Fault ,它是⼀个由硬件中断触发的可以由软件逻辑纠正的错误。
假如⽬标内存⻚在物理内存中没有对应的物理⻚或者存在但⽆对应权限,CPU 就⽆法获取数据,这种情况下CPU就会报告⼀个缺⻚错误。
由于 CPU 没有数据就⽆法进⾏计算,CPU罢⼯了⽤⼾进程也就出现了缺⻚中断,进程会从⽤⼾态切换到内核态,并将缺⻚中断交给内核的 Page Fault Handler 处理。
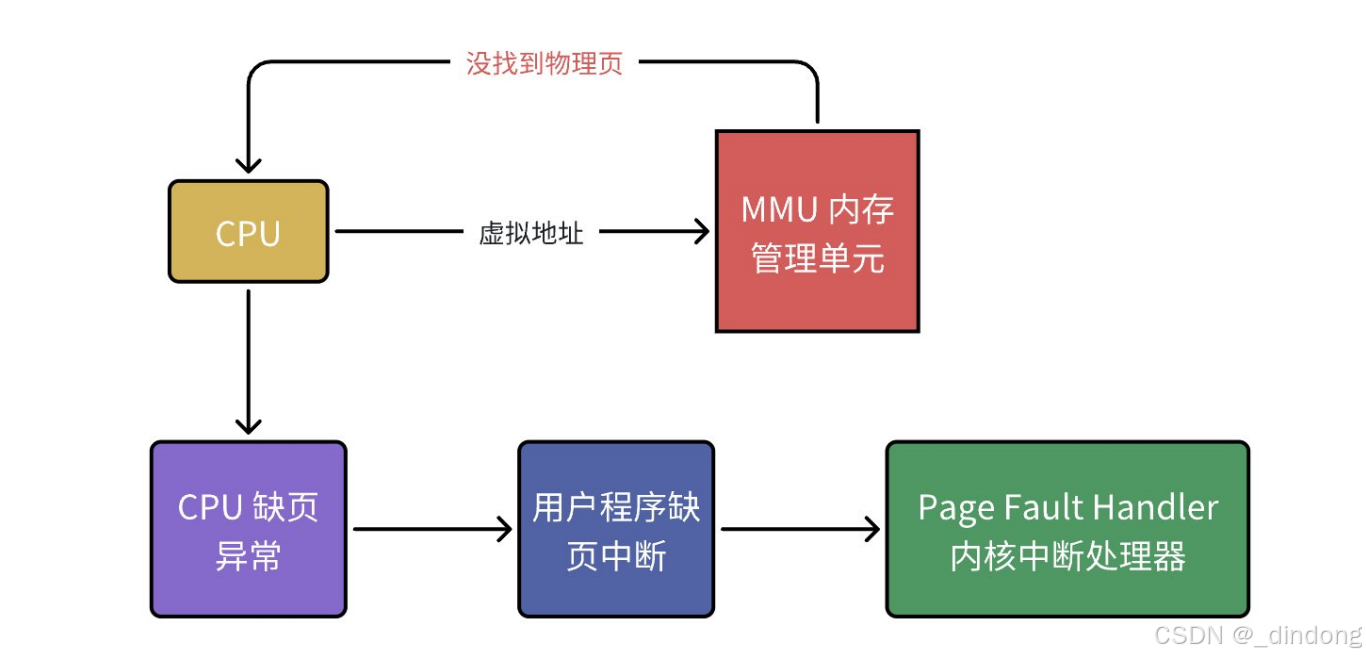
缺⻚中断会交给 PageFaultHandler 处理,其根据缺⻚中断的不同类型会进⾏不同的处理:
• Hard Page Fault 也被称为 Major Page Fault ,翻译为硬缺⻚错误/主要缺⻚错误,这时物理内存中没有对应的物理⻚,需要CPU打开磁盘设备读取到物理内存中,再让MMU建⽴虚拟地址和物理地址的映射。
• Soft Page Fault 也被称为 Minor Page Fault ,翻译为软缺⻚错误/次要缺⻚错误,这时物理内存中是存在对应物理⻚的,只不过可能是其他进程调⼊的,发出缺⻚异常的进程不知道⽽已,此时MMU只需要建⽴映射即可,⽆需从磁盘读取写⼊内存,⼀般出现在多进程共享内存区域。
• Invalid Page Fault 翻译为⽆效缺⻚错误,⽐如进程访问的内存地址越界访问,⼜⽐如对空指针解引⽤内核就会报 segment fault 错误中断进程直接挂掉。
进程首次加载磁盘块时,OS做什么?
OS做内存管理:申请内存,也就是申请Page,那么我们就要得到page的index,从而得到对应得的页框物理地址,然后进行填充页表。
如果我们访问的是,一个int?一个结构体?一个数组?一个类变量?又是如何拿到这些数据的?
所有变量都只有一个地址,这个地址是开辟出的地址的最小字节地址(这里的地址都是虚拟地址),页表转换的时候,只能拿到第一个字节的地址,语言中存在类型的概念,实际就是为了匹配对应的偏移量。我们要访问的范围就是 起始地址+偏移量。
如何再次理解写时拷贝?缺页中断?
OS申请和管理内存,都是以4KB为一个单位,因为一个页框大小就是4KB;缺页中断重新换入也是以4KB为单位。
如何再次理解new和malloc?(内存管理机制,类似STL的空间配置器)
new和malloc申请(底层系统调用brk,mmap,brk是改变数据段大小的,mmap也是一种共享内存技术),看似可以随意指定申请内存的大小,但实际上还是以4KB为单位申请的,系统调用也是有成本的,所以我们申请到的总内存大小要恰好>=我们需要的内存大小,多出的部分仍然不会让我们使用。free的时候不用传偏移量啥的,只需要传要free的对象即可,因为库里有描述内存块的结构体,结构体里表明了数据块的大小。
如何区分是缺页了?还是真的越界了?
1.页号合法性检查:操作系统在处理中断或异常时,首先检查触发事件的虚拟地址的页号是否合法。如果页号合法但页面不在内存中,则为缺页中断;如果页号非法,则为越界访问。
2.内存映射检查:操作系统还可以检查触发事件的虚拟地址是否在当前进程的内存映射范围内。如果地址在映射范围内但页面不在内存中,则为缺页中断;如果地址不在映射范围内,则为越界访问。
线程资源划分的真相:只要将虚拟地址空间进行划分,进程资源就天然被划分好了。
3.线程的优点
• 创建⼀个新线程的代价要⽐创建⼀个新进程⼩得多。
• 与进程之间的切换相⽐,线程之间的切换需要操作系统做的⼯作要少很多。
◦ 最主要的区别是线程的切换虚拟内存空间依然是相同的,但是进程切换是不同的。这两种上下⽂切换的处理都是通过操作系统内核来完成的。内核的这种切换过程伴随的最显著的性能损耗是将寄存器中的内容切换出。
◦ 另外⼀个隐藏的损耗是上下⽂的切换会扰乱处理器的缓存机制。简单的说,⼀旦去切换上下⽂,处理器中所有已经缓存的内存地址⼀瞬间都作废了。还有⼀个显著的区别是当你改变虚拟内存空间的时候,处理的⻚表缓冲 TLB (快表)会被全部刷新,这将导致内存的访问在⼀段时间内相当的低效。但是在线程的切换中,不会出现这个问题,当然还有硬件cache。
• 线程占⽤的资源要⽐进程少。
• 能充分利⽤多处理器的可并⾏数量。
• 在等待慢速I/O操作结束的同时,程序可执⾏其他的计算任务。
• 计算密集型应⽤,为了能在多处理器系统上运⾏,将计算分解到多个线程中实现。
• I/O密集型应⽤,为了提⾼性能,将I/O操作重叠。线程可以同时等待不同的I/O操作。
4.线程的缺点
• 性能损失
◦ ⼀个很少被外部事件阻塞的计算密集型线程往往⽆法与其它线程共享同⼀个处理器。如果计算密集型线程的数量⽐可⽤的处理器多,那么可能会有较⼤的性能损失,这⾥的性能损失指的是增加了额外的同步和调度开销,⽽可⽤的资源不变。
• 健壮性降低
◦ 编写多线程需要更全⾯更深⼊的考虑,在⼀个多线程程序⾥,因时间分配上的细微偏差或者因共享了不该共享的变量⽽造成不良影响的可能性是很⼤的,换句话说线程之间是缺乏保护的。
• 缺乏访问控制
◦ 进程是访问控制的基本粒度,在⼀个线程中调⽤某些OS函数会对整个进程造成影响。
• 编程难度提⾼
◦ 编写与调试⼀个多线程程序⽐单线程程序困难得多。
5.线程异常
• 单个线程如果出现除零,野指针问题导致线程崩溃,进程也会随着崩溃。
• 线程是进程的执⾏分⽀,线程出异常,就类似进程出异常,进⽽触发信号机制,终⽌进程,进程
终⽌,该进程内的所有线程也就随即退出。
6.线程用途
• 合理的使⽤多线程,能提⾼CPU密集型程序的执⾏效率
• 合理的使⽤多线程,能提⾼IO密集型程序的⽤⼾体验(如⽣活中我们⼀边写代码⼀边下载开发工具,就是多线程运⾏的⼀种表现)
7.进程vs线程
• 进程间具有独⽴性
• 线程共享地址空间,也就共享进程资源
进程和线程:
• 进程是资源分配的基本单位
• 线程是调度的基本单位
• 线程共享进程数据,但也拥有⾃⼰的⼀部分"私有"数据:
◦ 线程ID
◦ ⼀组寄存器,线程的上下⽂数据
◦ 栈
◦ errno
◦ 信号屏蔽字
◦ 调度优先级
进程的多个线程共享:
同⼀地址空间,因此 Text Segment 、 Data Segment 都是共享的,如果定义⼀个函数,在各线程中都可以调⽤,如果定义⼀个全局变量,在各线程中都可以访问到,除此之外,各线程还共享以下进程资源和环境:
• ⽂件描述符表
• 每种信号的处理⽅式(SIG_ IGN、SIG_ DFL或者⾃定义的信号处理函数)
• 当前⼯作⽬录
• ⽤⼾id和组id
进程和线程的关系如图所示: