1. 写在最前面
用了这么久的 Cursor ,还是会时不时的感慨科技使人类进步。尤其是最近的「Claude Sonnet 4」 好用的不得了,在丢给它一个需求之后,从设计方案、到 coding、以及编写 tase case 、修复验证逻辑、甚至还记的 lint 一下,无比贴心。但是随之而来的坏处就是,过分相信 Cursor 之后,不在去理解库是否符合业务场景。
注:尽信书,则不如无书。看来在提升 coding 效率的同时,也要更为慎重的思考每个使用 场景是否符合最初设计的预期。
2. 问题小计
2.1 aiohttp 库
前置说明,笔者并不是很熟悉 Python ,属于一边用,一边学习的状态。接的需求是,在使用 aiohttp 库的时候,能够复用 http client ,无需每次请求都重新建立连接,以达到最终减少请求和返回的耗时的目的。
笔者实现的方式:
python
def _get_session(self) -> aiohttp.ClientSession:
        if self._session is not None and not self._session.closed:
            return self._session

        new_session = aiohttp.ClientSession(
            timeout=aiohttp.ClientTimeout(total=30),
            connector=aiohttp.TCPConnector(limit=100, enable_cleanup_closed=True),
            trace_configs=[self.trace_config],
        )

        self._session = new_session
        return self._session
注:这当然是 cursor 帮忙给的思路。但是笔者当时大意了,没有细细的深究 aiohttp.ClientTimeout 这字段的意思。
不推卸责任,问题当时是实现代码人的问题,记录在这里,方便下次在类似的改动前,能够在深入探究一步,减少后续返工以及故障的可能性。
先解释一下 aiohttp.ClientTimeout 字段的意思
ini
timeout = aiohttp.ClientTimeout(
    total=None,           # 总超时时间
    connect=None,         # 连接超时时间
    sock_connect=None,    # Socket 连接超时时间
    sock_read=None        # Socket 读取超时时间
)
各参数详细说明
-
total (float | None)
- 整个请求的总超时时间(秒),包括连接建立、发送请求、接收响应的全部时间,默认值:5 分钟 (300 秒),设置为 None 表示无限制
-
connect (float | None)
- 建立连接的超时时间(秒),包括 DNS 解析、TCP 连接建立、SSL 握手等,默认值:无限制 (None)
-
sock_connect (float | None)
- 底层 socket 连接的超时时间(秒),仅针对 TCP socket 连接建立阶段,默认值:无限制 (None)
-
sock_read (float | None)
- Socket 读取数据的超时时间(秒),在连接建立后读取响应数据的超时,默认值:无限制 (None)
先解释了参数的含义之后,就可以推测到现象是,如果 response 持续返回的时间超过 30s ,就会主动断开连接。
注:除了 aiohttp.ClientTimeout,建议再用 aiohttp.TCPConnector 字段时也要先确认字段的生效规则后使用。
2.2 奇怪的问题
笔者本次提测改动的功能很少,但是 QA 测试的时候报了很多跟功能无关的 jira ,比如:
- start 的时候返回超时报错
- 启动的任务,自动退出查询不到了
注:这种跟改动无任何关系的问题,查起来真的有点子费人......
问题1:start 的时候返回超时报错
结论:最终查下来, start 超时是因为请求的机器,磁盘读写耗时极高,分析下来,可能是因为混用的测试环境,其他服务的测试写入了过多的音视频文件导致......
还好,公司的机器是有 cpu、memery、磁盘等 Zeus 监控的,不然都没办法自证业务的清白了。
注:不过这里虽然机器有问题的可能性比较高,但有一点,我还是没有想通的为什么磁盘耗时高会表现 start 超时呢?印象中业务的 start 行为中没有任何写入磁盘的行为。
cursor 一个比较符合的原因的回答是:
- 依赖库加载:Python模块、动态库加载需要磁盘I/O
- 超时连锁反应:磁盘I/O慢 → 启动步骤延迟 → 健康检查超时 → 服务被认为启动失败
问题2: 启动的任务,自动退出查询不到了
结论:是因为业务消耗的资源的内存变多了,之前 pod 设置的 memory 是 1G,导致 oom 了......
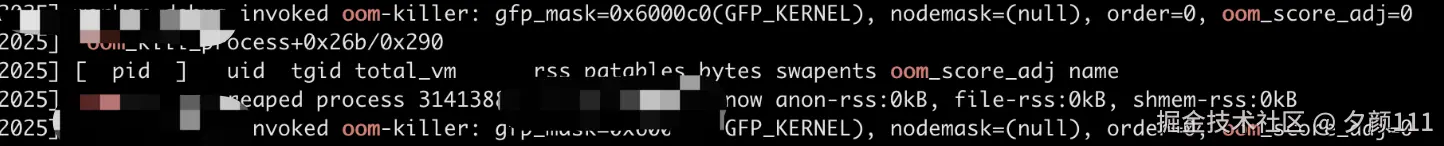
为了能够按时交付版本,本次的改动是先调整部署的 chart ,将 memory 从 1G 调整 2G
至此,那些奇怪的问题就排查完成了。还好,虽然排查的过程有点痛苦,但是还是从中学到了之前不知道的支持,比如dmesg -T 查看内核的输出信息。
3. 碎碎念
终于在十一前,挤出时间来整理了一下最近遇到有些奇怪的问题。希望这个十一能够玩的开心。
- 到底是什么伟大前程,值得我们把每个四季都错过?(ps:读的时候,心理酸酸的
- 人一旦有退路,无论是你愿意还是不愿意接受的退路,就不会用全力了。