本文是用自带的hbase import/export方法,由于原端不开放hdfs数据,并且因为底层存储不能打快照,目标端也不开放,所以只能通过这种方式。(这种方式比较耗性能)
建议从主库,搞一个备份库,再用这种导出备份库的数据
前提准备:
1.原端hbase集群,并且能够操作机访问
2.目标端hbase集群,并且能够操作机访问
3.操作机,一台ecs
模拟原端数据
bash
create_namespace 'test'
//创建一个名称为clark:test,列族名为cf的表
create 'test:user', 'cf'
// 插入数据。put 命名空间:表名,行键rowkey,列簇:字段名,值
put 'test:user','001','cf:name','clark'
put 'test:user','001','cf:age','28'
put 'test:user','002','cf:name','alice'
put 'test:user','002','cf:name','25'
//看一下数据
scan 'test:user'
全量迁移
1.看原表,表结构
bash
./hbase shell
list
#查看有哪些表
describe 'test:user'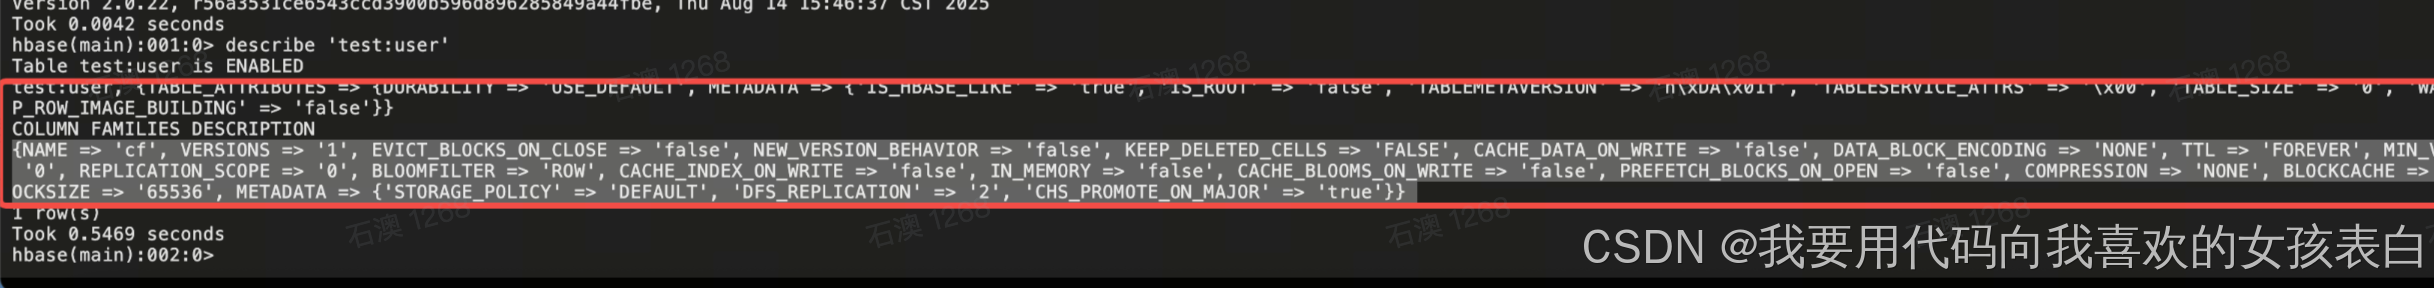
2.目标端建表
bash
./hbase shell
#先创建命名空间
create_namespace 'test'
#创建表,不要有换行,如果有多行压缩成一行,或者末尾加\
create 'test:user',{NAME => 'cf', VERSIONS => '1', EVICT_BLOCKS_ON_CLOSE => 'false',NEW_VERSION_BEHAVIOR => 'false', KEEP_DELETED_CELLS => 'FALSE', CACHE_DATA_ON_WRITE=> 'false', DATA_BLOCK_ENCODING => 'NONE', TTL => 'FOREVER', MIN_VERSIONS =>'0', REPLICATION_SCOPE => '0', BLOOMFILTER => 'ROW',CACHE_INDEX_ON_WRITE => 'false', IN_MEMORY => 'false', CACHE_BLOOMS_ON_WRITE =>'false', PREFETCH_BLOCKS_ON_OPEN => 'false', COMPRESSION => 'NONE', BLOCKCACHE =>'true', BLOCKSIZE => '65536', METADATA => {'STORAGE_POLICY' => 'DEFAULT','DFS_REPLICATION' => '2', 'CHS_PROMOTE_ON_MAJOR' => 'true'}}
3.原端导出数据
bash
./hbase org.apache.hadoop.hbase.mapreduce.Export test:user /tmp/hbase-export/test
ll /tmp/hbase-export/test
date +%s%3N
记录导出当前时间戳:1759118035736
4.目标端导入数据
bash
./hbase org.apache.hadoop.hbase.mapreduce.Import test:user /tmp/hbase-export/test/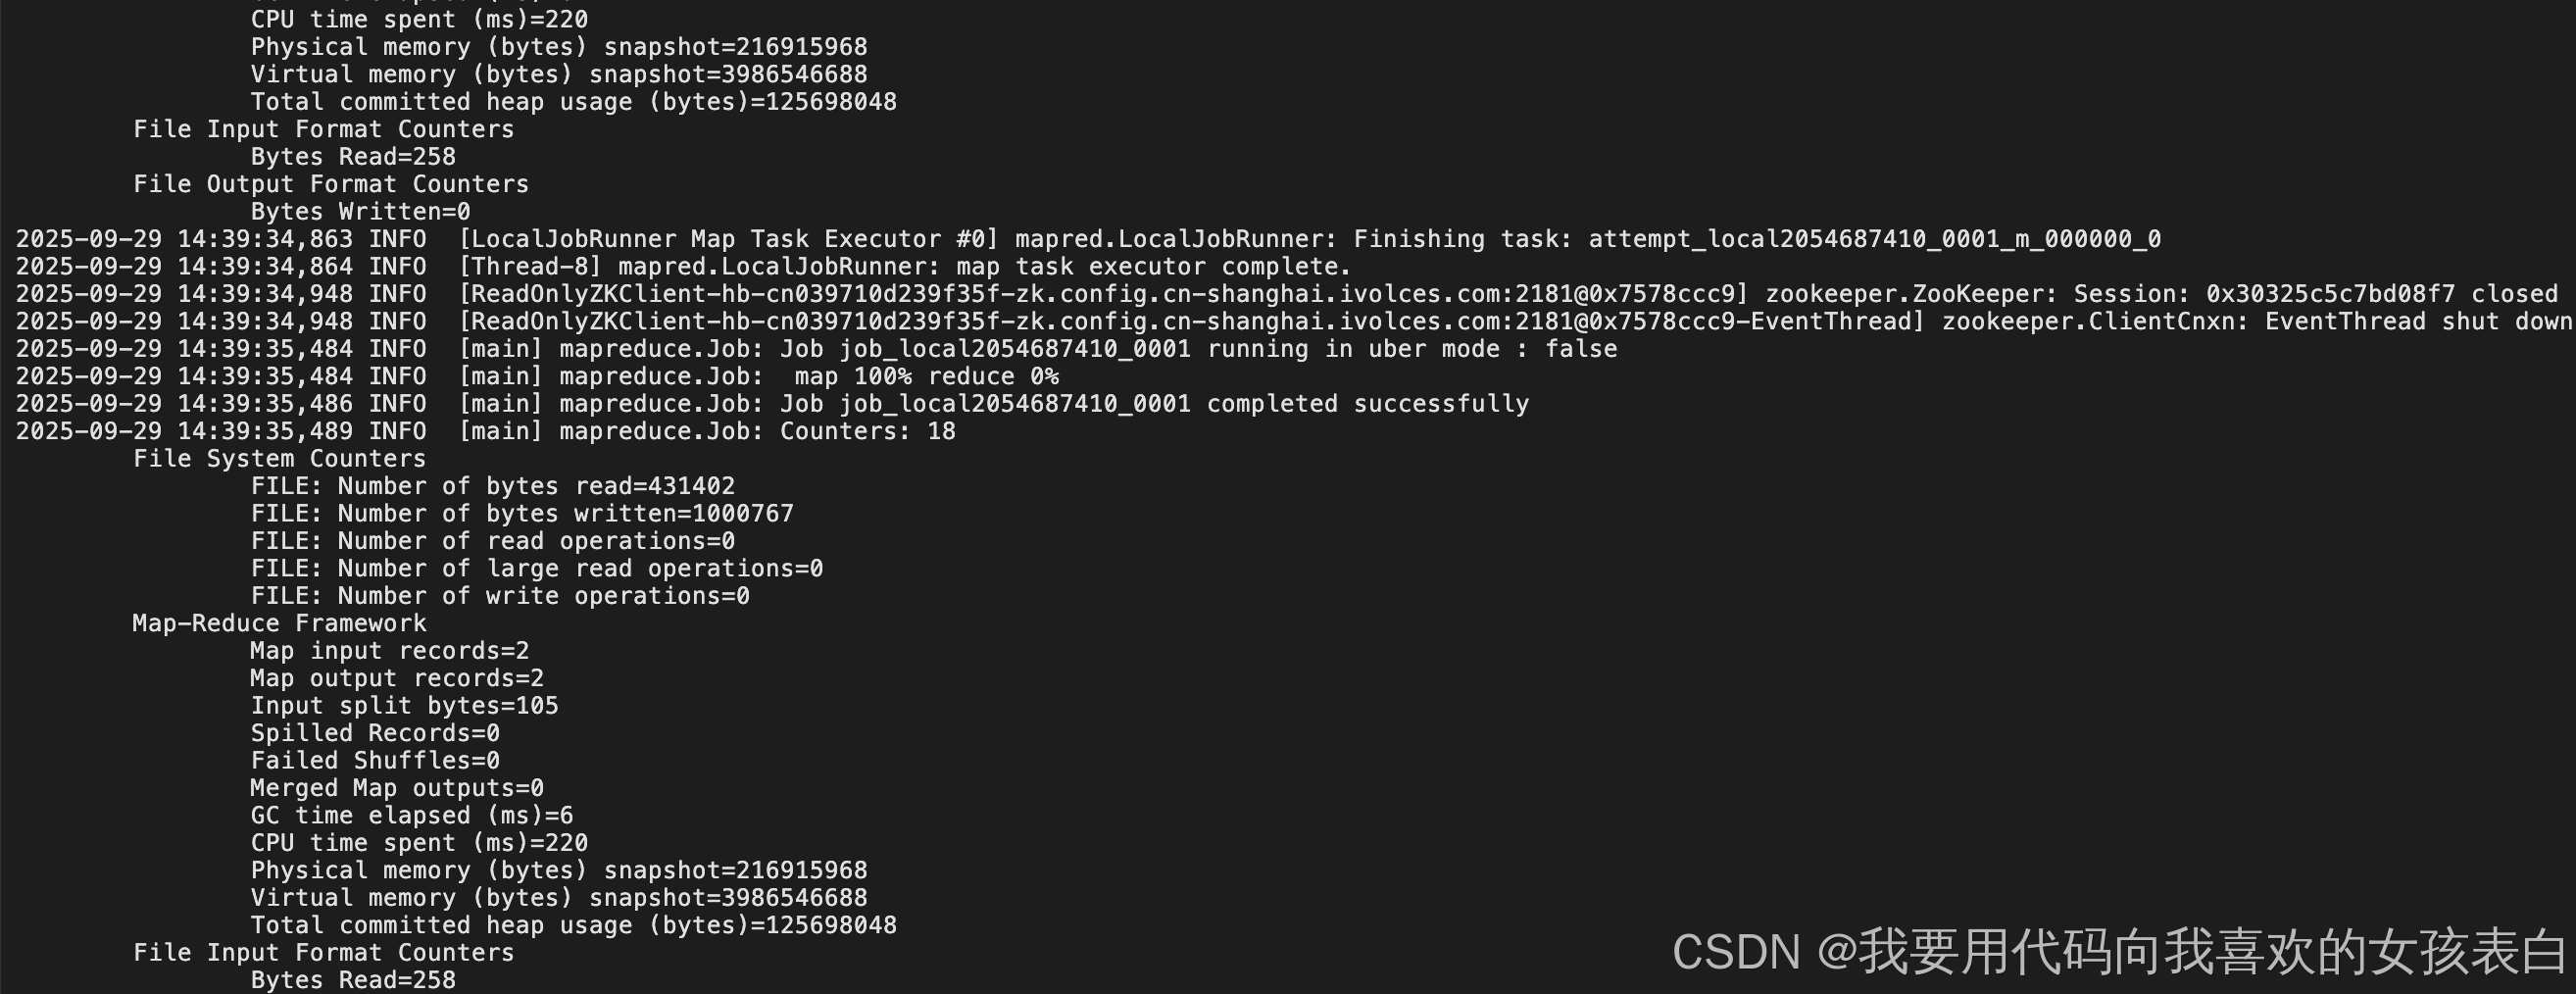
增量迁移
1. 在原端插入多条数据
bash
put 'test:user','003','cf:name','abc'
put 'test:user','001','cf:age','29'
2. 原端导出数据
先scan,查看原端的时间格式,发现是时间戳。
bash
./hbase -Dmapreduce.job.maps=10 org.apache.hadoop.hbase.mapreduce.Export test:user /tmp/incremental-export 1 1759118035736 1759131808806这4个分别代表,命名空间:表名 导出最近版本(1代表的是最新的版本)开始时间戳 结束时间戳(这个可以通过scan看到数据上的时间戳)
3. 目标端导入数据
目标端导入
bash
./hbase org.apache.hadoop.hbase.mapreduce.Import test:user /tmp/incremental-export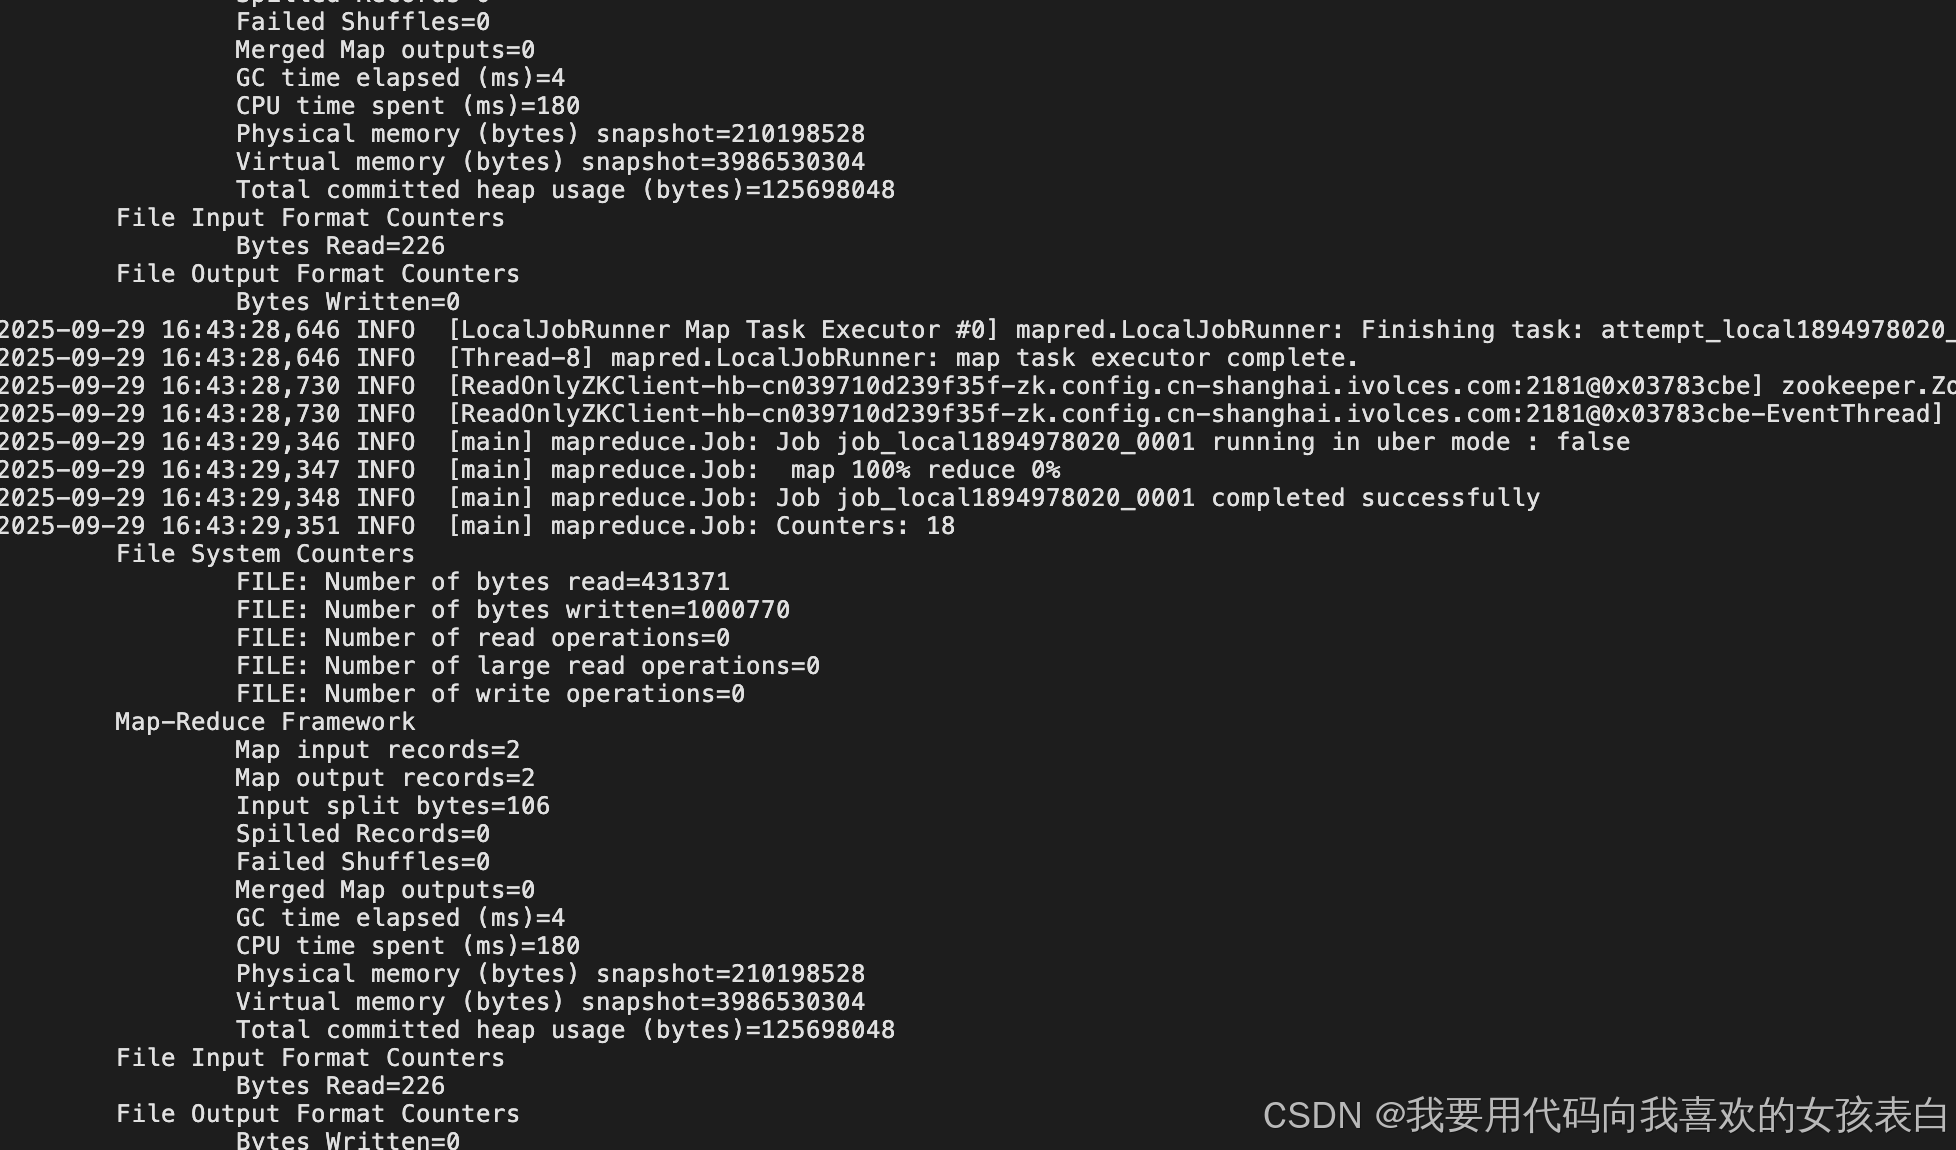
数据校验
先count对比行数,再抽样比对(由于版本不同并且没有开放hdfs数据,所以不能用md5sum)
bash
# 小表直接计数(注意:大表耗时较长)
count 'namespace:table_name'

# 大表推荐用MapReduce(效率更高)
hbase org.apache.hadoop.hbase.mapreduce.RowCounter 'namespace:table_name'