目录
[1.1 Transformer的诞生](#1.1 Transformer的诞生)
[1.2 Transformer的优势](#1.2 Transformer的优势)
[1.3 Transformer的市场](#1.3 Transformer的市场)
[2.1 Transformer模型的作用](#2.1 Transformer模型的作用)
[2.2 Transformer总体架构图](#2.2 Transformer总体架构图)
[2.2.1 Transformer总体架构](#2.2.1 Transformer总体架构)
[2.2.2 输入部分包含](#2.2.2 输入部分包含)
[2.2.3 输出部分包含](#2.2.3 输出部分包含)
[2.2.4 编码器部分包含](#2.2.4 编码器部分包含)
[2.2.5 解码器部分包含](#2.2.5 解码器部分包含)
一、Transformer的背景介绍
1.1 Transformer的诞生
2018年10月,Google发出一篇论文《BERT:Pre-training of Deep Bidirectional Transformers for Language Understanding》,BERT模型横空出世,并横扫NLP领域11项任务的最佳成绩!
论文地址:https://arxiv.org/pdf/1810.04805.pdf
而在BERT中发挥重要作用的结构就是Transformer,之后又相继出现XLNET,roBERT等模型击败了BERT,但是他们的核心没有变,仍然是Transformer。
1.2 Transformer的优势
相比之前占领市场的LSTM和GRU模型,Transformer有两个显著的优势:
1、Transformer能够利用分布式GPU进行并行训练,提升模型训练效率。
2、在分析预测更长的文本时,捕捉间隔较长的语义关联效果更好。
1.3 Transformer的市场
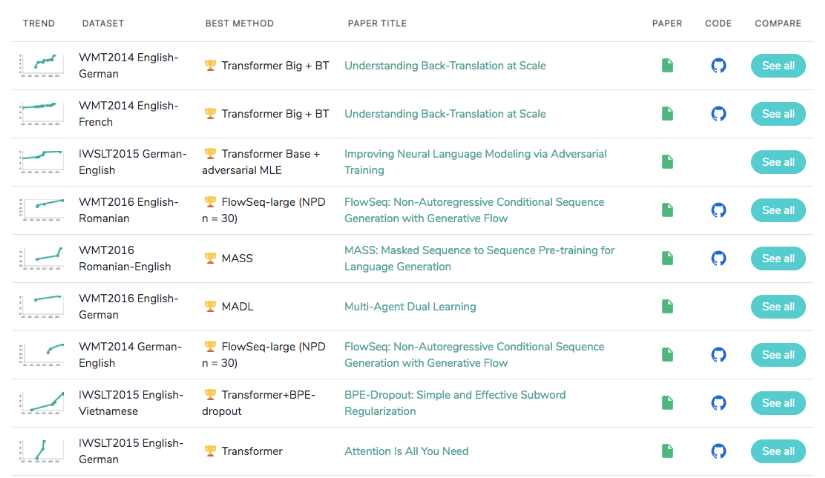
在著名的SOTA机器翻译榜单上, 几乎所有排名靠前的模型都使用Transformer,其基本上可以看作是工业界的风向标, 市场空间自然不必多说!
二、认识Transformer架构
2.1 Transformer模型的作用
基于seq2seq架构的transformer模型可以完成NLP领域研究的典型任务, 如机器翻译, 文本生成等. 同时又可以构建预训练语言模型,用于不同任务的迁移学习.
在接下来的架构分析中, 我们将假设使用Transformer模型架构处理从一种语言文本到另一种语言文本的翻译工作, 因此很多命名方式遵循NLP中的规则. 比如: Embeddding层将称作文本嵌入层, Embedding层产生的张量称为词嵌入张量, 它的最后一维将称作词向量等.
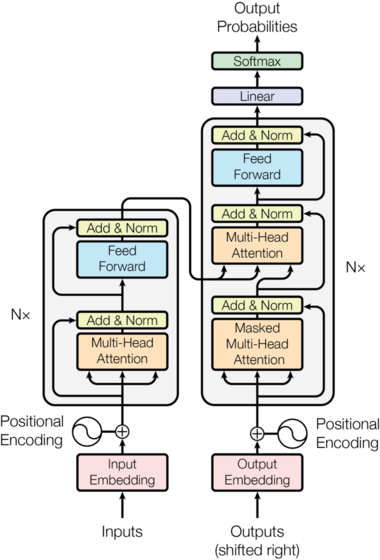
2.2 Transformer总体架构图
2.2.1 Transformer总体架构
输入部分
输出部分
编码器部分
解码器部分
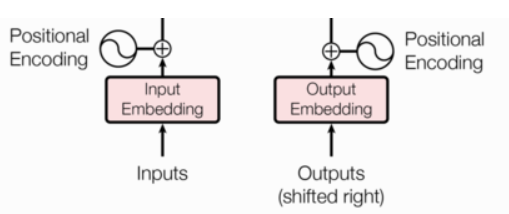
2.2.2 输入部分包含
源文本嵌入层及其位置编码器
目标文本嵌入层及其位置编码器
组成要素:
Word Embedding:将文本转换为词向量表示
Position Encoding:添加位置信息编码(因为Transformer没有RNN的天然顺序性)
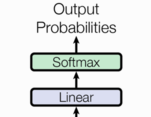
2.2.3 输出部分包含
线性层
softmax层
2.2.4 编码器部分包含
由N个编码器层堆叠而成
每个编码器层由两个子层连接结构组成
第一个子层连接结构包括一个多头自注意力子层和规范化层以及一个残差连接
第二个子层连接结构包括一个前馈全连接子层和规范化层以及一个残差连接
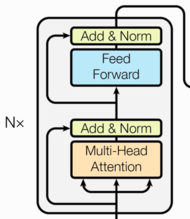
层级结构:
由6个相同编码器层堆叠(原始论文设定)
每个编码器层包含两个子层:
- 多头自注意力子层:
- 采用Q=K=V的自注意力机制
- 配合Add & Norm操作(残差连接+规范化)
- 前馈全连接子层:
- 包含两个全连接层
- 同样有Add & Norm操作
2.2.5 解码器部分包含
由N个解码器层堆叠而成
每个解码器层由三个子层连接结构组成
第一个子层连接结构包括一个多头自注意力子层和规范化层以及一个残差连接
第二个子层连接结构包括一个多头注意力子层和规范化层以及一个残差连接
第三个子层连接结构包括一个前馈全连接子层和规范化层以及一个残差连接
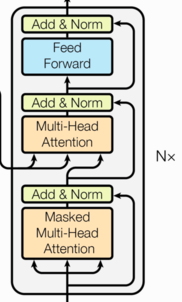
层级结构:
同样由6个解码器层堆叠
每个解码器层包含三个子层:
- 掩码多头自注意力子层:
- 带掩码的自注意力机制(防止信息泄露)
- 多头注意力子层:
- 接收编码器输出的K和V
- 使用解码器自身的Q
- 前馈全连接子层:
- 结构与编码器相同
关键区别:相比编码器多一个注意力子层,用于处理编码器输出信息
