在一张看似普通的财务报表或一份陈年的医疗档案面前,人眼能瞬间捕捉标题、区分栏目、理解数字间的归属关系。然而,对于机器而言,这张页面却曾是一个令人望而生畏的"视觉迷宫":这里没有清晰的路径,只有散落的文本方块;没有明确的边界,只有靠微妙对齐关系维持的秩序。其中最为核心、信息密度最高的区域,便是那些排版复杂的表格。
它们或许没有边框,依靠纯粹的空间诗意来组织信息;或许充满了跨行跨列的合并单元格,如同建筑中的挑高厅堂,打破了标准的网格逻辑;它们甚至可能内部嵌套着另一个表格,或与段落、图片、印章紧紧相邻。如何教会机器像人类一样,看穿这片混沌,精准地还原出表格的结构与内容,不仅是技术上的挑战,更是一场关于机器"理解力"的进化。
本文将深入探讨现代表格识别技术是如何一步步"理解"、"分割"并"重建"这些复杂排版的表格,最终实现信息的自动化提取。
挑战:从规则网格到"视觉迷宫"
与传统的规则线框表相比,复杂排版表格主要带来以下几大挑战:
- 视觉线索的缺失:大量表格依赖简单的空格、缩进进行排版,没有明确的边框线。机器需要从看似杂乱的文本行中推断出潜在的表格结构。
- 结构的多变性:合并单元格、嵌套表(表格内还有表格)、倾斜的表头等,彻底打破了简单的网格逻辑。
- 内容的异构性:一个单元格内可能包含多行文本、公式、图表或代码,不再是简单的数字或短文本。
- 上下文的干扰:表格与页面上的纯文本、图片、印章等元素紧密相邻,机器需要准确地将表格区域与非表格区域分离开来。
破局:三步走战略------定位、解析与重建
征服这座"迷宫",现代表格识别技术通常遵循一个精密的"三步走"战略。
第一步:表格检测------发现"迷宫"入口
首先,系统需要回答一个基本问题:"表格在哪里?"。
- 现代利器------深度学习模型:基于深度学习的目标检测模型(如YOLO、DETR)已成为此阶段的主力。它们通过在数百万文档图像上学习,练就了一双"火眼金睛",能够无视具体的边框线,仅凭文本的宏观布局和视觉特征,就直接在页面中定位出表格的精确坐标,如同在卫星照片上快速圈出城市轮廓。
第二步:结构识别------绘制"迷宫"地图
这是整个流程的灵魂所在。目标不仅是找到单元格,更是要理清它们之间的逻辑从属关系。
1.多模态融合---文本与视觉的协奏:前沿技术不再单独分析图像或文本,而是采用多模态融合策略。系统会同时处理两类信息:
- 视觉信息:页面的原始像素特征。
- 文本信息:通过OCR引擎识别出的所有文字及其精确的坐标和边界框。
2.通过分析这些文本块之间的对齐关系(如左对齐、顶端对齐)和相对位置,模型能够推理出无形的行与列。例如,当它发现一列文本块的左边缘完美地对齐在一条垂直线上时,它就"看见"了一列。当一个文本块的宽度覆盖了多个标准列宽时,系统便将其识别为一个"列合并单元格"。
第三步:内容提取与重建------输出数字蓝图
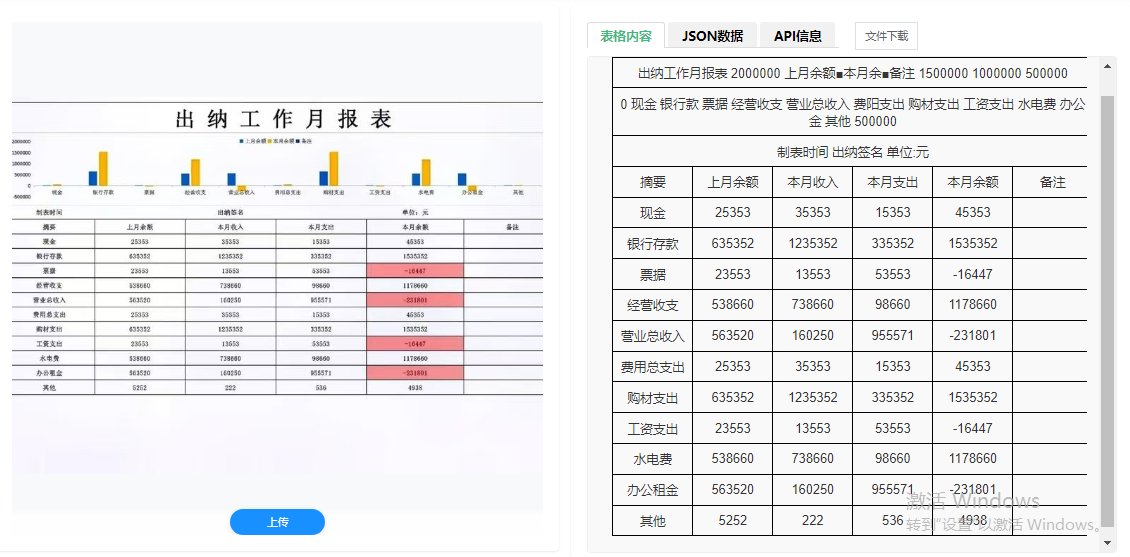
在理清结构之后,表格识别系统需要将OCR识别出的文本"对号入座",填入对应的单元格中,并最终输出为可计算的结构化数据。
- 智能关联:根据文本框与预测出的单元格区域的重叠关系,将文字内容正确地关联到每个格子中,并能智能处理单元格内的换行和多段落文本。
- 结构化输出:最终,整个表格被重建为带有colspan(列合并)和rowspan(行合并)属性的HTML代码,或是结构化的CSV/JSON文件。这不仅还原了表格的视觉面貌,更彻底捕获了其内在的逻辑骨架。
实际应用与未来展望
表格识别技术已广泛应用于:
- 金融与审计:自动化处理银行流水、财务报表,提升效率和准确性。
- 医疗健康:从结构复杂的化验单、诊断报告中提取关键指标。
- 学术研究:从海量论文中批量提取实验数据,进行元分析。
- 政务数字化:将历史档案、申报文件中的表格信息快速入库。
未来的挑战与方向:
- 更高精度:对于极端复杂、模糊或扭曲的文档,仍需提升鲁棒性。
- 少样本/零样本学习:让模型在少量甚至没有标注数据的新类型表格上也能良好工作。
- 逻辑结构理解:不仅识别物理结构,还能理解表头层级、单元格的逻辑归属(如"备注"单元格属于哪一行)。
- 多模态问答:直接根据表格图像回答用户提出的复杂问题,实现真正的"认知"层面理解。
从布满数字与线条的混乱版式中,精准地抽离出逻辑井然的表格结构,现代表格识别技术正是一场从"视觉感知"到"语义理解"的深度穿越。它不仅是模式识别的胜利,更是多模态人工智能协同工作的典范。随着技术的不断成熟,表格识别技术将进一步打破纸质与数字、非结构化与结构化数据之间的壁垒,成为驱动各行各业智能化升级的关键力量。