简单使用Marker
1 简单介绍
Marker是由Datalab维护的开源项目,它利用了surya的模型进行做的,能够快速准确地将文档转换为Markdown、JSON、分块数据及HTML格式。相对MinerU和Docling文件解析的效果较差,但是解析的速度是较快的,如果考虑速度和性能,可以考虑这个模型。不好的地方除了github没有官方本地部署较完整的文档。
Datalab也维护了Surya,Surya是一款文档OCR工具包,功能包括:支持90多种语言的OCR技术、任意语言的行级文本检测
版面分析(表格、图像、标题等检测)、阅读顺序检测、表格识别(检测行/列)、LaTeX OCR(数学公式)。
# Github地址(没有标准的开发文档)
https://github.com/datalab-to/marker

# Surya的Github地址
https://github.com/datalab-to/surya
2 安装环境
安装依赖环境
pip install marker-pdf[full] -i https://pypi.tuna.tsinghua.edu.cn/simple简单例子
注意:Windows中模型的默认下载路径是"C:\Users\Admin\AppData\Local\datalab",Admin是我的用户名,此处对应你的用户名。模型大小:4.97G。
# 注意!! 解析的过程不支持多线程和多协程
from marker.converters.pdf import PdfConverter
from marker.models import create_model_dict
from marker.output import text_from_rendered


def test():
    print(create_model_dict())
    converter = PdfConverter(
        artifact_dict=create_model_dict()
    )

    # 解析图片
    rendered = converter("E:/temp/test.png")
    text, _, images = text_from_rendered(rendered)
    print(text, _, images)

    # 解析pdf
    rendered = converter("E:/test/test1.pdf")
    text, _, images = text_from_rendered(rendered)
    print(text, _, images)

    # 解析docx
    rendered = converter("E:/test/test2.docx")
    text, _, images = text_from_rendered(rendered)
    print(text, _, images)


if __name__ == '__main__':
    test()
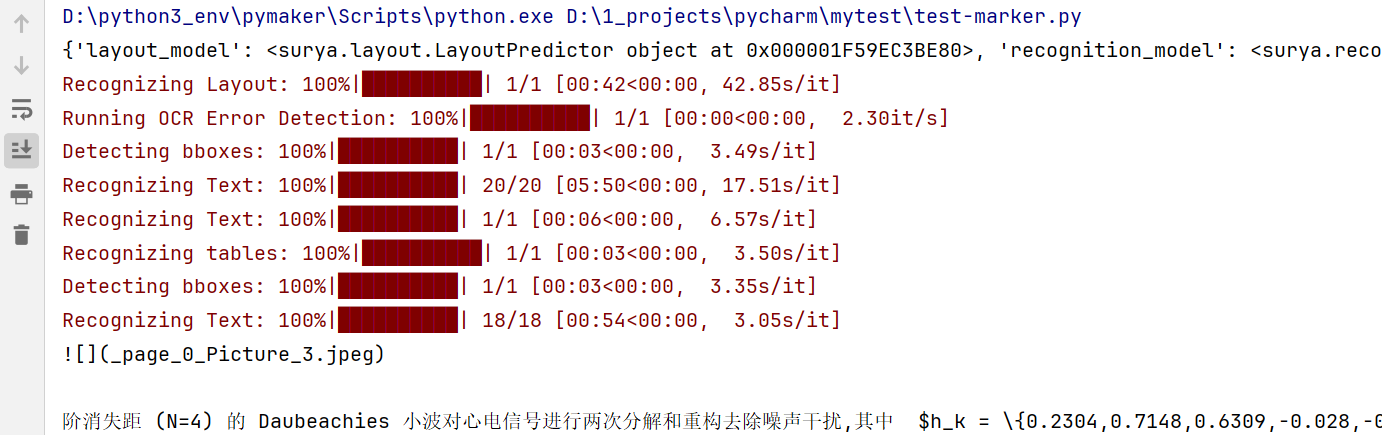
截图